


309
社区成员
 发帖
 与我相关
 我的任务

 分享
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| DoubleIndex.DoubleIndex(Poly, BigInteger, BigInteger) | 0.0 | 1.0 | 1.0 | 1.0 |
| DoubleIndex.equals(Object) | 5.0 | 6.0 | 1.0 | 6.0 |
| DoubleIndex.getExpIndex() | 0.0 | 1.0 | 1.0 | 1.0 |
| DoubleIndex.getXIndex() | 0.0 | 1.0 | 1.0 | 1.0 |
| DoubleIndex.getYIndex() | 0.0 | 1.0 | 1.0 | 1.0 |
| DoubleIndex.hashCode() | 0.0 | 1.0 | 1.0 | 1.0 |
| DoubleIndex.plus(DoubleIndex, DoubleIndex) | 0.0 | 1.0 | 1.0 | 1.0 |
| DxFactor.DxFactor(Expr) | 0.0 | 1.0 | 1.0 | 1.0 |
| DxFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| DyFactor.DyFactor(Expr) | 0.0 | 1.0 | 1.0 | 1.0 |
| DyFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpFactor.ExpFactor(Factor, BigInteger) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExpFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| Expr.addTerm(Term) | 0.0 | 1.0 | 1.0 | 1.0 |
| Expr.clone(Expr) | 0.0 | 1.0 | 1.0 | 1.0 |
| Expr.Expr() | 0.0 | 1.0 | 1.0 | 1.0 |
| Expr.exprToPoly() | 1.0 | 1.0 | 2.0 | 2.0 |
| ExprFactor.changeIndexTo(BigInteger) | 0.0 | 1.0 | 1.0 | 1.0 |
| ExprFactor.ExprFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| ExprFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| FuncFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| FuncFactor.FuncFactor(Factor) | 0.0 | 1.0 | 1.0 | 1.0 |
| Function.Function() | 0.0 | 1.0 | 1.0 | 1.0 |
| Function.getInstance() | 0.0 | 1.0 | 1.0 | 1.0 |
| Function.init(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| Function.toPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| GradFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| GradFactor.GradFactor(Expr) | 0.0 | 1.0 | 1.0 | 1.0 |
| Lexer.getNumber() | 2.0 | 1.0 | 3.0 | 3.0 |
| Lexer.Lexer(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| Lexer.next() | 6.0 | 2.0 | 5.0 | 6.0 |
| Lexer.next(int) | 1.0 | 1.0 | 2.0 | 2.0 |
| Lexer.peek() | 0.0 | 1.0 | 1.0 | 1.0 |
| MainClass.getInput(Scanner) | 0.0 | 1.0 | 1.0 | 1.0 |
| MainClass.main(String[]) | 2.0 | 1.0 | 3.0 | 3.0 |
| NumFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| NumFactor.NumFactor(BigInteger) | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.getIndex() | 3.0 | 1.0 | 3.0 | 3.0 |
| Parser.getSign() | 3.0 | 1.0 | 2.0 | 3.0 |
| Parser.isPlusOrMinus(String) | 1.0 | 1.0 | 2.0 | 2.0 |
| Parser.parseDxFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseDyFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseExpFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseExpr() | 1.0 | 1.0 | 2.0 | 2.0 |
| Parser.parseExprFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseFactor() | 5.0 | 11.0 | 11.0 | 12.0 |
| Parser.parseFuncFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseGradFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseNumFactor() | 4.0 | 1.0 | 3.0 | 4.0 |
| Parser.parseOptionalFactor() | 2.0 | 2.0 | 1.0 | 2.0 |
| Parser.Parser(Lexer) | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseRecFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseTerm() | 4.0 | 1.0 | 4.0 | 4.0 |
| Parser.parseXFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Parser.parseYFactor() | 0.0 | 1.0 | 1.0 | 1.0 |
| Poly.bestExp(Poly) | 1.0 | 2.0 | 1.0 | 2.0 |
| Poly.devide(BigInteger) | 1.0 | 1.0 | 2.0 | 2.0 |
| Poly.dx() | 3.0 | 1.0 | 3.0 | 3.0 |
| Poly.dy() | 3.0 | 1.0 | 3.0 | 3.0 |
| Poly.equals(Object) | 2.0 | 3.0 | 1.0 | 3.0 |
| Poly.expVersion1(Poly) | 2.0 | 1.0 | 3.0 | 3.0 |
| Poly.expVersion2(Poly) | 2.0 | 1.0 | 3.0 | 3.0 |
| Poly.getGcd() | 1.0 | 1.0 | 2.0 | 2.0 |
| Poly.grad() | 0.0 | 1.0 | 1.0 | 1.0 |
| Poly.hashCode() | 0.0 | 1.0 | 1.0 | 1.0 |
| Poly.isFactor() | 6.0 | 3.0 | 1.0 | 7.0 |
| Poly.monoToString(DoubleIndex, BigInteger) | 28.0 | 1.0 | 11.0 | 14.0 |
| Poly.mul(Poly, Poly) | 9.0 | 1.0 | 5.0 | 5.0 |
| Poly.plus(Poly, Poly) | 10.0 | 1.0 | 6.0 | 6.0 |
| Poly.Poly(DoubleIndex, BigInteger) | 1.0 | 1.0 | 2.0 | 2.0 |
| Poly.pow(Poly, BigInteger) | 5.0 | 3.0 | 3.0 | 4.0 |
| Poly.replace(Poly) | 1.0 | 1.0 | 2.0 | 2.0 |
| Poly.toString() | 9.0 | 6.0 | 4.0 | 7.0 |
| RecFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| RecFactor.RecFactor(int, Factor) | 0.0 | 1.0 | 1.0 | 1.0 |
| Recursion.add(String) | 0.0 | 1.0 | 1.0 | 1.0 |
| Recursion.addRule(String) | 1.0 | 1.0 | 2.0 | 2.0 |
| Recursion.get(int) | 0.0 | 1.0 | 1.0 | 1.0 |
| Recursion.getInstance() | 0.0 | 1.0 | 1.0 | 1.0 |
| Recursion.Recursion() | 0.0 | 1.0 | 1.0 | 1.0 |
| Term.addFactor(Factor) | 0.0 | 1.0 | 1.0 | 1.0 |
| Term.Term() | 0.0 | 1.0 | 1.0 | 1.0 |
| Term.termToPoly() | 1.0 | 1.0 | 2.0 | 2.0 |
| XFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| XFactor.XFactor(BigInteger) | 0.0 | 1.0 | 1.0 | 1.0 |
| YFactor.factorToPoly() | 0.0 | 1.0 | 1.0 | 1.0 |
| YFactor.YFactor(BigInteger) | 0.0 | 1.0 | 1.0 | 1.0 |
| Total | 126.0 | 116.0 | 155.0 | 181.0 |
| Average | 1.4482758620689655 | 1.3333333333333333 | 1.7816091954022988 | 2.0804597701149423 |
平均圈复杂度(v(G)):2.08,处于较低水平,表明大部分方法控制流简单,易于测试。平均认知复杂度(CogC):1.45,同样较低,说明大多数方法直观易懂。但存在少数高复杂度方法,显著拉高了平均值。
大多数方法 iv(G) ≈ v(G),表明模块间调用复杂度和方法自身控制流复杂度基本一致,没有明显的过度耦合。
Poly.monoToString 的 iv(G)=11 而 ev(G)=1,说明该方法内部有大量分支但结构清晰(非结构化程度低),认知复杂度高主要源于分支数量而非结构混乱,将其拆分为多个小方法可能会比较好。Poly 类:多个方法复杂度较高(mul、plus、toString、monoToString、isFactor),说明 Poly 可能存在职责过重。Parser.parseFactor 圈复杂度过高,分支过多,可以考虑应用工厂模式或策略模式。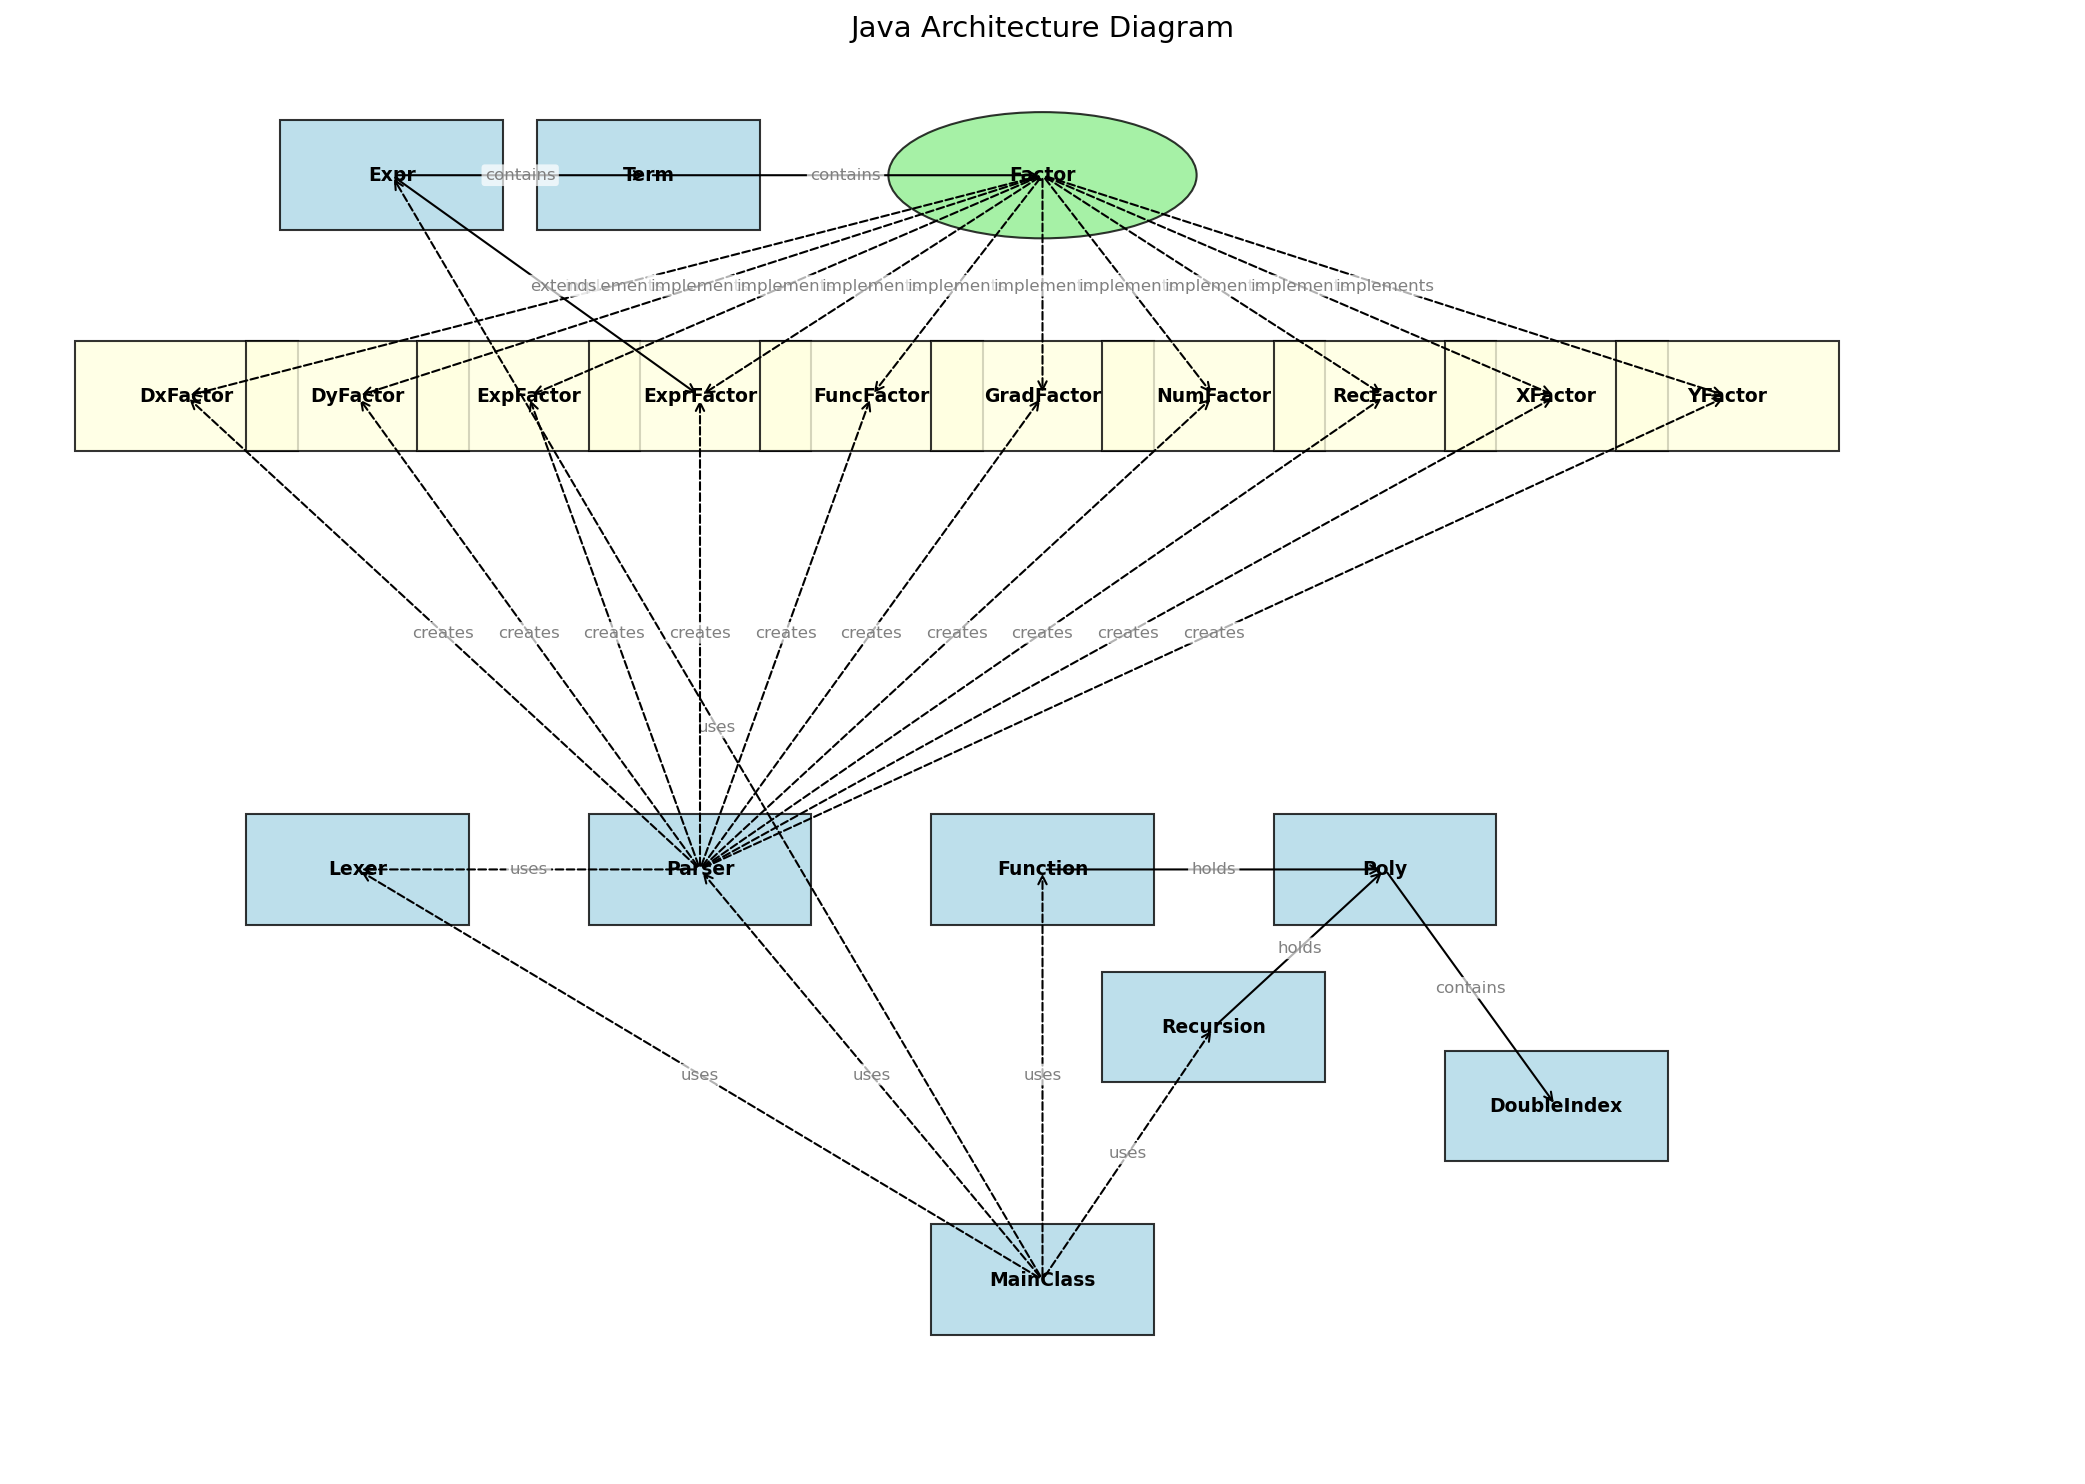
MainClass:处理输入,调用Parser和Lexer,尽量避免在MainClass里塞太多东西。Lexer:词法分析,拆出Token。Parser:语法分析,递归下降解析表达式、项、因子。Expr:表达式,管理下一层的项。Term:项,管理下一层的因子。Factor:因子接口,使各种因子能被统一管理、统一转为多项式。ExprFactor:表达式因子,继承了Expr,搭载了Factor接口,并记录指数。XFactor/YFactor:幂函数因子,记录指数。ExpFactor:指数函数因子,记录其内因子指数和外常熟指数。Function:用单例模式管理初始化形参下的非递推函数的多项式。FuncFactor:非递推函数因子,记录实参因子,toPoly时调用Function完成替换。Recursion:用单例模式初始化并管理0-5这六个递推函数。RecFactor:递推函数因子,记录序号和实参因子,toPoly时调用Recursion完成替换。DxFactor/DyFactor/GradFactor:求导因子,记录被求导的表达式。NumFactor:常数因子。DoubleIndex:将x的指数、y的指数、exp的指数统合在一起。Poly:将多项式的每一项以<DoubleIndex, coef>的键值对形式用HashMap管理,提供多项式加法、多项式减法、多项式乘法、多项式快速幂、多项式求导、多项式化字符串等方法。Factor 接口统一了各类因子,使表达式构建和多项式转换能够以一致的方式处理,便于后续扩展新的因子类型。Poly 类将多项式表示为 HashMap<DoubleIndex, BigInteger>,封装了加、乘、幂、求导、替换等运算,使得符号计算的核心逻辑集中且可复用。Lexer 负责词法分析,Parser 负责语法分析,职责清晰,为复杂表达式提供了可维护的解析机制。Function 和 Recursion 采用单例模式,保证全局只有一个函数定义和递归定义集合,符合“整个程序只有一组函数定义和递归规则”的情况。Poly.mul 和 Poly.plus 每次运算都创建新的 HashMap,且频繁进行 equals 和 containsKey 判断,时间复杂度高。DoubleIndex 中包含一个 Poly expIndex,形成了“指数中的多项式”的嵌套结构,导致多项式的表示极度复杂。这种设计使得求导、替换、字符串输出等操作都需要递归处理,极易引入 bug,且难以调试。Parser 直接依赖所有具体的 Factor 实现类,并显式调用其构造函数。可以考虑通过工厂模式或反射来降低耦合。DxFactor、DyFactor、GradFactor 的结构几乎完全相同。没有重构。刚开始的时候想过要不要把每个返回值都变成多项式的形式,这样就能少开几个类。最后还是决定老老实实那类暂存,最后再转为多项式,因为担心会加其他操作。这个架构虽然麻烦不少,但拓展起来还是没让我有什么负担。基本只要增加Factor旗下的因子种类就行,不需要对已有的内容作很大变动。不过还是有些地方写的不够精致,实现得比较偷懒,导致不得不修改。
Lexer分析词法,Parser分析语法,将原式递归下降地剖分成表达式、项、因子。出于单一职责原理,我将分析与计算分开,设计Poly类承担计算、输出的职责,为表达式、项、因子设计toPoly方法。<指数,系数>的形式,与原来的表示方法统一,避免对Poly类进行太大的变动。选择式因子和自定义函数因子只需要增加新的类即可,但是偷懒用字符串替换处理自定义函数因子,没有将分析与计算彻底分离,在互测中吃了苦头。Bug修复时在Poly类中新增了replace方法,将实参替换的步骤后移。Poly类中增加求导方法即可,因为多项式的格式统一,所以很好实现。对于后者,我突发奇想地将自定义函数因子用单例模式来处理,这样就能避免冗余的传参。增加sin, cos函数因子。
在我的最终设计中,多项式结构再次被颠覆。考虑将单项式表示成$ax^bexp(c)*\Pi_isin(poly_i)^{biginteger_i}*\Pi_jcos(poly_j)^{biginteger_j}$的形式,用HashMap<Poly, BigInteger>来代表三角函数部分,合并到(b,c)中共同构成单项式的键。然后需要修改多项式乘法、多项式化字符串等方法。
[(exp(0) == 0)? [(exp((x+exp(x))) == exp((exp(x) + x))) ?2:009] : -1],我的程序输出为1原因:第一次作业中我将正负号视为+1, -1因子,在parseTerm阶段处理了所有的正负号,因为parseFactor只会被parseTerm调用,所以parseFactor不需要处理正负号。但第二次作业中指数因子、函数因子都会越过parseTerm直接调用parseFactor,所以负号没被处理。位置:Parser类的parseFactor方法对策:在parseFactor中的parseNumFactor处增加了判断符号的功能。注意因子中只有常数因子可能带符号,且最多一个符号。exp(((9+x)*(9+y)*(9+x^2)*(9+y^2)*(9+x^4)*(9+y^4)*(9+x^8)*(9+y^8)*(9+exp(x)+exp(y))*(9+exp(x^2))))让我的程序超时。原因:Poly类中pow方法中的快速幂实现得不够精细,快速幂中当指数归为0时应该及时退出,而不是再执行一次多余的a=a*a,如果执行了,将会导致a比最终的ans大,就可能出现ans堪堪合法而最终的a过大的情况。位置:Poly类的pow方法对策:b右移到0时及时退出。Parser类的parseFactor方法对策:将字符串替换改为先用类存储信息,最后再进行多项式替换。很多问题出现在了Parser类的parseFactor方法和Poly类中。parseFactor的ev, iv, v值均很高,表明这个方法的复杂度、耦合度过高。Poly类的OC, WMC较高。这表明圈复杂度过高的部分可能更加容易发生错误,因为逻辑复杂度过高会让编写和检查变得困难。
黑箱测试:分别用自己构造的边界数据和评测机进行测试。评测机效果一般,边界数据效果很好,上一次作业中被别人hack的数据也可以借来用在本次互测里,毕竟很多bug出现率很高。
白箱测试:检查代码具体内容,尤其是一些关键的类和方法。
提取出exp内多项式各项系数的gcd到exp()外作为指数,与不加优化的版本比较后择优。
这种情况因为可能使同一个多项式实例被多次调用toString()方法,所以用记忆化搜索来优化了时间复杂度。
本来想以最大质因子来对系数进行分组,但是最大质因子不好计算,遂作罢。
我觉得过于在意性能分可能会把代码搞得很复杂,影响正确性和效率。
第二次作业开始,我将多项式的每一项表示为a*x^b*exp(c)的形式,并以键值对<(b, c), a>的形式用HashMap管理。(b, c)的部分我新开了一个类进行管理,这就需要对这个类进行哈希化,于是我询问了LLM自定义类的哈希应该如何实现,效果不错。
因为对正则表达式不够熟练,所以涉及字符串替换的部分也大多让LLM来写的。
此外,还让大模型来分析并检查互测代码、生成评测机,大模型展现出了笨拙的一面,但还是提供了不少帮助。比如说他虽然因为总是搞错题目限制而在找bug上帮不上什么忙,但是在分析程序架构和简单的搜索生成任务上表现得不错。
没感觉到有完完全全是AI生成的代码。
一开始抵触互测,现在觉得互测还是挺有趣且有益的。我在强测中几乎没有出错,也就是说如果没有互测的集思广益,那么我代码中的bug可能就永不见天日了。
阅读别人的代码也不只是挑刺,我学习到了很多优美的写法,在迭代中用到了自己的代码里。
选择式因子这种小巧思的设计我挺喜欢的,希望之后能多多设计出这样精巧的规则。

