309
社区成员
 发帖
 与我相关
 我的任务

 分享
首先来看类图,并简单介绍我的程序架构:
(红色箭头表示包含,即前类的属性包含后类的实例,黑色箭头表示继承)
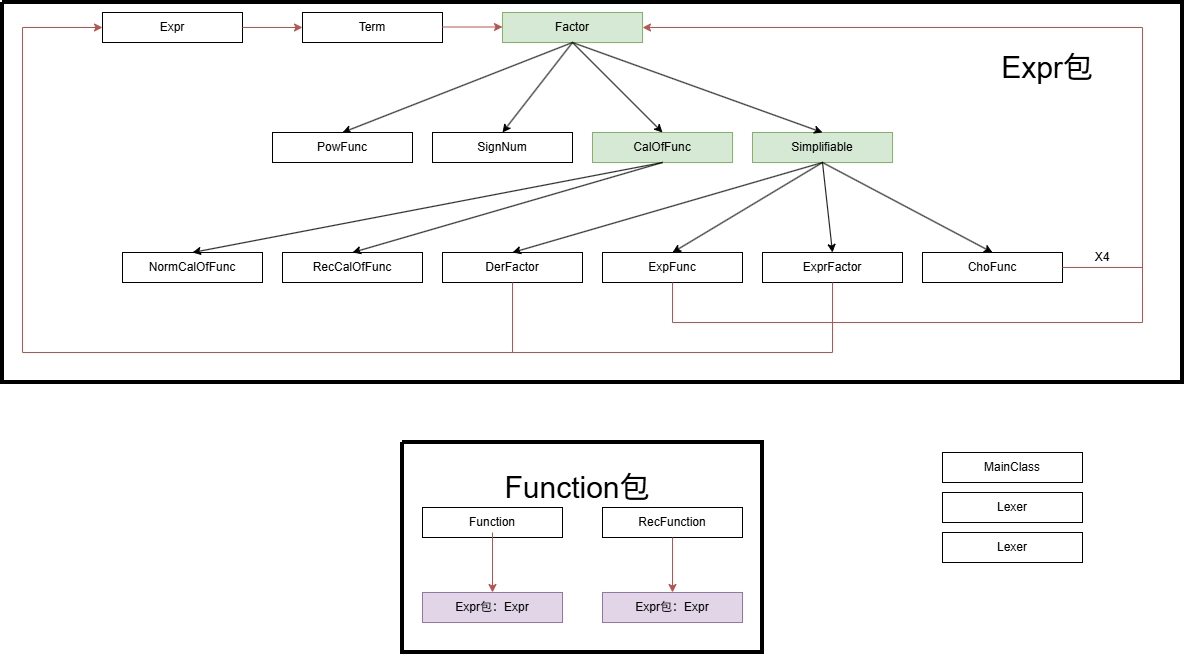
作为一个想法不多的人,我几乎是照搬了指导书的内容,来设计程序的架构,以各种各样的因子作为基础元素,继承了Factor类。唯一称得上原创的是CalOfFunc接口——用于对函数调用进行统一的替换——以及Simplifiable接口,指示这个Factor还可以包含其它Factor,存在简化空间。
然后因子相乘组成Term,Term相加组成Expr。
为了更好的处理函数调用,我创建了Function类。然后是文法处理的Lexer与Parser,以及主类MainClass。架构的更多细节会在下一节讨论。
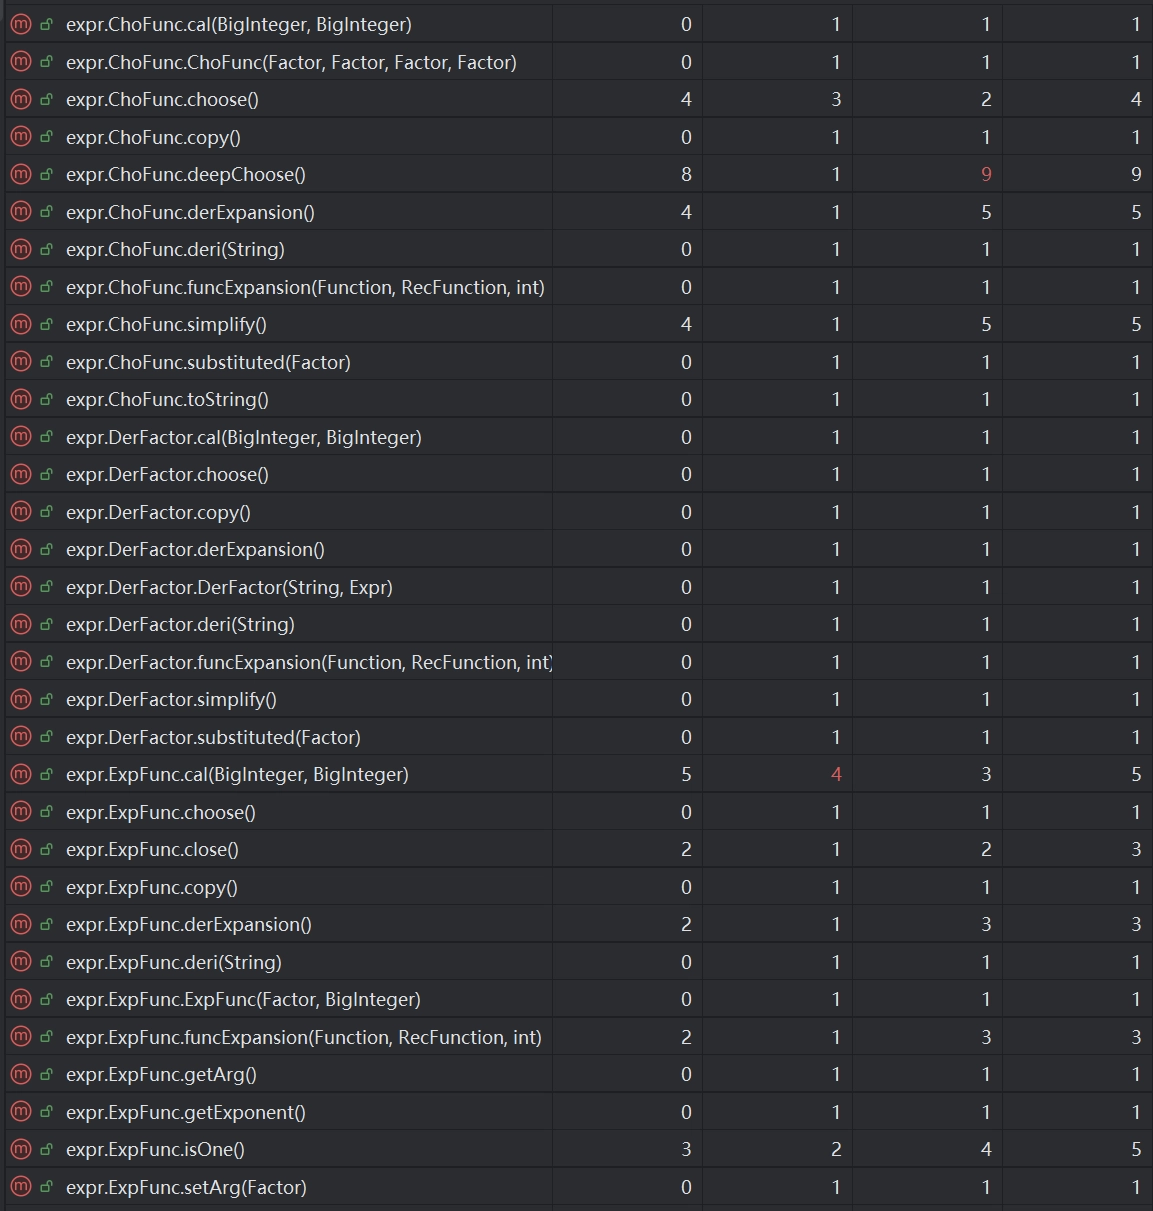
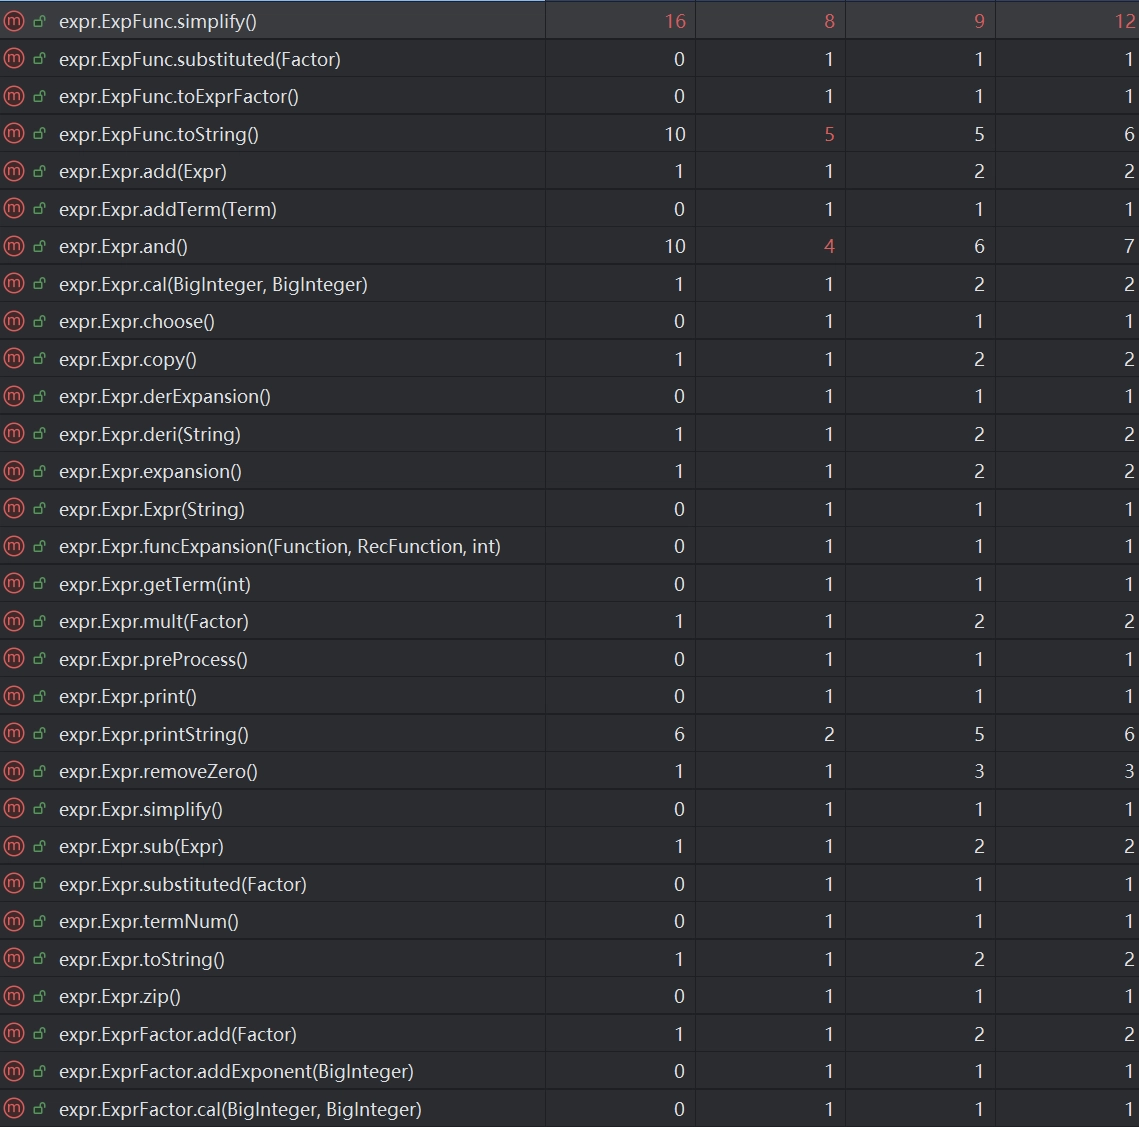
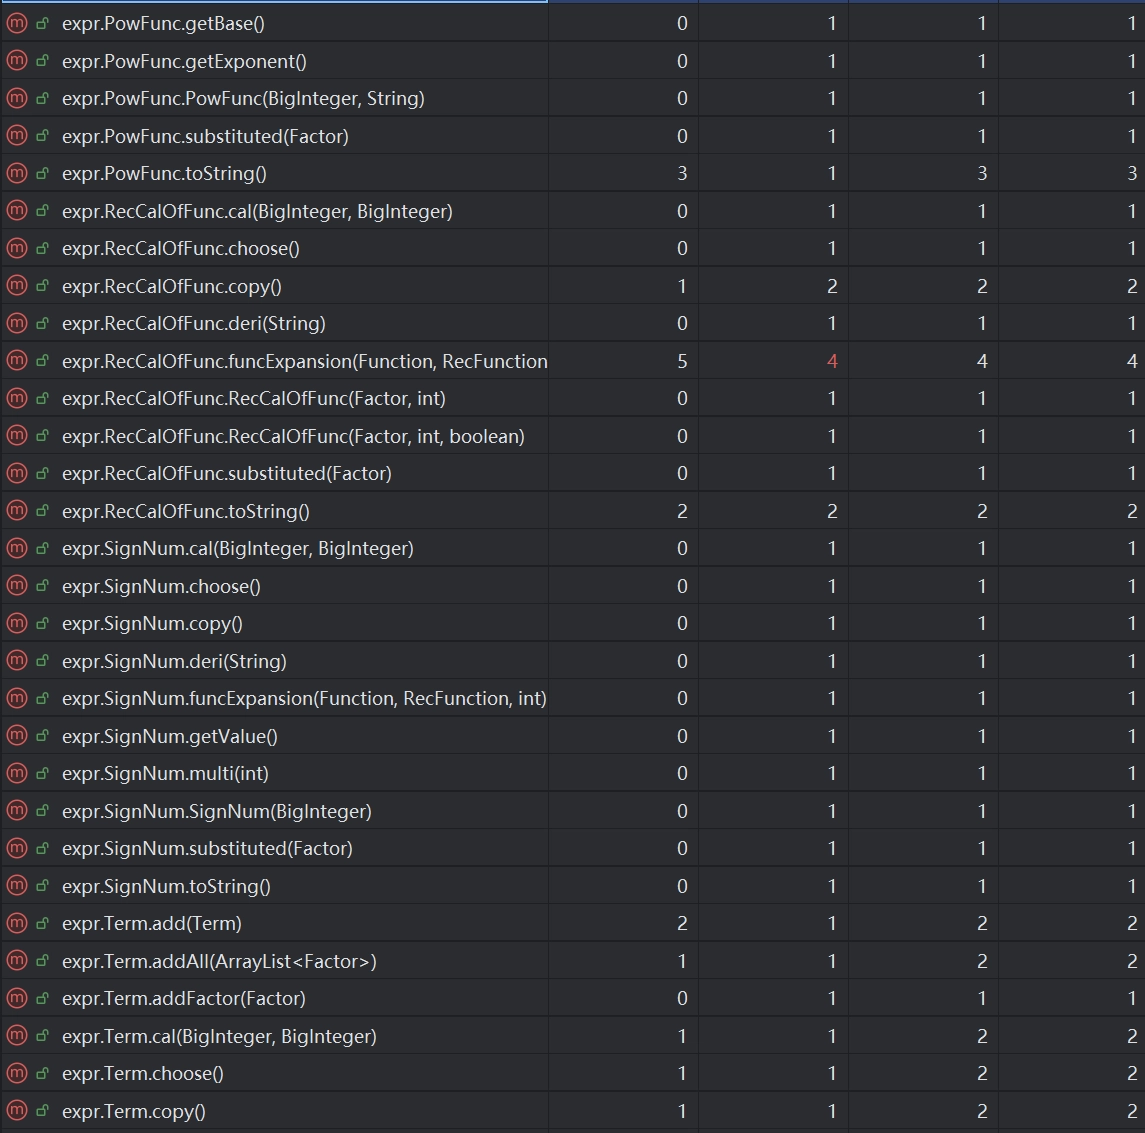
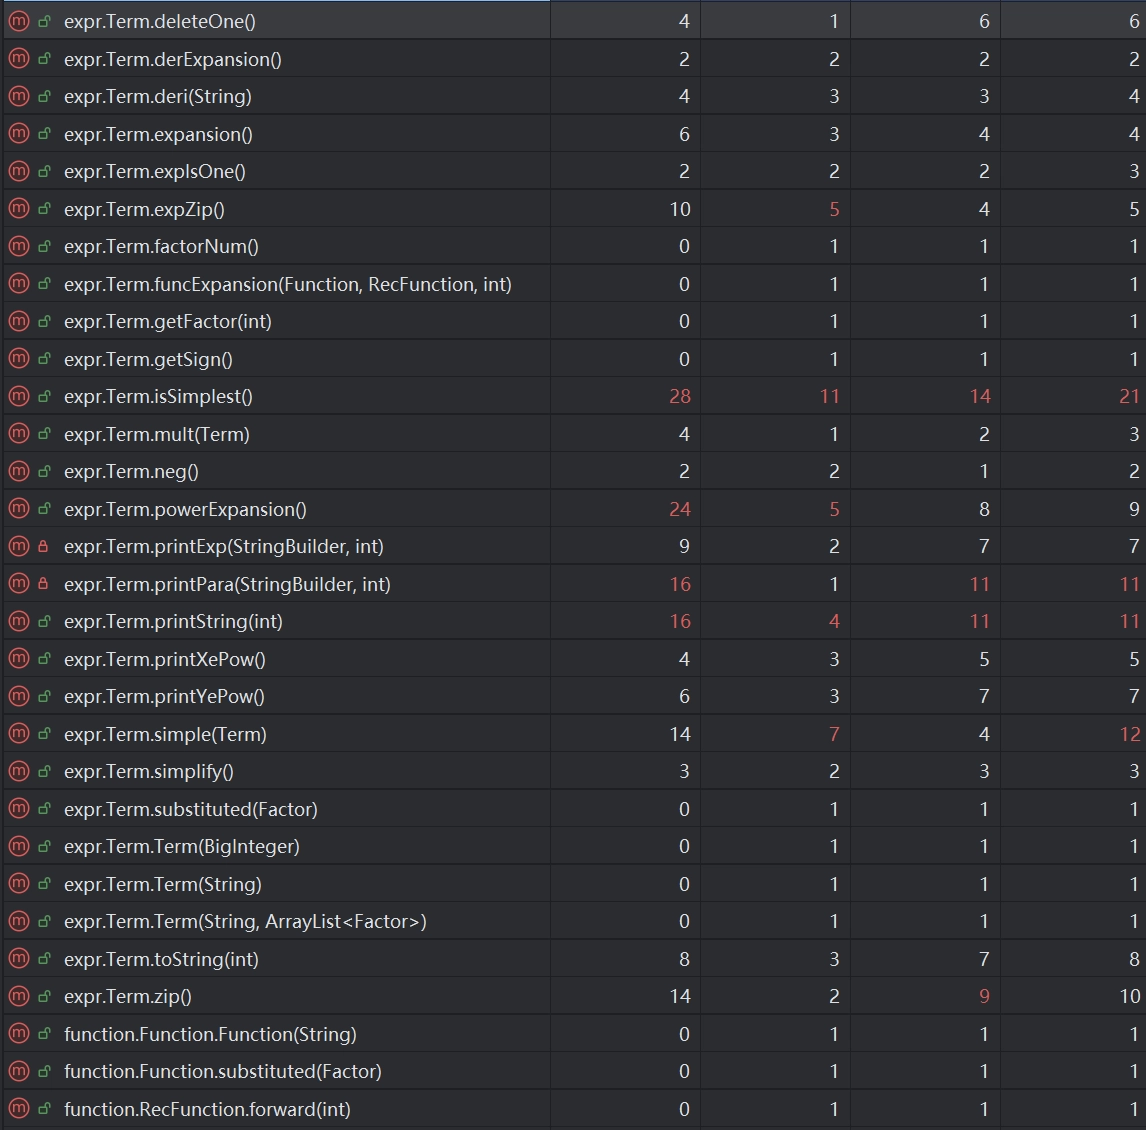
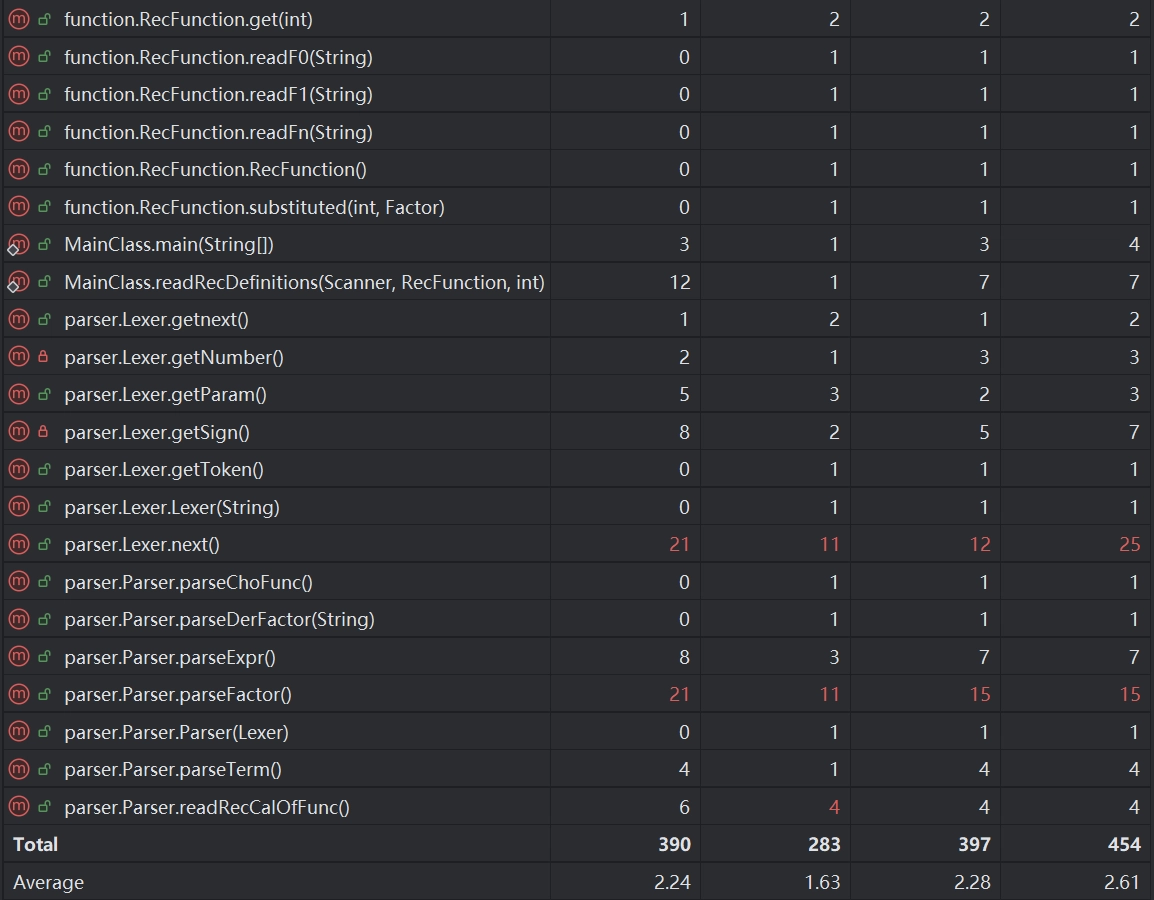
下面是程序的度量(每个方法的规模、分支数目实在是太多了,这里用平均代替了,,具体数据放在最后):
| 类名 | 属性个数 | 方法个数 | 平均方法规模 | 方法平均控制分支数目 | 总代码规模 | 内聚度LCOM | 耦合性指标CBO |
|---|---|---|---|---|---|---|---|
Expr | 2 | 22 | 5.82 | 1.91 | 128 | 1 | 11 |
Term | 7 | 32 | 15.09 | 4.69 | 483 | 1 | 10 |
PowFunc | 2 | 11 | 7.45 | 1.64 | 82 | 3 | 9 |
SignNum | 1 | 10 | 4.1 | 1 | 41 | 5 | 9 |
NormCalOfFunc | 1 | 8 | 4.5 | 1 | 36 | 5 | 6 |
RecCalOfFunc | 3 | 9 | 7.22 | 1.56 | 65 | 5 | 7 |
DerFactor | 2 | 9 | 4.67 | 1 | 42 | 3 | 7 |
ExpFunc | 3 | 16 | 11.81 | 2.88 | 189 | 1 | 13 |
ExprFactor | 2 | 19 | 5.68 | 1.42 | 108 | 1 | 14 |
ChoFunc | 4 | 11 | 10.91 | 2.73 | 120 | 1 | 7 |
MainClass | 0 | 2 | 30 | 5.5 | 60 | 1 | 5 |
Lexer | 3 | 7 | 14.57 | 6 | 102 | 1 | 5 |
Parser | 1 | 7 | 21 | 4.71 | 147 | 1 | 15 |
Function | 2 | 2 | 6 | 1 | 12 | 1 | 16 |
RecFunction | 2 | 7 | 4.57 | 1.14 | 32 | 1 | 16 |
| 总 | 1647 | (Average) 2.07 | (Average) 10 |
分析:
Term方法过于冗杂,内部逻辑过于复杂、特判过多,这都是因为一开始没有充分设计,后期debug的过程中不断加入补丁造成的。(几乎顶着500行的checkstyle上线,方法规模也过大)SignNum,两种CalOfFunction等等,当整体而言,代码的内聚度还是令人满意的。ExprFactor类和两种Function类,可以考虑把其中的部分逻辑干脆搬出去,让它们更加独立。且项目整体耦合度都过高,体现出设计不够清晰。总的来说,架构的优点是相当直观,缺点则是规模较大,部分类、方法过于冗杂,类间耦合度过高等等。
第一次作业,正常的递归下降解析。但在化简表达式上使用了臭名昭著的插值法。一方面导致代码在hw2完全不具备可扩展性,另一方方面也导致互测数据全部TLE。
第二次作业,添加了exp、选择式因子和自定义函数。选择将代码全部重构。
第三次作业,添加了y,自定义递推函数和求导因子。自定义递推函数,我为了能够直接用Parser解析其定义,为RecFunction写了一个属性,让它在定义中的状态,和在正常表达式中的状态不一样。现在想想其实这种方法会导致类的内聚度下降,不如另开一个新的类会好一点。
如果后续进行进一步迭代,比如加入三角因子,只需要添加对应的因子类,修改对应的zip方法和合并同类项方法即可。
一部分Bug集中在term项的print部分,关于系数为0时是否只有一项判断是否输出0,系数为1的输出、exp(0)的删除等等,涉及到大量的逻辑判断,不清楚是否存在更高效的输出优化方法。
还有一个看上去很“诡异”的Bug,首先这个bug在非调试模式下正常出现,因此我一开始不认为与调试器有关。但系统在调试模式下,经过一行terms.add(term)后,factors中的内容光荣发生改变。terms作为一个ArrayList,它的add方法应该不可能出错。debug过程到这里就被卡住了。
不管这个bug以什么样的形式出现,它一定出现在exp相关的处理逻辑里,经过仔细排查,发现Term类的DeleteOne方法写的有问题,原本应该删除次数为BigInteger.ZERO的expFactor,结果在tab之力的作用下写成了BigInteger.ONE……
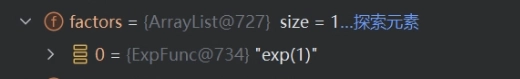
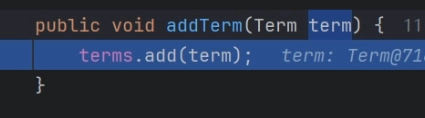
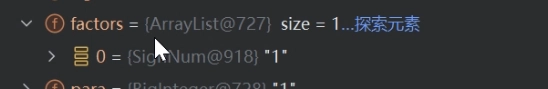
然后,在调试过程中,编译器在add后,自动重新调用了Term的toString方法,而在这个方法的开头,调用了deleteOne…….
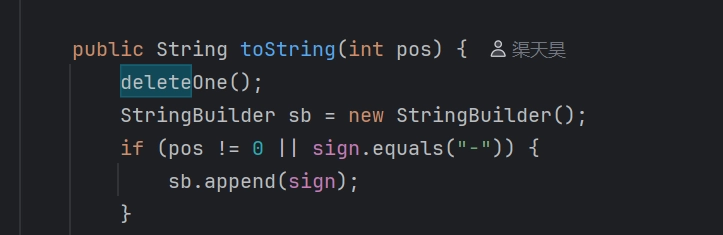
那为什么不在调试模式下也会出错呢?因为在其它地方也会调用deleteOne方法,这里错了就是错了……
另外还有对比两个数是否相等时我采用的是计算值的方法,这个想法的根源在于hw1我就实现了cal方法,但是这在hw3带来一个大问题,我直接把x的传入参数复制了一份给y,这导致x-y恒等于0,因此导致了一份bug。
总结来说,第一是,一个方法里不应该写太多逻辑判断,尤其是复杂的逻辑判断。逻辑判断多的地方一定要单独充分测试
第二是,不要贸然在方法里改变一个类,尽量让一个类只有一种被改变的方式,即遵守SRP原则。
最大的问题就这两点吧,复杂逻辑容易出错,多次改变类属性容易出错,其它bug多半也是这一类,别的就没有什么了。
互测茶人策略分析:
一种是自己直接构造邪门的数据,广撒网的叉人,效率较低,而且到了hw3极易爆cost。
一种是搓出来评测机,把大家的代码放在一起跑,至少在c房这种叉人效率还是很高的。
最后一种是,我水平达不到的,看别人代码,发现潜在逻辑问题,构造针对性的数据叉人。我是昨天讨论课上才知道这种方法能够如此强大。大概在A房也能有很好的作用,但我水平还达不到就是了。
优化集中在Term的print方法,包括系数1的优化(通过一个复杂的逻辑判断1是否输出)、exp(0)的删除等等。昨天研讨课上提到的exp的优化给我看傻了,我是完全没有想到这么深。只考虑过exp系数提取和不提取的优化,但最后也没有实现……
此外,在expr的print方法里也执行了一些优化,比如将负数后置等等。
Term的print里出现了很多bug,看来我是不能保证我代码的简洁性与正确性了,或许可以考虑拆分出来更多的方法,比如写一个专门的判断1方法,然后让逻辑判断分步骤有序进行,甚至拆分出更多的方法,尽量让每一个方法都更清晰……
第一次作业牛顿迭代逻辑使用AI写的,一开始自己写的拉格朗日,但时间复杂度太低,就把原方法传给ai,让它在保留原接口不变的情况下,将计算方法重写为牛顿迭代法。效果出奇的好。大概ai写这种纯数学代码准确度还是很高的。
前两次作业用大模型辅助搭建了数据生成器,效果还是不错的,正比于你给它提示词的清晰度与复杂度。
代码重构真是太累了!我再也不自己瞎想架构了,hw2我将直接参考学长经过验证的稳健架构……
但说到底,架构设计也是面向对象课程的核心能力,我大概会先自己设计,然后参考学长的架构进行修改和优化吧……
以及一个很大的感受:架构大于逻辑,一个好的架构可以让逻辑更加清晰,当你遇到逻辑不清晰的地方时,不妨想想怎么调整架构来解决,比起速度,在绝大多数情况下,正确性可能来的更重要一些。
希望可以对一些非常数学的问题,提供一些指导,比如exp的优化部分,选择表达式的相等判断方法,再比如对多项式进行展开的方法。让同学们可以把精力集中在代码本身上。