


309
社区成员
 发帖
 与我相关
 我的任务
 分享
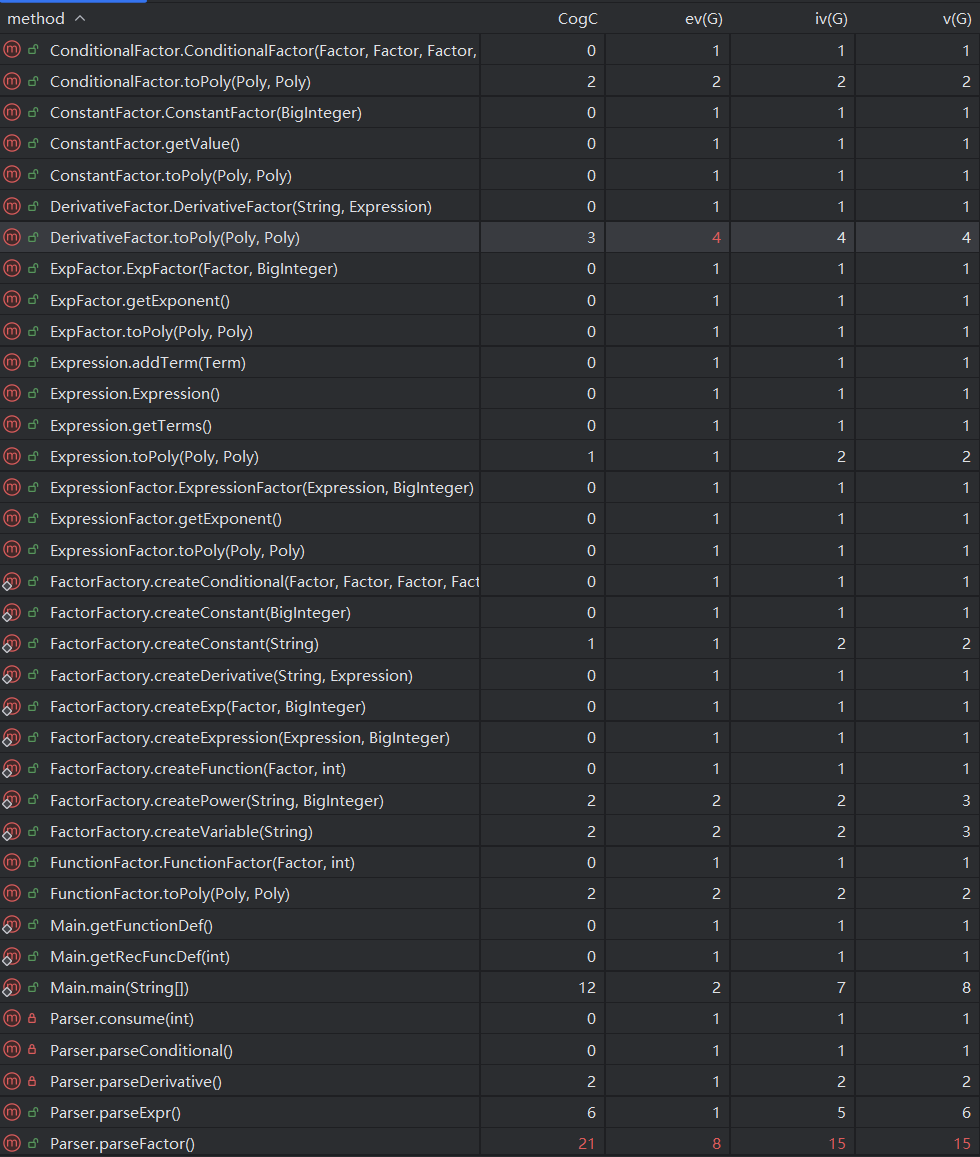
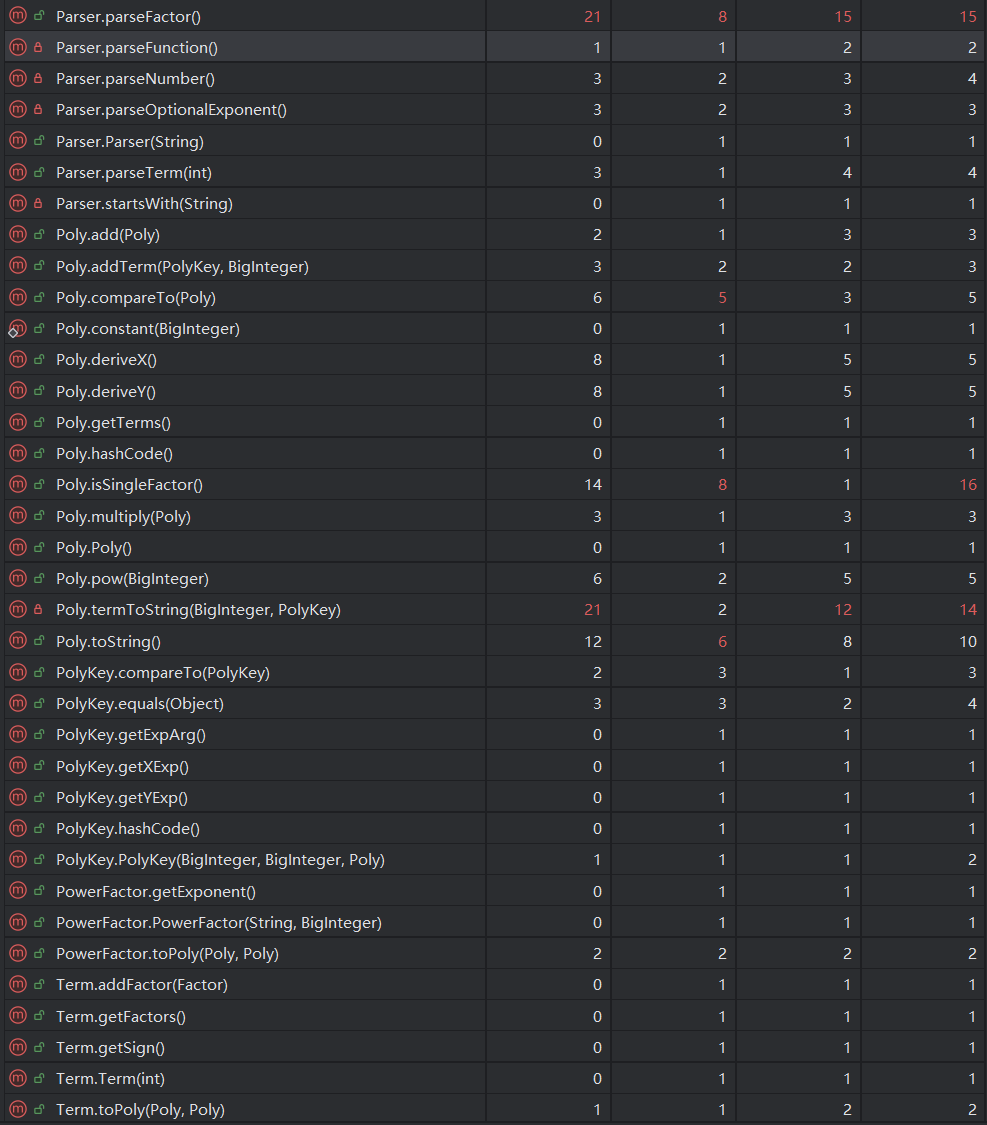
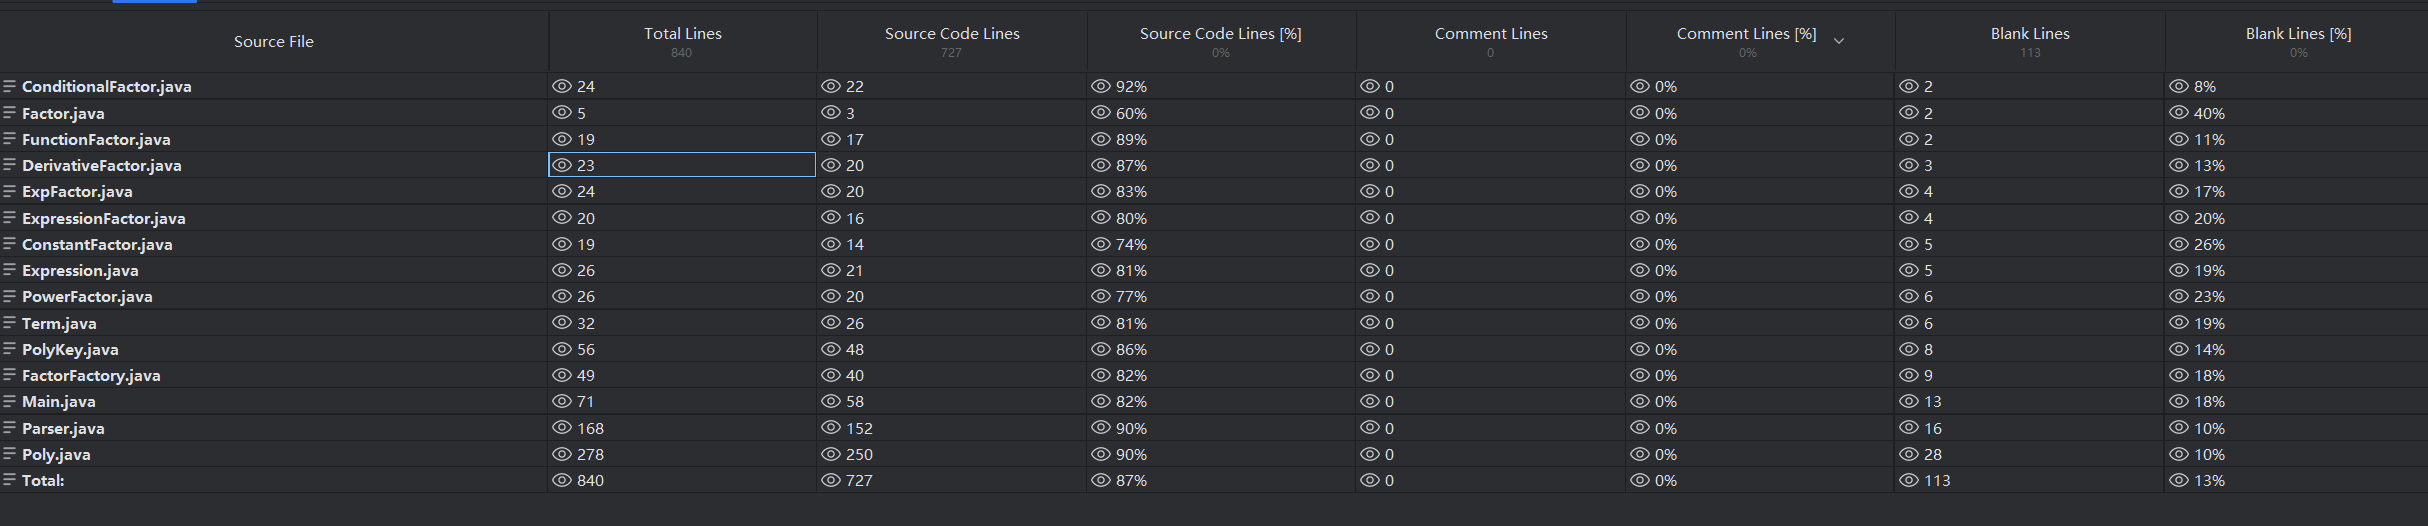
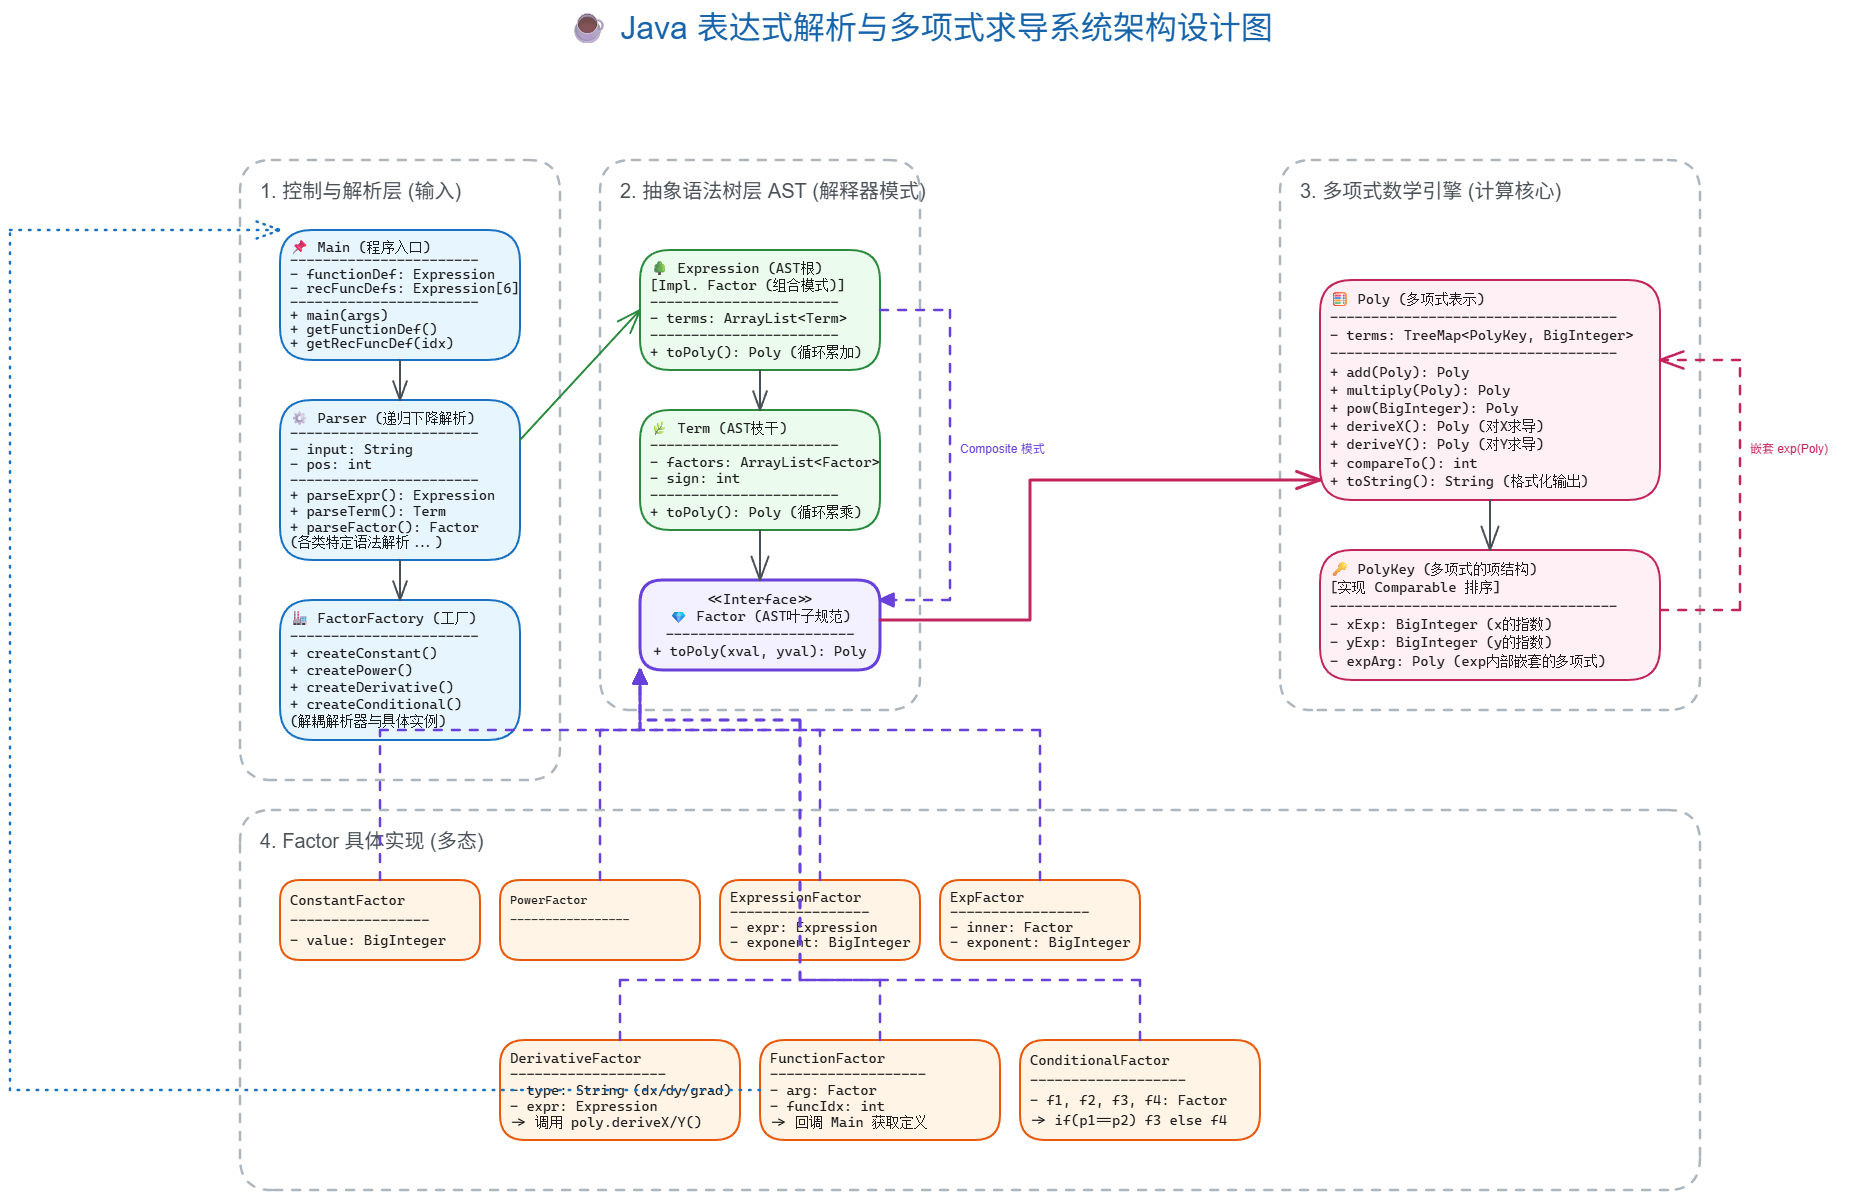
严格的 AST(抽象语法树)映射:Expression、Term、Factor 的层次严格对应形式化表述,递归下降的逻辑非常自然。
运算与解析分离:AST 节点只负责解析和存储结构,所有的数学运算全部下放给 Poly(多项式对象)去完成,数据结构与数学计算实现了解耦。
工厂模式:引入了 FactorFactory,规范了各种因子的创建过程。
第一次作业(基建阶段):建立了递归下降的基本框架(Lexer + Parser)。计算层设计了最基础的 Poly 类,内部用 HashMap<BigInteger, int> 表示 指数与系数
第二次作业(指数与函数扩充):这次迎来了重构。原有的 HashMap 无法表示
含有exp的表达式,因此我引入了 PolyKey 类,将原先的 BigInteger 键替换为一个包含x的指数和exp内部表达式的对象。这体现了面向对象设计的优势:无需修改外部交互接口,只需升级底层数据结构。
第三次作业(求导与条件):由于架构底子打得比较好,第三次作业几乎没有重构,仅仅在 AST 中增加了 DerivativeFactor,并在 Poly 中增加了 deriveX() 方法支持链式求导,极其丝滑。
在第一次作业中指数保证只会迭代三次且单个指数最大不超过8,因此指数设计的是int类型,但在第二次作业中课程组取消了这一限制,因此在这里有错误,需要将指数改为Biginteger类型
主要是通过人工审查别人的代码,并对边界条件,嵌套,选择因子的cost,优化方法带来的额外内存消耗
在三次作业中,我主要做了以下优化:
数学化简:常数合并、exp(0)→1。这些在计算层 (Poly 的乘法和加法中) 完成。
格式化简:正项提前(减少开头的负号)、省略括号(判断内容是不是因子)。
代码生成使用率:在核心的面向对象设计、AST 构建、计算逻辑上,AI 生成代码的比例为 0%。在一些琐碎的模板代码(如重写 equals 和 hashCode)以及部分基础正则表达式的设计上,AI 使用率约为 5%。
第一单元给我最大的震撼是:好架构很重要。
在第一次作业时,我曾犹豫是否要偷懒直接用字符串替换来硬解。但幸好我坚持学习并实现了基于 AST 的递归下降解析。正是由于第一次作业打下了坚实的树形结构基础,第二次和第三次作业面对令人窒息的需求增加时,我只感到了功能的扩展,而没有感受到代码逻辑要崩塌的恐慌。面向对象中的“高内聚低耦合”和“工厂模式”,不再是干瘪的定义,而是实实在在防止我半夜因为 Bug 而破防的武器。
针对第一单元的课程,我有以下建议:
提供 AST 可视化工具:递归下降初学时很难调试,如果课程组能在 Pre 阶段或第一次作业提供一个轻量级的 AST 树打印或可视化工具,能极大降低同学们的 Debug 门槛。

