


309
社区成员
 发帖
 与我相关
 我的任务
 分享
本单元的任务是表达式展开与化简,分三次作业逐步深入,从第一次作业的简单表达式展开,到第二次作业的支持自定义函数与指数因子,再到第三次作业的支持递归函数、求导算子以及两个变量因子。整个过程中,我经历了从最初的零散式编程到逐步建立层次化、可扩展的架构。三次作业中,第二次作业我花的时间是最多的(十多个小时),因为第一次作业并没有建立一个好的架构,导致我完全抛弃了第一次作业的架构,完完全全重构了一遍,不过也因此大大减轻了我第三次作业的负担(4个小时左右)。由此可见,好的架构真的至关重要。
我的最终版本共包含以下主要类:
| 类名 | 属性数 | 方法数 | 代码行数 | OCavg | OCmax | WMC |
|---|---|---|---|---|---|---|
| ConstFactor | 1 | 4 | 23 | 1.00 | 1 | 4 |
| Definer | 0 | 3 | 13 | 1.00 | 1 | 2 |
| DeriFactor | 2 | 5 | 27 | 1.00 | 1 | 5 |
| Exper | 1 | 4 | 29 | 1.50 | 2 | 6 |
| ExperFactor | 2 | 5 | 29 | 1.00 | 1 | 5 |
| ExpFactor | 2 | 5 | 31 | 1.00 | 1 | 5 |
| Factor(接口) | 0 | 2 | 5 | —— | —— | —— |
|
FuncFactor | 2 | 5 | 30 | 1.00 | 1 | 5 |
| Function | 2 | 3 | 17 | 1.00 | 1 | 3 |
| GradFactor | 1 | 4 | 24 | 1.00 | 1 | 4 |
| Lexer | 2 | 6 | 41 | 1.50 | 2 | 9 |
| Main | 0 | 2 | 50 | 2.50 | 4 | 5 |
| Mono | 3 | 7 | 55 | 1.71 | 5 | 12 |
| Parse | 1 | 13 | 210 | 3.46 | 11 | 45 |
| Poly | 1 | 18 | 320 | 4.17 | 13 | 75 |
| RecurFunction | 2 | 4 | 54 | 2.25 | 3 | 9 |
| SelectFactor | 4 | 7 | 47 | 1.14 | 2 | 8 |
| Term | 2 | 5 | 37 | 1.60 | 3 | 8 |
| VarFactor | 2 | 5 | 43 | 1.40 | 2 | 7 |
从中我们可以看到,代码的核心逻辑在于 Poly 类和 Parse 类,这两个类承担了核心逻辑,其中Parse类负责解析表达式,Poly类负责处理底层运算逻辑以及输出逻辑,因此造成了这两个类在项目中具有较高的复杂度和权重。
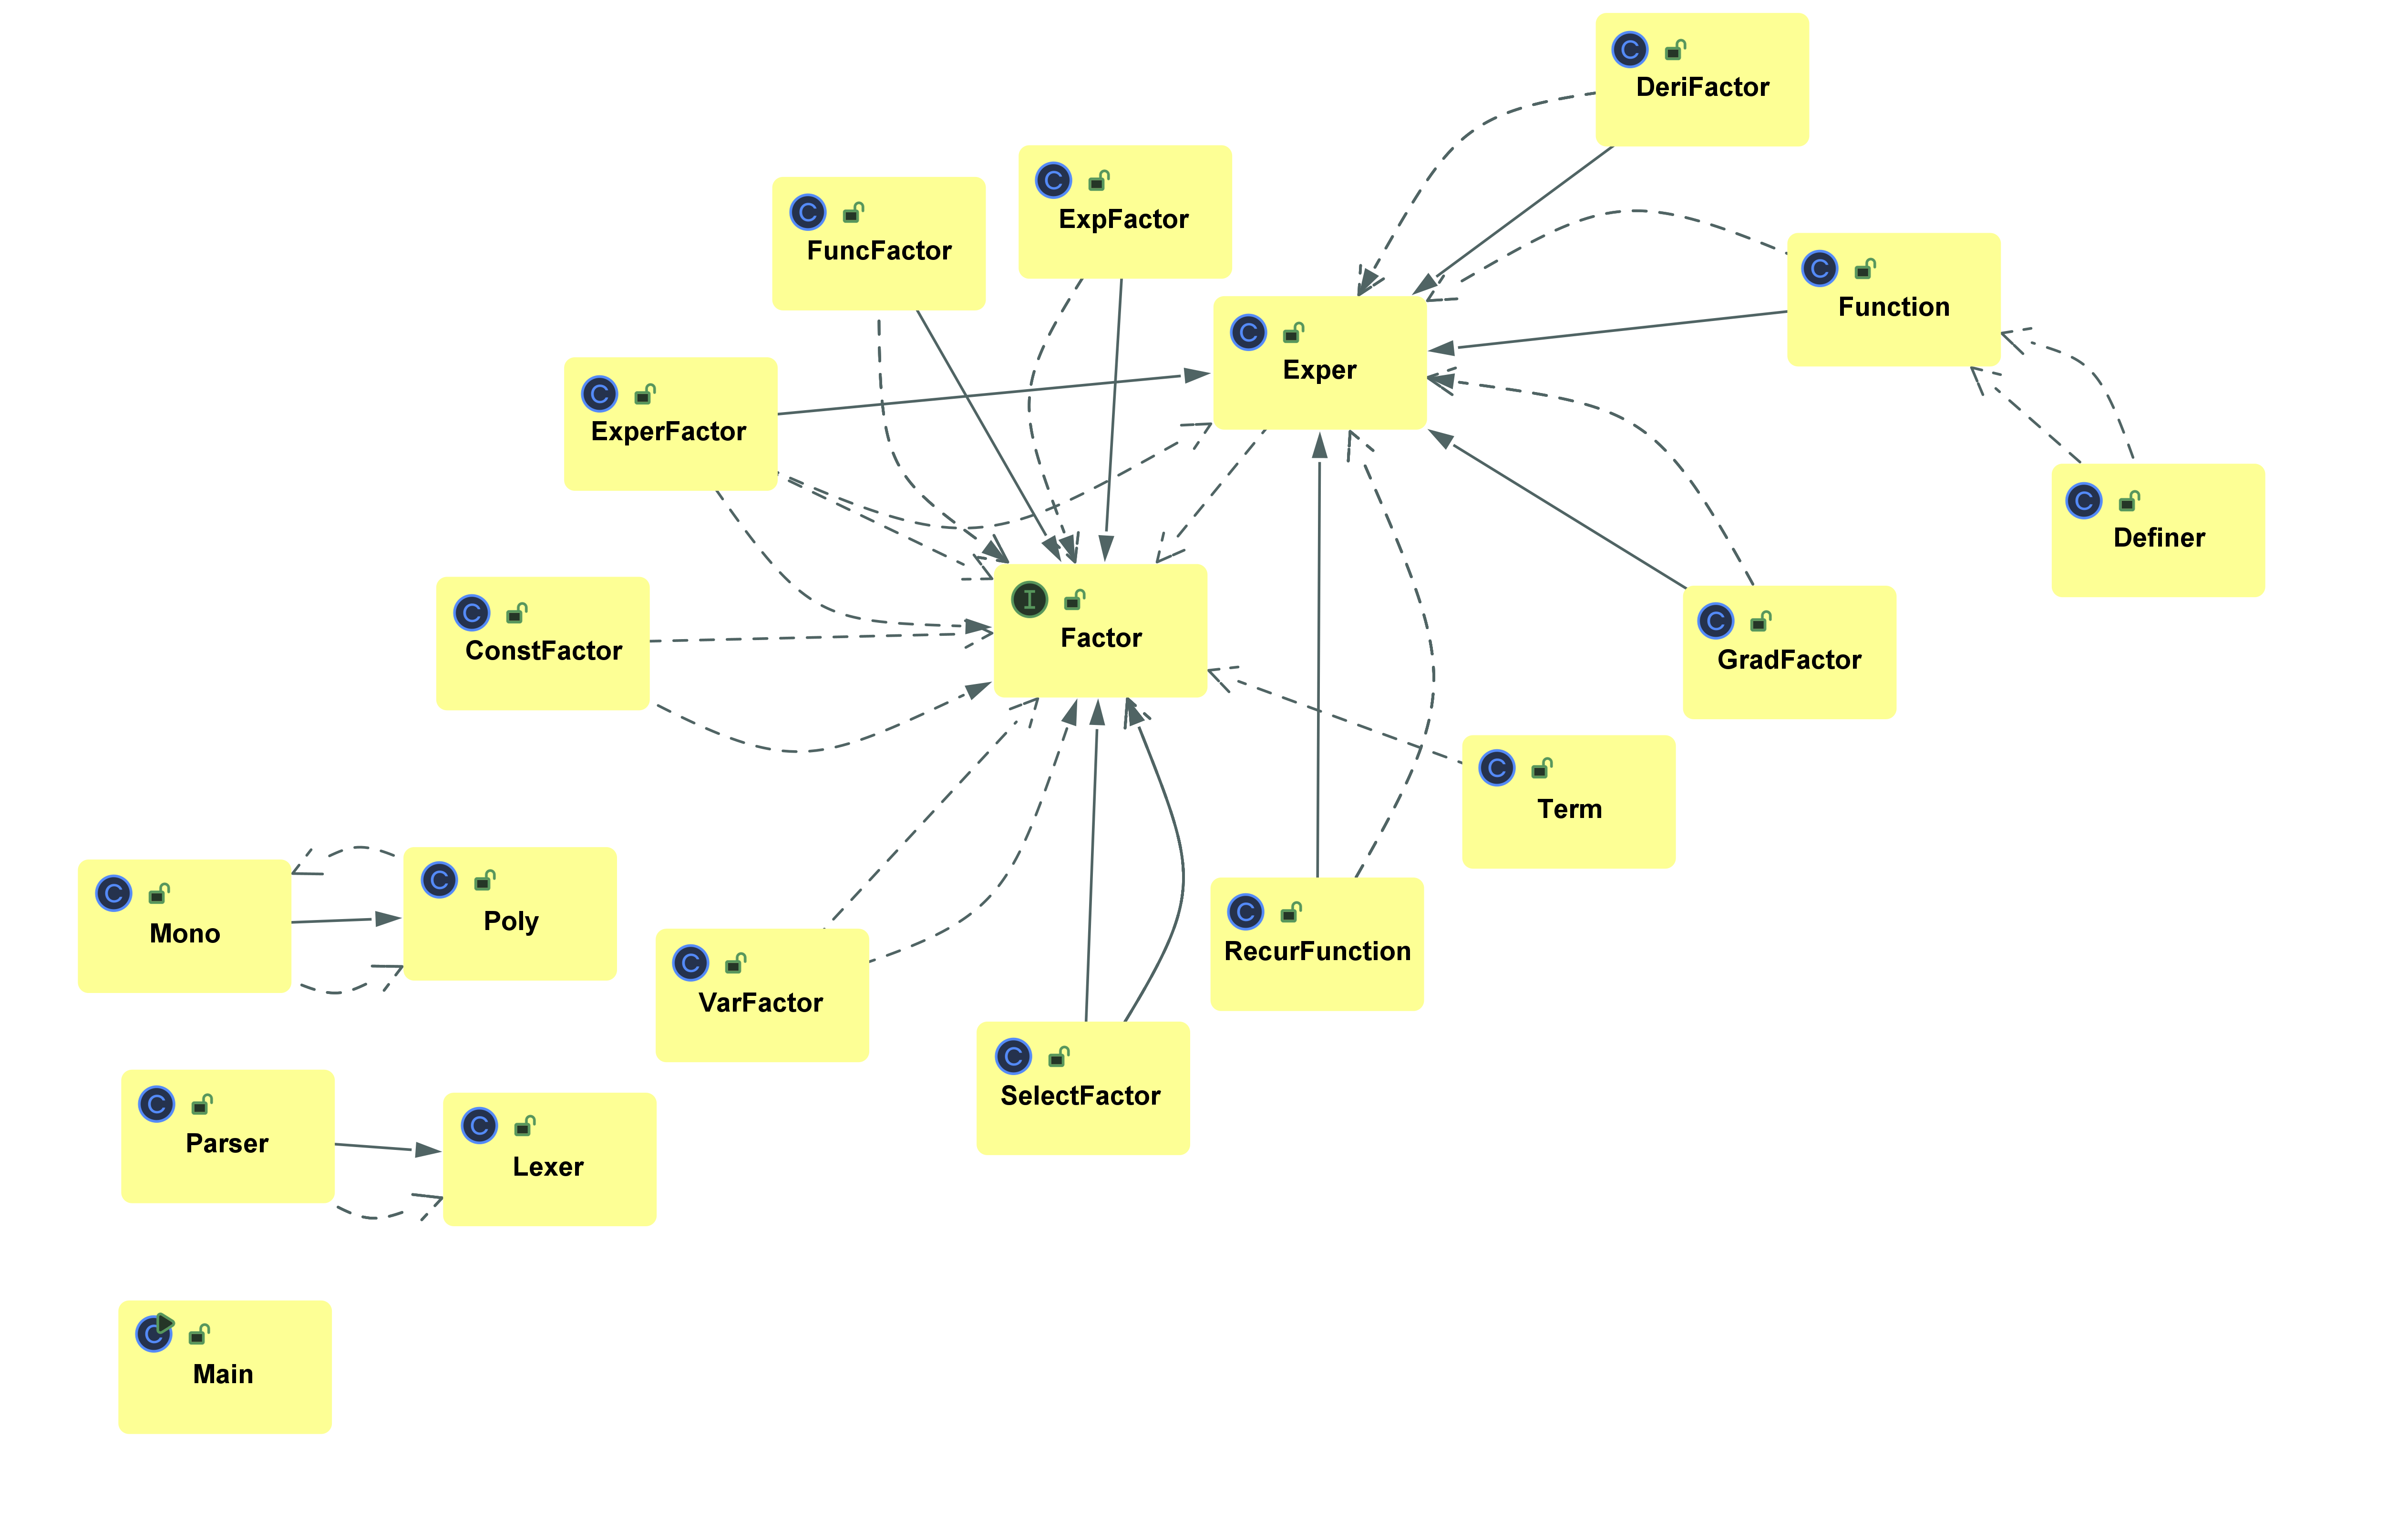
层次化架构清晰:Factor → Term → Exper → Poly 严格对应 BNF,易于扩展新因子。
统一的代入机制:所有因子实现 substitute,递归替换实参,函数调用处理简洁。
求导递归实现:Poly.derive 基于链式法则,DeriFactor / GradFactor 直接复用。
递推函数记忆化:RecurFunction 预计算 f{0}~f{5} 并注册,避免重复展开。
Poly/Mono 职责过重:Mono 同时存储指数和嵌套 Poly(用于指数函数),导致 mul、derive 中大量条件分支,可读性差且易错。
输出与化简耦合:GetResult 中混杂系数提取、exp 处理、字符串拼接,缺少独立化简步骤,可能影响性能分和括号正确性。
性能开销:Poly 运算频繁创建新对象,代入过程递归构造新树,存在冗余拷贝
要求:仅支持加、减、乘、幂运算,变量仅支持 x。
架构: Poly类使用 Treemap<Integer, BigInteger> 来存储多项式的项,key为幂次,value为系数。Parse类构建关于Exper,Term,Factor递归下降解析器来解析输入的表达式。将计算逻辑完全集成在 Poly类中,Parse 负责解析输入,然后 Exper,Term,Factor 负责构建Poly对象。
要求:引入函数定义与调用(f(x)=...),支持 exp 函数,以及三目运算符。
因为exp的加入,且需要支持exp的嵌套,第一次作业底层数据结构完全无法满足要求,被迫重构了底层数据结构,改为 Poly 类使用 HashMap<IMono,BigInteger> 来存储多项式的项,并创造了一个新的类 Mono 用来表示项的标签,包含了幂次和以及内部多项式(exp)。通过这样的设计,成功实现了 exp 的嵌套调用。至于自定义函数,我增加了一个函数因子(便于统一管理)和一个 Function类,因为考虑到第三次作业可能会增加函数,我用了一个Define类用来存储出现过的所有函数,用 HashMap 存储,key 是函数名,value 是函数定义式(Function)。
要求:递归函数 f{n},求导算子dx、dy、grad,以及支持两个变量 x, y。
通过设计 RecurFunction 类来实现递归函数的识别与处理,通过模板式循环展开得到0-5的递归函数,并将其作为不同的函数存储在Define中。通过这样的设计,成功实现了递归函数的处理,并保证了在用的时候不需要再进行计算。因为之前我们将所有 Exper,Term,Factor 都转化为了 Poly,所以我并没有再在这三个类里面处理求导算子,而是将转化为的 Poly 统一求导,减少了耦合。同时在 Mono 类中增加一个关于 Y 的幂次以支持变量Y。
假设新增需求:f(x) 的定义式中可以出现求导算子以及三目运算符或者新增g(x),h(x)等不同函数
当前架构已经实现了关于求导算子以及三目运算符的 substitue 方法,同时Define也支持不同的自定义函数。
Bug1:
在第二次作业中没有处理好 Mono 内部 Poly 为空与 Mono 内部 Poly 为 null 的等价关系,即在运算过程中没有将为空的即 exp(0) 及时转化为 1,而是在输出逻辑中进行转化,这导致了其在三目运算符中比较的错误。
Bug2:
在第二次作业中幂次仍然沿用第一次作业的int,没注意到第二次作业的指数重复嵌套,导致指数的范围未能满足要求
Bug3:
在第三次作业中求导时误更改了 Poly 的系数,导致同时对 x 以及 exp 求导时前面的系数不对
互测阶段我主要用了三种策略:
边界测试:针对易错点构造测试用例,如超大/嵌套指数、exp(0)、x^0、多层嵌套、连续正负号、多余括号等,检测解析和运算是否正确。
随机生成表达式:编写随机表达式生成器,覆盖所有语法特性与组合,批量运行被测程序与正确版本进行输出比对,快速定位差异。
代码审查:阅读代码中优化的相关逻辑,因为优化往往是最容易出错的点
三种方法各有各的有点基本以随机生成表达式为主,以边界测试为辅,代码审查没怎么用过,因为效率太低
递推函数记忆化
public void initFunctions() {
    Definer.addFunction(new Function("f{0}", expers.get(0)));
    Definer.addFunction(new Function("f{1}", expers.get(1)));
    for (int i = 2; i <= 5; i++) {
        Exper exper = expandFunctions(i);
        expers.add(exper);
        Definer.addFunction(new Function("f{" + i + "}", exper));
    }
}
RecurFunction 在初始化时预计算并缓存 f{0} 至 f{5} 的展开表达式,后续调用直接查表,避免重复展开和递归计算。
快速幂算法
public Poly pow(BigInteger exponent) {
    if (exponent.equals(BigInteger.ZERO)) {
        return new Poly(Mono.initMono(), BigInteger.ONE);
    }
    Poly base = this;
    Poly result = new Poly(Mono.initMono(), BigInteger.ONE);
    BigInteger e = exponent;
    while (e.compareTo(BigInteger.ZERO) > 0) {
        if (e.testBit(0)) {
            result = result.mul(base);
        }
        base = base.mul(base);
        e = e.shiftRight(1);
    }
    return result;
}
Poly.pow 方法使用二进制指数分解实现快速幂,将多项式乘幂的时间复杂度从 O(n) 降至 O(log n)。
同类项合并与零系数消除
public Poly add(Poly other) {
    Poly temp = new Poly(this);
    for (Map.Entry<Mono, BigInteger> entry : other.treeLists.entrySet()) {
        Mono mono = entry.getKey();
        BigInteger coeff = entry.getValue();
        BigInteger existing = temp.treeLists.get(mono);
        if (existing == null) {
            temp.treeLists.put(mono, coeff);
        } else {
            BigInteger sum = existing.add(coeff);
            if (sum.equals(BigInteger.ZERO)) {
                temp.treeLists.remove(mono);
            } else {
                temp.treeLists.put(mono, sum);
            }
        }
    }
    return temp;
}
Poly 内部使用 HashMap<Mono, BigInteger> 存储单项式,在 add 和 mul 操作中,若系数相加为零则直接从 map 中移除,保持表示最简,减少后续运算量。
解析阶段预处理空白符
public String removeWhitespace(String s) {
    return s.replaceAll("\\s+", "");
}
Lexer 在构造时一次性移除输入字符串中的所有空白符,避免解析过程中反复跳过空白,提升解析效率。
在代码正确性编写阶段,只对AI提问,基本不使用AI来直接生成代码。AI对代码的干预有且仅在debug以及优化中进行。
以下是我的代码AI使用度量:
| 作业 | 正确性相关代码AI生成比例 | 性能优化代码AI生成比例 |
|---|---|---|
| 第一次 | 5% | 0% |
| 第二次 | 10% | 20% |
| 第三次 | 5% | 10% |
天权星同学在第二次作业中代码大部分应该都是AI生成,注释不够精简,甚至注释还带有标点符号像“!”“ 。”之类的,以及代码太过规范了,没有冗余,而且最终只有4个类,感觉应该大部分是AI code的。
每次写OO作业的时候,写的时候有多爽,debug的时候就有多惨,平时写的时候一点要细心,最好想清楚了再写,不要边写边想,不然很容易忽略一些细节造成bug。
同时好的架构真的非常重要,每次写代码的时候应该预判一下下一次作业的要求,并提前准备好相应的可拓展的地方。
看到别人用AI写代码拿高分,心里还是有点不舒服的,不过,与其关心别人怎么用AI,不如思考怎么使用AI来使自己学的更好,而不是唯分数论。
我认为第一单元的课程可以作如下改进:
提供更详细的指导,题目意思要表达清楚,如多个正负号那一块,可以适当给一些架构设计意见,提供一些边界情况的测试数据

