


309
社区成员
 发帖
 与我相关
 我的任务

 分享
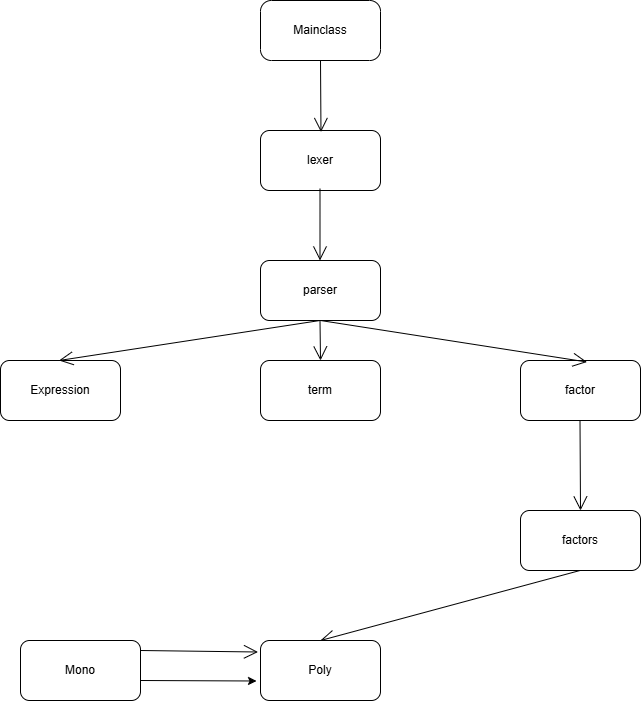
总体来说,代码分为 4 个模块:词法分析,语法分析,计算,输出。其中,词法分析模块负责将输入的字符串转换成一个个的 token,语法分析模块负责将 token 解析成一个抽象语法树,计算模块负责根据抽象语法树计算出结果,输出模块负责将结果转成String输出到控制台并进行优化。
代码架构简图如下:
| Class | OCavg | OCmax | WMC |
|---|---|---|---|
| Derive | 1.5 | 3 | 6 |
| Exp | 1 | 1 | 4 |
| Expression | 1.4 | 3 | 7 |
| Function | 1 | 1 | 4 |
| FunctionF | 1 | 1 | 4 |
| Input | 6 | 6 | 6 |
| Lexer | 3 | 9 | 15 |
| MainClass | 1 | 1 | 1 |
| Mono | 1.5 | 3 | 12 |
| Number | 1 | 1 | 4 |
| Output | 4.56 | 13 | 41 |
| Parser | 2.13 | 7 | 32 |
| Polynomia | 2.09 | 3 | 23 |
| RecurFunc | 1.6 | 4 | 8 |
| RecurFunc | 1 | 1 | 16 |
| Select | 1.25 | 2 | 5 |
| Term | 1.75 | 4 | 7 |
| Variable | 1.5 | 3 | 6 |
通过上述类复杂度指标我们可以得出以下结论:
Output 和 Parser,这两个类的 OCavg 和 WMC 都较高,说明他们的中某些方法的逻辑非常深,且方法数量较多,可能存在一些重复代码或者过于复杂的逻辑。虽然这与他们本身的职责相关,但是我们可以考虑将他们的职责进一步细化。Polymial 的 WMC 虽然较高,但是但是最高单项(OCMax)只有3,说明多项式类包含很多简单的小方法.方法拆分较为合理.| 方法 | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| Derive.Derive(Factor, String, int) | 0 | 1 | 1 | 1 |
| Derive.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| Derive.setSign(int) | 0 | 1 | 1 | 1 |
| Derive.toPoly() | 3 | 1 | 3 | 3 |
| Exp.Exp(Factor, BigInteger, int) | 0 | 1 | 1 | 1 |
| Exp.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| Exp.setSign(int) | 0 | 1 | 1 | 1 |
| Exp.toPoly() | 0 | 1 | 1 | 1 |
| Expression.Expression() | 0 | 1 | 1 | 1 |
| Expression.addTerm(Term) | 0 | 1 | 1 | 1 |
| Expression.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| Expression.setSign(int) | 0 | 1 | 1 | 1 |
| Expression.toPoly() | 2 | 1 | 3 | 3 |
| Function.Function(Factor, int, BigInteger) | 0 | 1 | 1 | 1 |
| Function.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| Function.setSign(int) | 0 | 1 | 1 | 1 |
| Function.toPoly() | 0 | 1 | 1 | 1 |
| FunctionF.FunctionF() | 0 | 1 | 1 | 1 |
| FunctionF.getInstance() | 0 | 1 | 1 | 1 |
| FunctionF.getPoly() | 0 | 1 | 1 | 1 |
| FunctionF.recordF(Polynomial) | 0 | 1 | 1 | 1 |
| Input.inputHandler(Scanner) | 9 | 1 | 6 | 6 |
| Lexer.Lexer(String) | 0 | 1 | 1 | 1 |
| Lexer.getNumber() | 2 | 1 | 3 | 3 |
| Lexer.match(String) | 2 | 2 | 2 | 2 |
| Lexer.next() | 15 | 2 | 20 | 21 |
| Lexer.peek() | 0 | 1 | 1 | 1 |
| MainClass.main(String[]) | 0 | 1 | 1 | 1 |
| Mono.Mono(BigInteger, BigInteger, Polynomial) | 0 | 1 | 1 | 1 |
| Mono.derive(String) | 2 | 1 | 3 | 3 |
| Mono.equals(Object) | 4 | 3 | 4 | 6 |
| Mono.getXexp() | 0 | 1 | 1 | 1 |
| Mono.getYexp() | 0 | 1 | 1 | 1 |
| Mono.getZexp() | 0 | 1 | 1 | 1 |
| Mono.hashCode() | 0 | 1 | 1 | 1 |
| Mono.substitute(Polynomial) | 0 | 1 | 1 | 1 |
| Number.Number(BigInteger) | 0 | 1 | 1 | 1 |
| Number.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| Number.setSign(int) | 0 | 1 | 1 | 1 |
| Number.toPoly() | 0 | 1 | 1 | 1 |
| Output.appendTerm(Mono, BigInteger, StringBuilder, Boolean, Map<Polynomial, String>) | 19 | 2 | 14 | 16 |
| Output.divideByCommon(Polynomial, BigInteger) | 1 | 1 | 2 | 2 |
| Output.getCommonFactor(Polynomial) | 3 | 1 | 3 | 3 |
| Output.isEmpty(Polynomial) | 2 | 2 | 2 | 3 |
| Output.isFactor(Polynomial) | 14 | 7 | 17 | 18 |
| Output.newExp(Polynomial, Map<Polynomial, String>) | 2 | 2 | 1 | 2 |
| Output.optimizeExp(Polynomial, Map<Polynomial, String>) | 3 | 1 | 2 | 3 |
| Output.optimizePoly(Polynomial) | 0 | 1 | 1 | 1 |
| Output.optimizePolyInternal(Polynomial, Map<Polynomial, String>) | 8 | 5 | 5 | 8 |
| Parser.Parser(Lexer) | 0 | 1 | 1 | 1 |
| Parser.parseDerive(int) | 0 | 1 | 1 | 1 |
| Parser.parseExp(int) | 0 | 1 | 1 | 1 |
| Parser.parseExponent() | 3 | 1 | 3 | 3 |
| Parser.parseExpression() | 2 | 1 | 3 | 3 |
| Parser.parseFactor() | 9 | 7 | 10 | 10 |
| Parser.parseFunction(int) | 0 | 1 | 1 | 1 |
| Parser.parseGroupedExp(int) | 0 | 1 | 1 | 1 |
| Parser.parseLeadingSign() | 4 | 1 | 3 | 4 |
| Parser.parseNum(int) | 0 | 1 | 1 | 1 |
| Parser.parseRecursive() | 4 | 1 | 3 | 3 |
| Parser.parseSelect(int) | 0 | 1 | 1 | 1 |
| Parser.parseTerm() | 1 | 1 | 2 | 2 |
| Parser.parseVariable(int) | 0 | 1 | 1 | 1 |
| Parser.recursiveParseLeading() | 4 | 1 | 3 | 4 |
| Polynomial.Polynomial() | 0 | 1 | 1 | 1 |
| Polynomial.Polynomial(Mono, BigInteger) | 2 | 1 | 2 | 2 |
| Polynomial.add(Polynomial) | 1 | 1 | 2 | 2 |
| Polynomial.addTerm(Mono, BigInteger) | 3 | 2 | 2 | 4 |
| Polynomial.derive(String) | 1 | 1 | 2 | 2 |
| Polynomial.equals(Object) | 3 | 3 | 2 | 4 |
| Polynomial.getTerms() | 0 | 1 | 1 | 1 |
| Polynomial.hashCode() | 0 | 1 | 1 | 1 |
| Polynomial.mult(Polynomial) | 3 | 1 | 3 | 3 |
| Polynomial.pow(BigInteger) | 4 | 1 | 3 | 3 |
| Polynomial.substitute(Polynomial) | 1 | 1 | 2 | 2 |
| RecurFunc.RecurFunc(int, Factor, int, BigInteger) | 0 | 1 | 1 | 1 |
| RecurFunc.recurCalc() | 3 | 3 | 2 | 4 |
| RecurFunc.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| RecurFunc.setSign(int) | 0 | 1 | 1 | 1 |
| RecurFunc.toPoly() | 0 | 1 | 1 | 1 |
| RecurFuncF.RecurFuncF() | 0 | 1 | 1 | 1 |
| RecurFuncF.getArg1() | 0 | 1 | 1 | 1 |
| RecurFuncF.getArg2() | 0 | 1 | 1 | 1 |
| RecurFuncF.getExpr() | 0 | 1 | 1 | 1 |
| RecurFuncF.getF0() | 0 | 1 | 1 | 1 |
| RecurFuncF.getF1() | 0 | 1 | 1 | 1 |
| RecurFuncF.getInstance() | 0 | 1 | 1 | 1 |
| RecurFuncF.getNum1() | 0 | 1 | 1 | 1 |
| RecurFuncF.getNum2() | 0 | 1 | 1 | 1 |
| RecurFuncF.setArg1(Factor) | 0 | 1 | 1 | 1 |
| RecurFuncF.setArg2(Factor) | 0 | 1 | 1 | 1 |
| RecurFuncF.setExpr(Factor) | 0 | 1 | 1 | 1 |
| RecurFuncF.setF0(Polynomial) | 0 | 1 | 1 | 1 |
| RecurFuncF.setF1(Polynomial) | 0 | 1 | 1 | 1 |
| RecurFuncF.setNum1(BigInteger) | 0 | 1 | 1 | 1 |
| RecurFuncF.setNum2(BigInteger) | 0 | 1 | 1 | 1 |
| Select.Select(Factor, Factor, Factor, int) | 0 | 1 | 1 | 1 |
| Select.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| Select.setSign(int) | 0 | 1 | 1 | 1 |
| Select.toPoly() | 2 | 1 | 2 | 2 |
| Term.Term() | 0 | 1 | 1 | 1 |
| Term.addFactor(Factor) | 0 | 1 | 1 | 1 |
| Term.setSign(int) | 0 | 1 | 1 | 1 |
| Term.toPoly() | 5 | 2 | 4 | 4 |
| Variable.Variable(int, BigInteger, String) | 0 | 1 | 1 | 1 |
| Variable.setExp(BigInteger) | 0 | 1 | 1 | 1 |
| Variable.setSign(int) | 0 | 1 | 1 | 1 |
| Variable.toPoly() | 3 | 2 | 2 | 3 |
通过上述方法复杂度地指标我们可以得出以下结论:
类的总代码规模如下表所示:
| Class | CLOC | JLOC | LOC |
|---|---|---|---|
| Derive | 0 | 0 | 32 |
| Exp | 0 | 0 | 29 |
| Expression | 3 | 0 | 34 |
| Function | 2 | 0 | 30 |
| FunctionF | 0 | 0 | 15 |
| Input | 0 | 0 | 37 |
| Lexer | 2 | 0 | 72 |
| MainClass | 0 | 0 | 12 |
| Mono | 6 | 0 | 66 |
| Number | 1 | 0 | 20 |
| Output | 9 | 0 | 166 |
| Parser | 9 | 0 | 206 |
| Polynomia | 6 | 0 | 111 |
| RecurFunc | 2 | 0 | 62 |
| RecurFunc | 0 | 0 | 57 |
| Select | 0 | 0 | 38 |
| Term | 1 | 0 | 34 |
| Variable | 0 | 0 | 27 |
从中可以得到此次作业的总代码规模为 1000 LOC,其中 Parser 和 Output 的代码规模较大,分别为 206 LOC 和 166 LOC,这与他们的职责相关,也许我们可以考虑将他们的职责进一步细化,以降低单个类的代码规模,提高代码的可维护性。
关于各个类之间的耦合情况如下表所示:
| Class | Cyclic | Dcy | Dcy* | Dpt | Dpt* | PDcy | PDpt |
|---|---|---|---|---|---|---|---|
| Derive | 0 | 3 | 3 | 1 | 3 | 1 | 1 |
| Exp | 0 | 3 | 3 | 1 | 3 | 1 | 1 |
| Expression | 0 | 4 | 4 | 3 | 3 | 1 | 1 |
| Function | 0 | 4 | 4 | 1 | 3 | 1 | 1 |
| FunctionF | 0 | 1 | 2 | 2 | 4 | 1 | 1 |
| Input | 0 | 5 | 16 | 1 | 1 | 1 | 1 |
| Lexer | 0 | 0 | 0 | 3 | 3 | 0 | 1 |
| MainClass | 0 | 6 | 18 | 0 | 0 | 1 | 0 |
| Mono | 1 | 1 | 1 | 11 | 17 | 1 | 1 |
| Number | 0 | 3 | 3 | 1 | 3 | 1 | 1 |
| Output | 0 | 2 | 2 | 1 | 1 | 1 | 1 |
| Parser | 0 | 12 | 15 | 2 | 2 | 1 | 1 |
| Polynomia | 1 | 1 | 1 | 15 | 17 | 1 | 1 |
| RecurFunc | 0 | 4 | 4 | 1 | 3 | 1 | 1 |
| RecurFunc | 0 | 2 | 3 | 3 | 4 | 1 | 1 |
| Select | 0 | 3 | 3 | 1 | 3 | 1 | 1 |
| Term | 0 | 3 | 3 | 2 | 4 | 1 | 1 |
| Variable | 0 | 3 | 3 | 1 | 3 | 1 | 1 |
通过观察可以发现 Polynomia (被 15 个类依赖)、Mono (被 11 个类依赖) 这意味这他们的正确性将是整个项目的重中之重。
在架构简图的基础上,我通过 plantuml 对代码架构进行了分析,得到了以下结果:
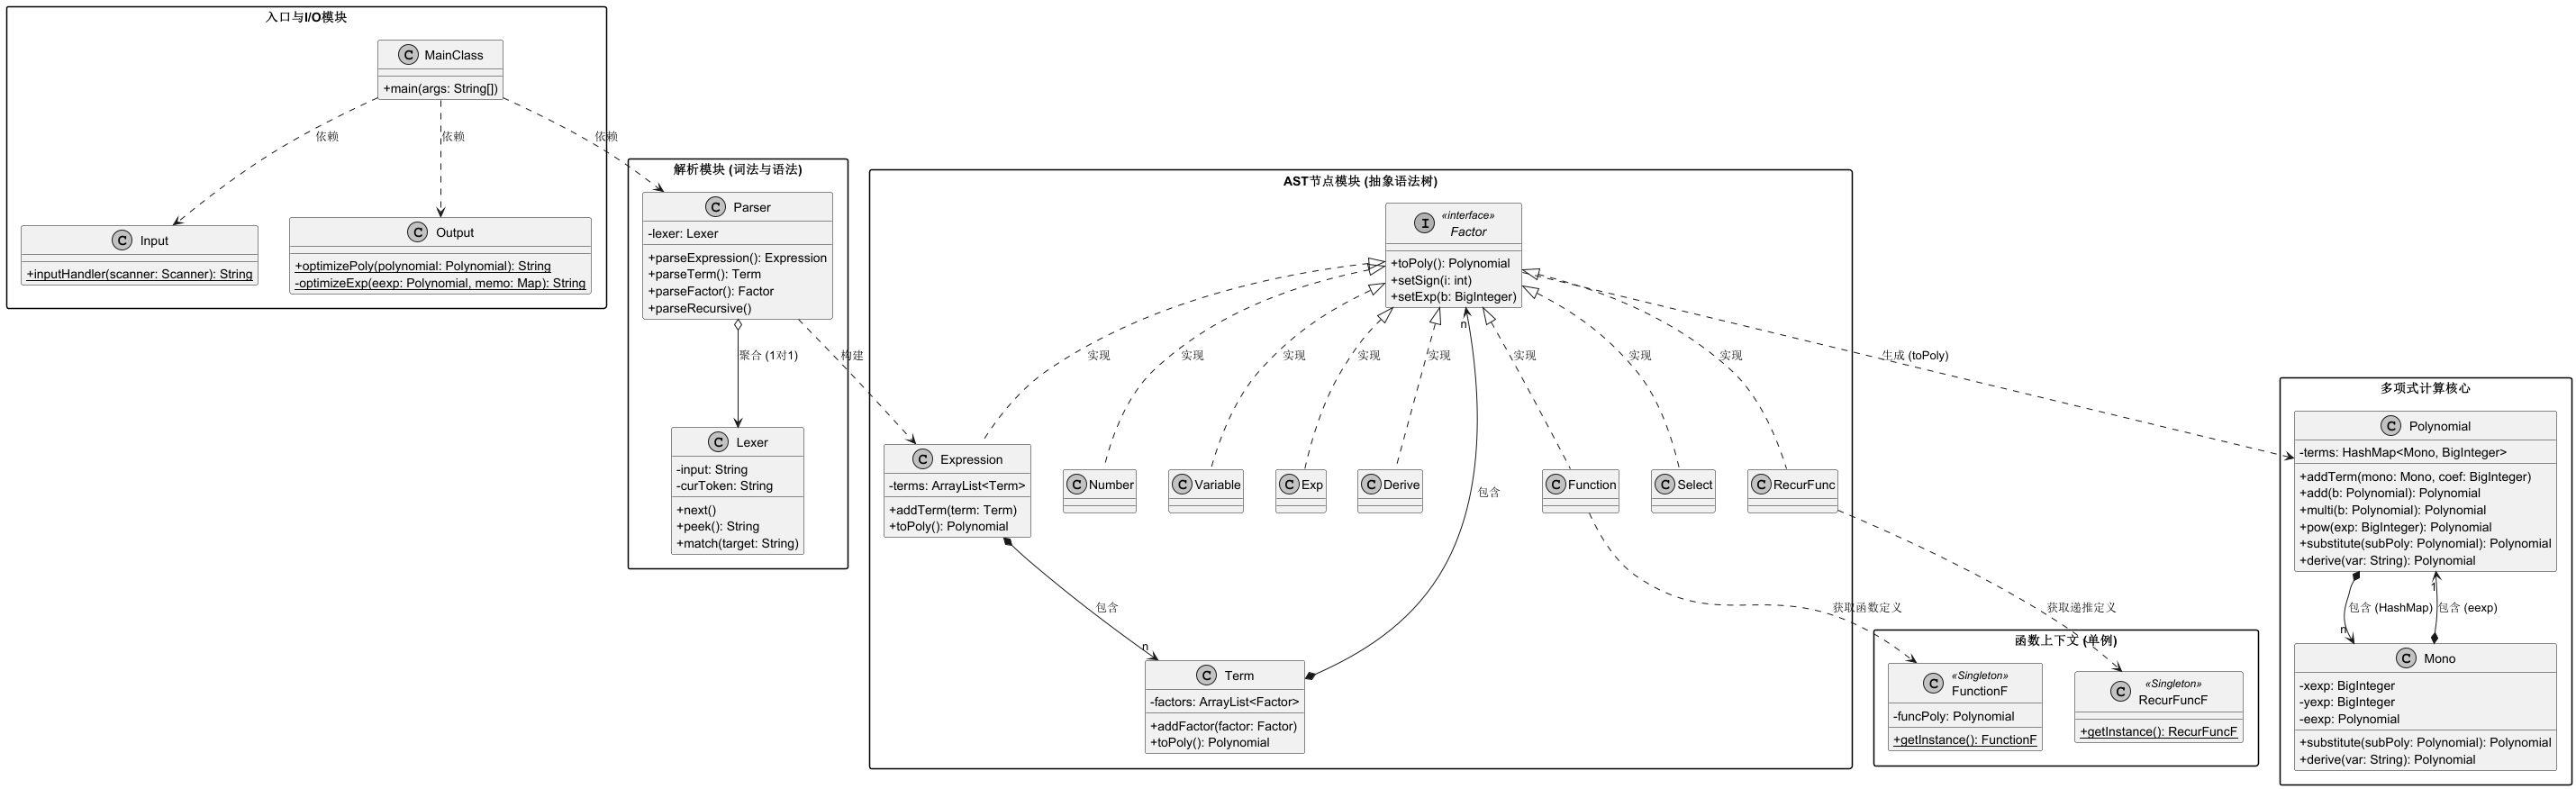
在通过度量工具分析了代码的复杂度和耦合度之后。我对自己的代码架构有了更加清晰的认识,其优缺点如下:
优点:
缺点:
在 HW1 中,我的架构设计较为简单,主要分为 lexer , parser 和 poly 三个模块,没有定义输入输出的模块,这也就导致了在第二次作业中输入输出复杂化之后不得不将这两个模块从Mainclass中提取出来,进行代码重构。
在 HW2 中,我的架构设计基本已经形成了一个较为清晰的模块划分,主要分为 词法分析,语法分析,计算,输出 四个模块。为后来 HW3 的扩展提供了很好的基础。
在 HW3 中,我只需要新增递推函数的factor和求导的factor即可,基本上没有对之前的代码进行大规模的修改,说明我的架构设计在扩展性方面表现良好。
比如在HW4中,我们需要新增一个g(x)的函数,因为之前f(x)采用了单例模式,所以我们需要将之前的FunctionF类进行重构,改成一个工厂类来管理所有的函数,这样就可以在不修改之前代码的基础上新增g(x)函数了。
我的程序bug主要集中在TLE方面,第二次作业由于在选择表达式计算过程中直接将命中和未命中的结果一起算了出来,导致了当未命中的结果复杂度极高时不必要的计算带来的TLE问题。在第三次作业中,由于exp的优化时存在方法的嵌套调用导致了递归过深,从而TLE。
针对第二次作业的问题,我只计算命中的结果:
Polynomial polyA = leftCond.toPoly();
        Polynomial polyB = rightCond.toPoly();
        Polynomial tmp = new Polynomial();

        if (polyA.equals(polyB)) {
            tmp = trueBranch.toPoly();
        } else {
            tmp = falseBranch.toPoly();
        }
针对第三次作业的问题,我将exp的优化方法进行了一些调整,改成了记忆化的方式来进行优化:
public static String optimizePoly(Polynomial polynomial) {
        Map<Polynomial, String> memo = new HashMap<>();
        return optimizePolyInternel(polynomial, memo);
    }
我的优化主要就是两点,对普通表达式将正的情况提到结果的前面,对exp内部表达式提公因式。至于对exp内部表达式的进一步详细优化个人觉得费时费力,得不偿失,没有必要。
对于第一种优化,代码如下:
for (Mono mono : tmpMap.keySet()) {
            if (tmpMap.get(mono).signum() > 0) {
                firstMono = mono;
                break;
            }
        }
对于第二种优化,代码如下:
private static String optimizeExp(Polynomial eexp, Map<Polynomial, String> memo) {
        String best = nowExp(eexp, memo);

        // 提公因式
        BigInteger commonFactor = getCommonFactor(eexp);
        // System.out.println("common factor: " + commonFactor);
        if (commonFactor.compareTo(BigInteger.ONE) > 0) {
            Polynomial newInner = divideByCommon(eexp, commonFactor);
            String result = nowExp(newInner, memo) + "^" + commonFactor;
            if (result.length() < best.length()) {
                best = result;
            }
        }
        return best;
    }
| idx | 正确性 | 性能 |
|---|---|---|
| 1 | 20% | 5% |
| 2 | 20% | 10% |
| 3 | 0% | 0% |
此外,大模型还主要用于辅助我搭建评测机,以及对我的项目架构提出建议等方面。大模型搭建的评测机主要还是在于要让大模型清晰的理解标准的输入格式,这一点可以让他根据我们自己的代码来学习。在项目架构的改进建议方面大模型确实对我帮助很大,有效地避免了后续的代码重构。
通过这个单元的学习,我最深刻的体会主要有两个方面:
也许可以更显式地引导同学们的代码架构设计,避免后续的重构。

