


309
社区成员
 发帖
 与我相关
 我的任务

 分享
第一单元的三次作业,我们从一个简单的表达式解析化简开始,逐步迭代到支持自定义函数、指数函数、选择表达式、二元变量、递推定义以及求导因子。整个过程中,我深刻体会到了面向对象设计在应对需求变化时的优势,也踩了不少坑。这篇博客将对我的程序结构进行度量分析,总结架构设计经验,反思 bug 与测试策略,并谈谈这一单元的学习心得。
项目总代码行 1221 行,其中源码 1087 行,空行 134 行。
总圈复杂度(WMC)248,平均每个方法复杂度 2.28,平均类复杂度 12.40。
整体结构清晰,大部分类的复杂度较低,少数核心类承担了较多职责。
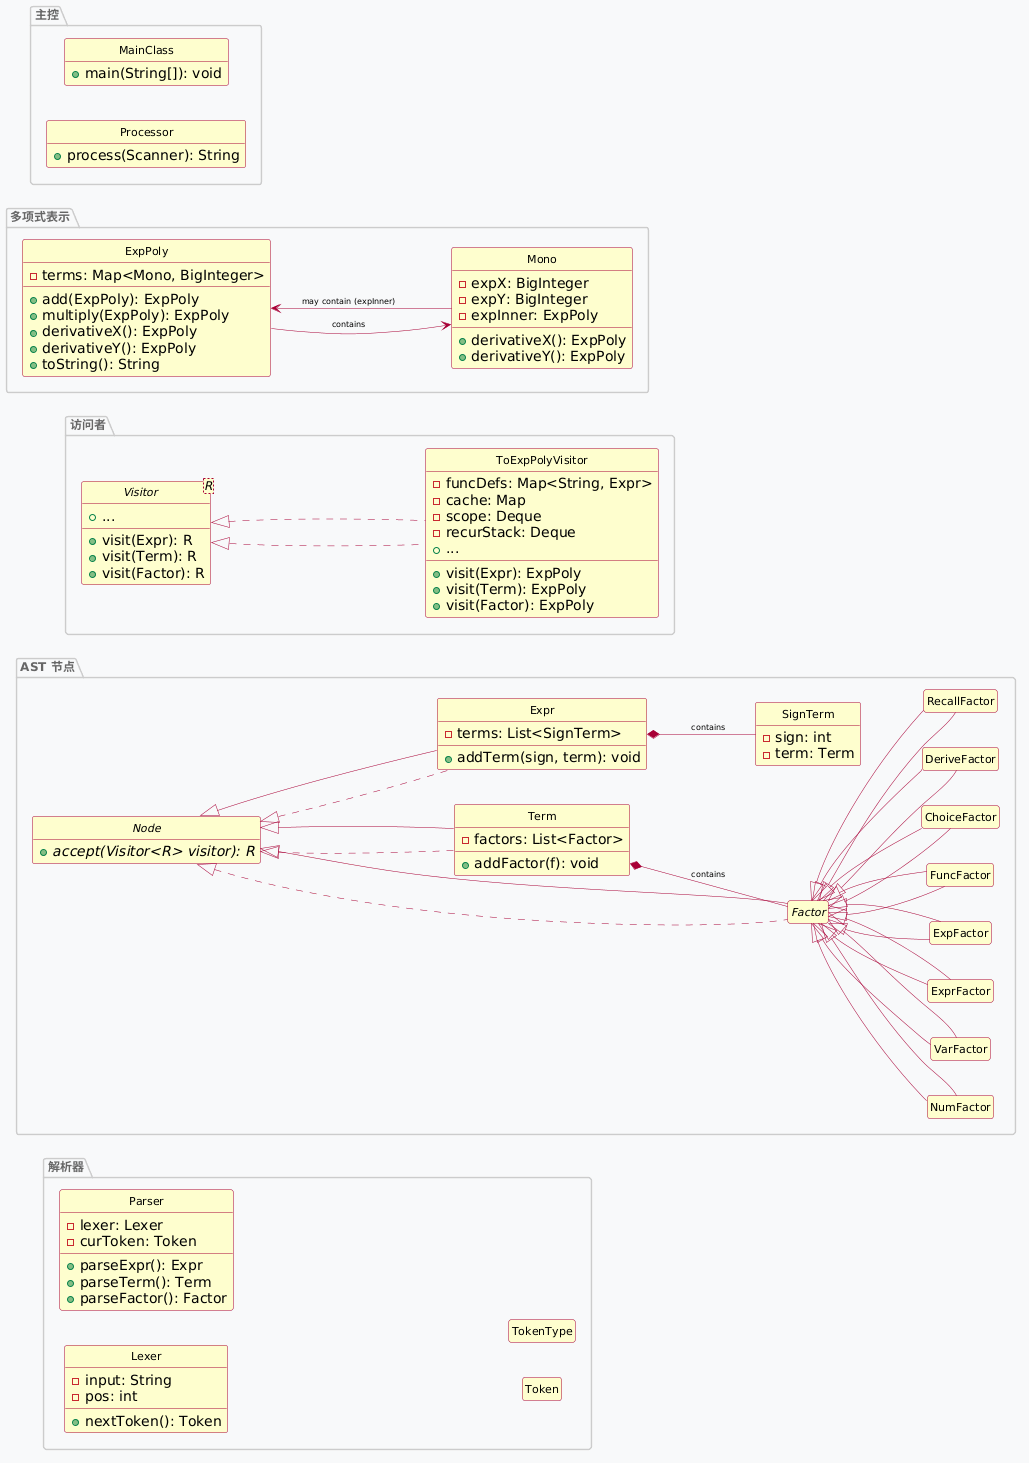
设计说明:
优点:
缺点:
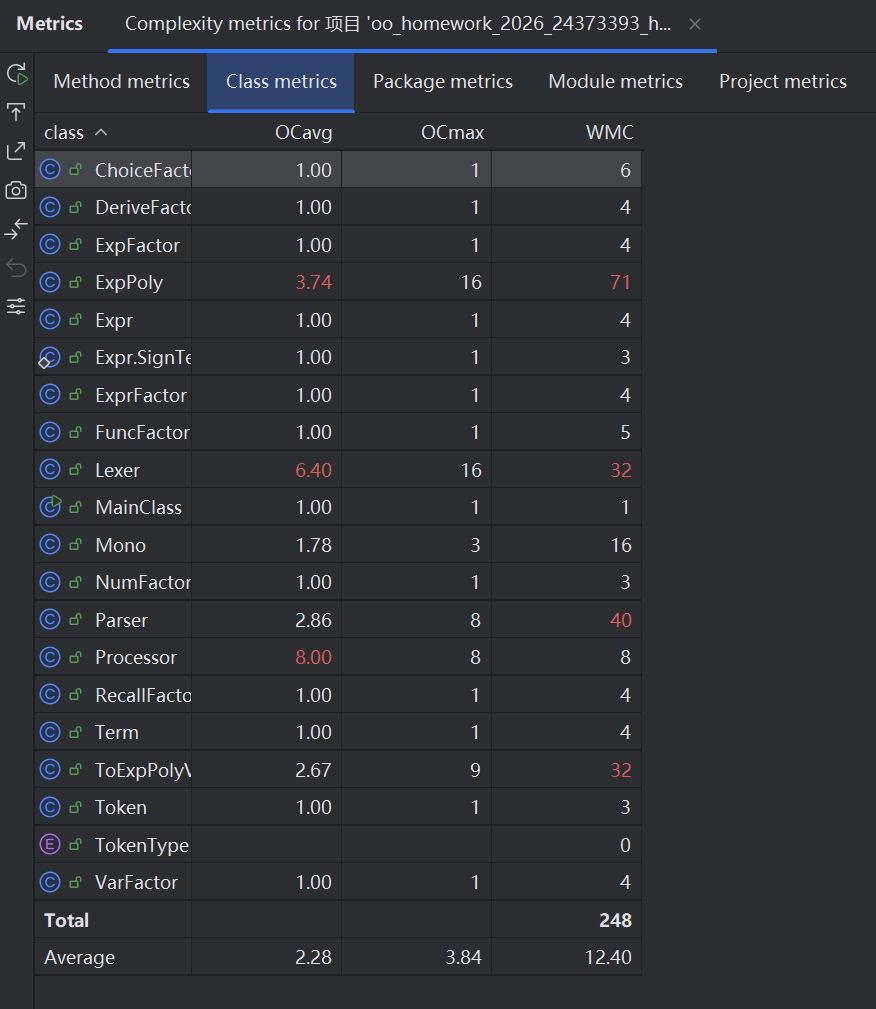
其中有一些类复杂度较高的原因分析如下:
| 类 | 平均复杂度 (OCavg) | 最大复杂度 (OCmax) | 总复杂度 (WMC) | 说明 |
|---|---|---|---|---|
| ExpPoly | 3.74 | 16 | 71 | 核心多项式类,复杂度最高,toString、multiply 方法中分支较多 |
| Lexer | 6.40 | 16 | 32 | 词法分析,长分支判断导致复杂度偏高 |
| Parser | 2.86 | 8 | 40 | 递归下降解析,分支适中 |
| ToExpPolyVisitor | 2.67 | 9 | 32 | 访问者实现,函数展开和缓存逻辑稍复杂 |
| Processor | 8.00 | 8 | 8 | 仅一个方法,但包含多段逻辑(定义解析、主表达式解析) |
改进思考:
toString 方法可以拆分为单独的输出类,降低维护难度。NextToken 方法中大量 if-else 分支,也许可以考虑用状态机或查表优化?但目前的复杂度还是可以接受的。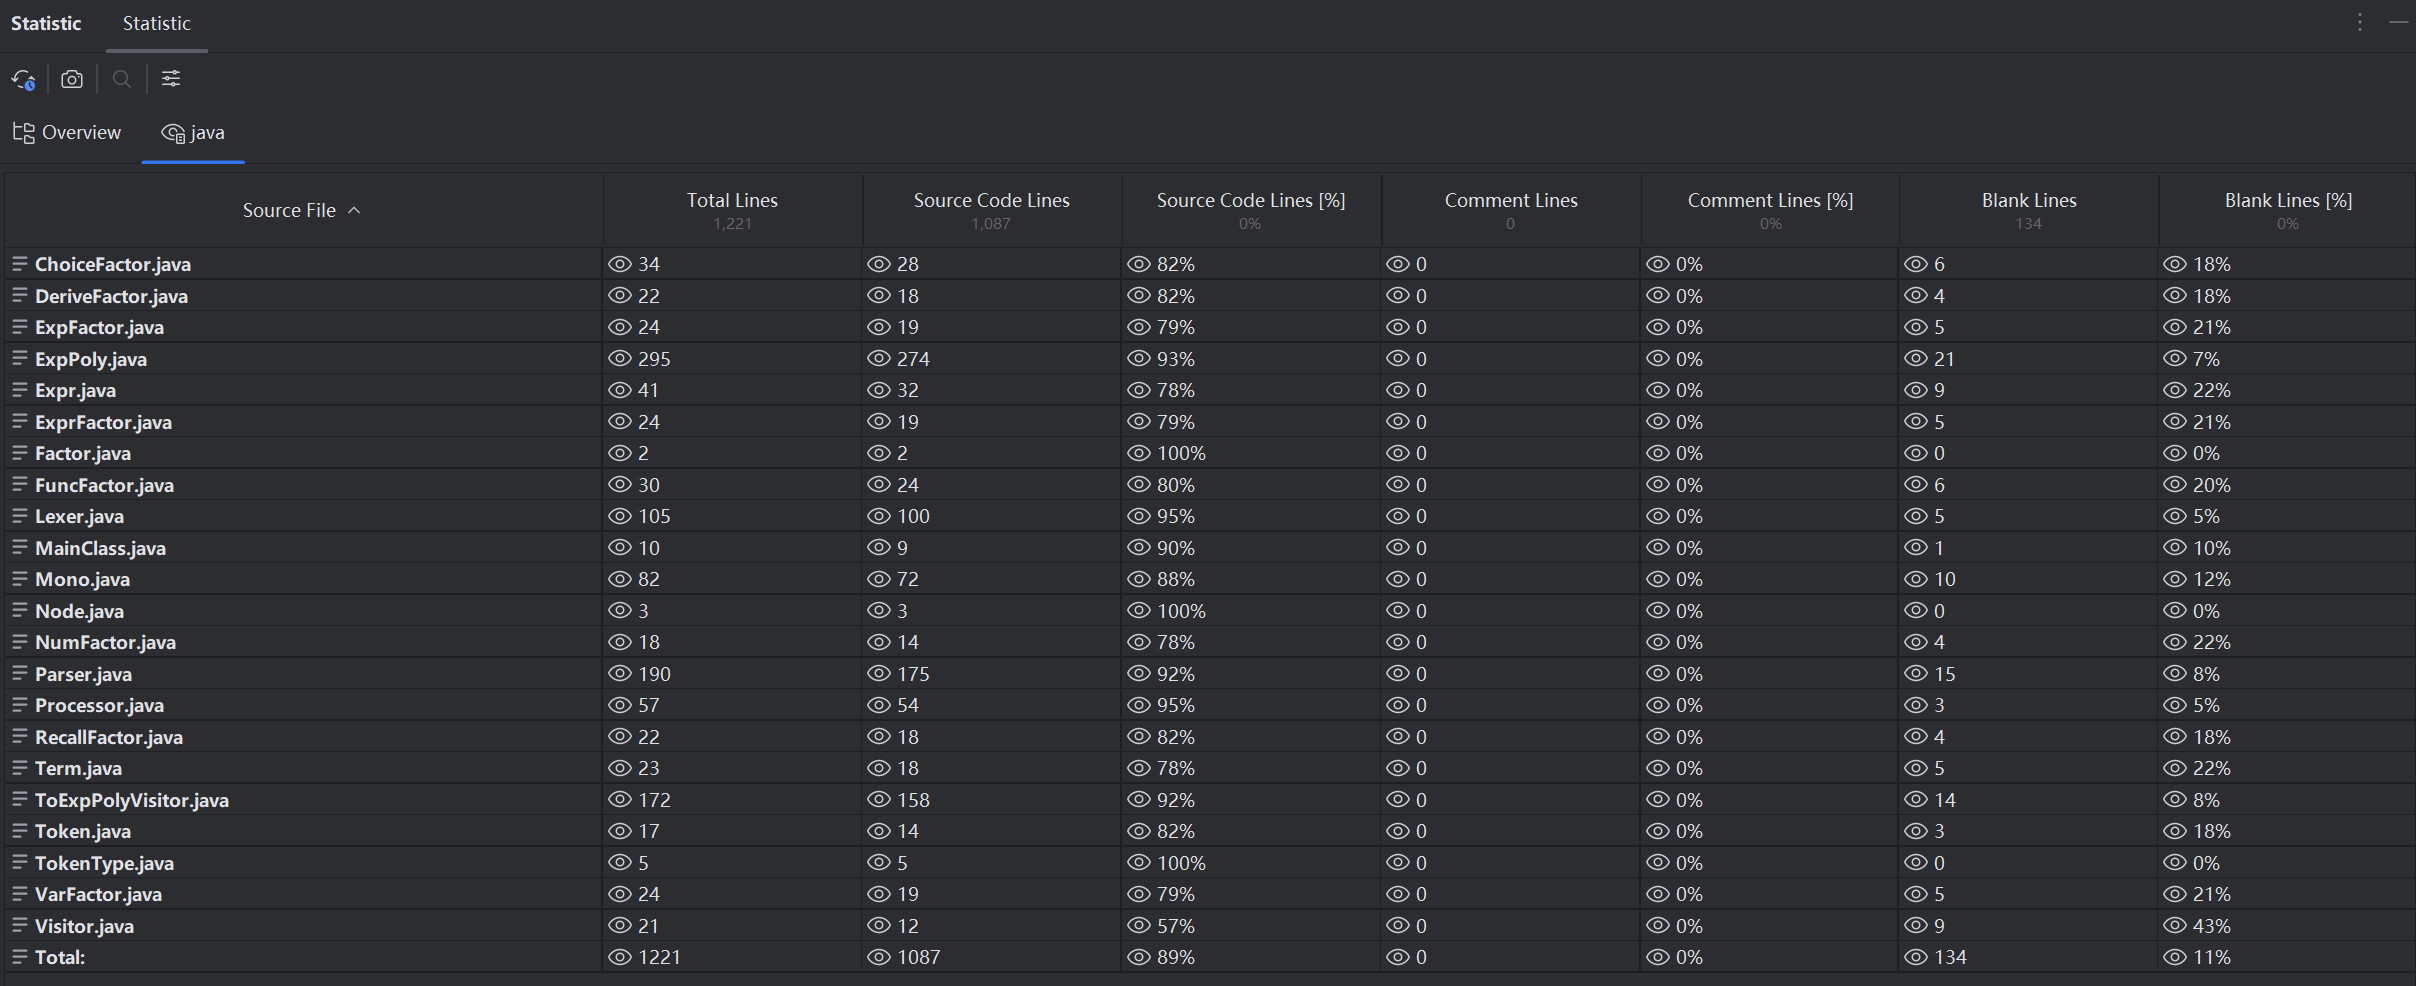
ExpPoly 是代码量最大的类,占据项目源码的 25%,因为多项式表示与运算模块是整个系统的核心。Parser 和 ToExpPolyVisitor 规模适中,职责明确,未过度膨胀。Factor 子类(如 NumFactor、VarFactor)规模均在 20 行左右,小巧内聚。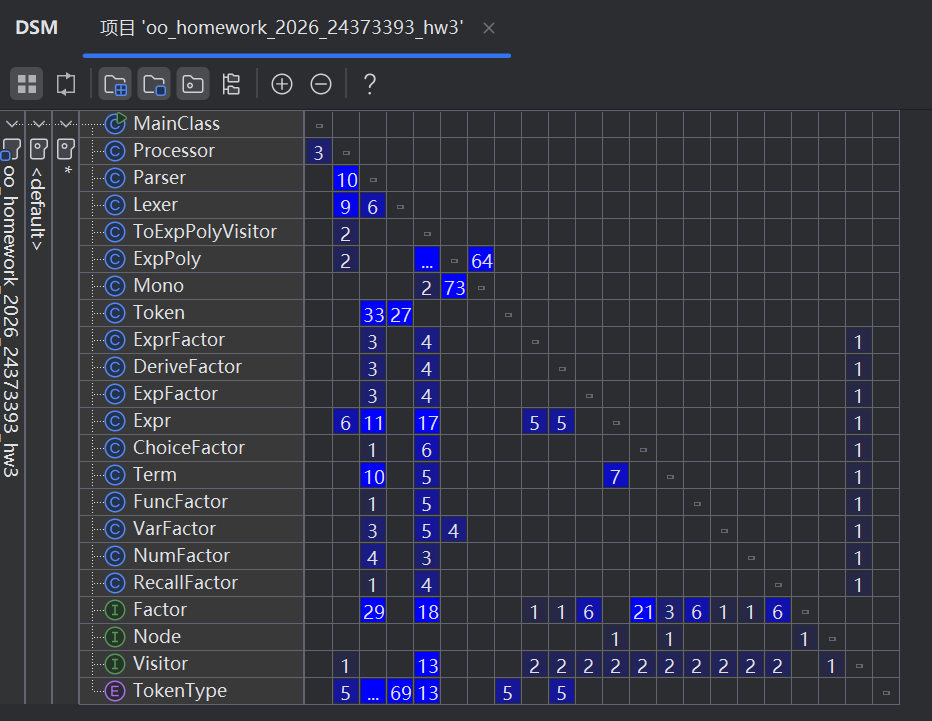
分析发现:
ExpPoly 被 ToExpPolyVisitor、Mono、Processor 等类依赖,是系统的核心数据模型,耦合度高但合理,因为它承担了多项式运算的核心职责,其他模块依赖它是必要的。ToExpPolyVisitor依赖几乎所有 Factor 子类及 Expr、Term,符合访问者模式的设计预期,属于“可控耦合”,便于扩展。Token被 Lexer、Parser 共同依赖,作为词法与语法分析的桥梁。总的来说,复杂度方面,虽然核心类(ExpPoly)复杂度偏高,但其余类控制良好,平均复杂度 2.28 表现较好;代码规模方面,总源码 1087 行,核心模块集中,扩展类保持轻量;在耦合与内聚方面,访问者模式带来了合理的耦合,各 Factor 类内聚性好,ExpPoly 职责稍多但可接受。最大的可优化点是将ExpPoly中的toString方法拆分为单独的输出类。
第一次作业(多项式合并化简)
仅支持 x 的幂函数、常数、表达式因子,支持加减乘和幂运算。我采用了经典的递归下降解析方法,将表达式解析为 AST,然后通过Expr,Term,Factor各类中的 toPoly 方法转化为多项式,进行运算,最后输出化简后的结果。当时 Poly 只支持单变量,单项式中仅有 expX 字段。
第二次作业(引入自定义函数、指数函数、选择表达式)
新增了 exp 函数、自定义函数调用和选择表达式 [ (cond) ? true : false ]。
此时因子种类增多,我想到能不能将AST中各个Node的toPoly方法集中在一起?这样便于我集中处理转化为多项式的过程,也能降低现有类的复杂度。于是通过查阅资料,我对代码进行了重构,引入了访问者模式,建立了Visitor接口以及实现该接口的ToExpPolyVisitor类。
Processor 中预先读取定义,ToExpPolyVisitor 中维护一个 Map<String, Expr>,遇到函数调用时替换参数(通过作用域栈 scope 实现)。Poly重构为ExpPoly,引入单项式Mono类,其中包括 expX 字段和 expInner 字段,后者用于表示 exp(...) 的嵌套。visit(ChoiceFactor) 中计算两个条件表达式,若相等则取真分支,否则取假分支。此时架构开始体现扩展性:新增因子只需添加新类并在 Parser 和 Visitor 中增加对应处理,原有 ExpPoly 的运算逻辑几乎不需改动。
第三次作业(增加变量 y、递推表达式、求导因子)
y:给单项式的Mono 增加 expY 字段,ExpPoly 中的乘法、求导、输出都需要修改,但得益于封装,改动范围有限。f{n-1} 和 f{n-2} 形式的调用,对应 RecallFactor。我通过 Deque<Integer> recurStack 记录当前递归深度,在 expandFunc 中根据偏移量查找对应的函数定义(f{1} 或 f{2})。dx(...)、dy(...)、grad(...) 被解析为 DeriveFactor,在 visit 中调用 ExpPoly 的导数方法。在整个过程中,我始终没有重构核心数据结构,而是通过增加字段和扩展方法的方式应对变化。访问者模式使得新操作(如求导)的添加变得容易,但 ExpPoly 内部逻辑随着功能增加而变得复杂,此时重构也变得困难,这是需要权衡的地方。
假设未来增加“三角函数”因子(如 sin(factor)),我的设计可以这样扩展:
SinFactor 类实现 Factor,并在 Visitor 中增加 visit(SinFactor) 方法。ExpPoly 需要增加 sin 的表示方式,可能需要在 Mono 中增加 sinInner 字段,并在多项式运算中处理其展开和合并规则。虽然复杂度会上升,但可以顺利实现。公测阶段
统计出现 Bug 的方法的圈复杂度:
ExpPoly.multiply:圈复杂度 8(多个循环和条件)ToExpPolyVisitor.expandFunc:圈复杂度 7(嵌套条件与异常处理)ExpPoly.toString:圈复杂度 12(大量的 if-else 分支)Factor 的 accept)圈复杂度均为 1。这说明高复杂度方法更容易隐藏错误。当我们为了提高性能得分(指第一单元的输出长度)而主动提高复杂度时,也给我们的程序留下了隐患。这让我意识到,优化应当建立在清晰的设计和可维护性之上,盲目追求极致优化可能适得其反,这也是老师多次提及的。另外,我体会到,复杂度更低的方法,修复起来更加容易,修改篇幅也更小。
降低复杂度的思路:
multiply 中的合并逻辑可以提取为独立方法 mergeTerm。在b房间时,我的策略主要是下载同房间同学的代码,尝试找出逻辑上的漏洞。在第二次作业互测中这个策略发挥了很大的作用,而且我发现找出一个bug后,往往同房间多个同学存在相同的问题。但是在第三次作业中,我发现a房间同学的代码基本不存在明显的bug,只能通过构造极端样例,对程序的复杂度进行测试(虽然没有成功而且自己被hack了…)。
ToExpPolyVisitor 对每个函数名维护一个 Map<ExpPoly, ExpPoly>,避免重复展开同一参数下的函数。这在递推函数中效果显著,避免指数级重复计算。ExpPoly.pow 采用二进制指数算法,将时间复杂度从 O(n) 降至 O(log n)。(虽然好像有同学提出不一定更快?)ExpPoly.toString 中,对于 exp(inner) 若 inner 的系数有公因数,则提取出来写成 exp(inner/g)^g 的形式,减少了字符串长度,有利于提高性能得分。我的优化均基于等价变换,且通过了测试的验证,能较好地保持正确性。例如缓存不会改变结果,快速幂与直接乘等价。输出优化只改变表现形式,不影响语义。
但是优化过程中并没有做到简洁,显著地提高了程序的复杂度,带来了潜在的问题。
在第一次作业中,因为要实现从无到有的搭建,我耗费了较多时间,在此过程中我不断让大模型举例说明如何用递归下降法解析表达式。在后两次作业中,大模型也帮我设计了用栈来解决函数调用的问题。我认为大模型的优点是知识很全面,我们可以在对话中很迅速地学到java中的一些语法和设计模式,并判断出哪些更适合运用到我们的架构中。但是在少数情况下,大模型有“过度设计”之嫌,代码的复杂度往往更高。
在测试方面,我每次都会让大模型帮我生成尽可能全面的样例来测试我的程序,也会让大模型帮我检查互测房间其他同学的代码。一般情况下它能比较好地检查出逻辑错误,但是复杂度、优化方面提出的方案却不尽人意,也很难针对复杂度构造出极端样例。
我暂时未发现互测房间的同学有明显使用AI生成代码的现象。
通过三次迭代,我真正体会到了好的架构带来的好处和“开闭原则”的价值。访问者模式让我能够在不修改已有类的情况下添加新功能,每次迭代只需新增类和对应的 visit 方法。虽然最初理解访问者模式有些吃力,但一旦掌握,代码的扩展性变得非常清晰。
在学习这单元之前,我其实并不太关注复杂度,觉得只要保持正确性就可以了。但是一方面,这单元的代码体量比较大,如果我们不控制复杂度,可能会导致代码可读性非常差,调试修复也非常困难(bug修复时难以达到5行以内的要求);另一方面,复杂度太高的代码会留下可乘之机,更容易出现TLE,RE的bug。所以我们在编写程序的过程中有意识地控制复杂度是非常有必要的。
我认为第一单元的内容对我们的挑战比较大,但总体来说目前第一单元的课程设置已经比较好。

