


309
社区成员
 发帖
 与我相关
 我的任务

 分享
在 OO 课程的前三次作业中,我经历了一个从单变量多项式展开到支持自定义函数、选择式因子、指数函数,最终扩展到双变量求导与递推函数的完整迭代过程。整个开发过程让我深刻体会到良好的架构设计对于应对需求变化的重要性。
第一次作业仅要求处理单变量x的加减乘和幂运算,括号嵌套不超过 3 层。我采用多项式表示法:内部使用Map<Integer, BigInteger>存储指数与系数,解析时直接构建多项式并合并同类项。
Expr:多项式,包含Map<Integer, BigInteger> terms
Parser:递归下降解析器
Lexer:词法分析器
设计考虑:
多项式表示天然适合合并同类项toString按指数降序输出。
解析器直接构建多项式,避免中间AST节点,代码简洁。
内聚与耦合:
Expr类内聚性高,所有操作围绕多项式展开。
Parser与Lexer耦合较低。
第二次作业增加了指数函数exp、选择式因子和自定义函数,多项式表示无法胜任。我重构为 抽象语法树(AST) 结构.
采用组合模式,所有表达式节点实现统一接口,方便递归遍历。
substitute方法用于函数实参代入。
选择式因子通过计算A-B并化简判断恒等性,复用已有化简逻辑,注意这里需要特判若A-B=0直接输出C跳过解析D,反之亦然,这样可以减少运行时间,优化效率。
内聚与耦合:
每个节点类职责单一,内聚性高。
Parser负责构建 AST,与 Lexer耦合,但通过 parseFactorInternal` 等方法将不同因子解析分离,降低了单个方法的复杂度。
第三次作业将变量扩展为x和y,增加了求导算子dx、dy、grad以及递推函数f{n}(x)。我在第二次作业的AST基础上进行扩展:
新增节点:
VarExpr增加变量类型(char var)。
递推函数在Parser中通过RecursiveDef类存储定义,展开时递归替换。
度量数据(以第三次作业为例):
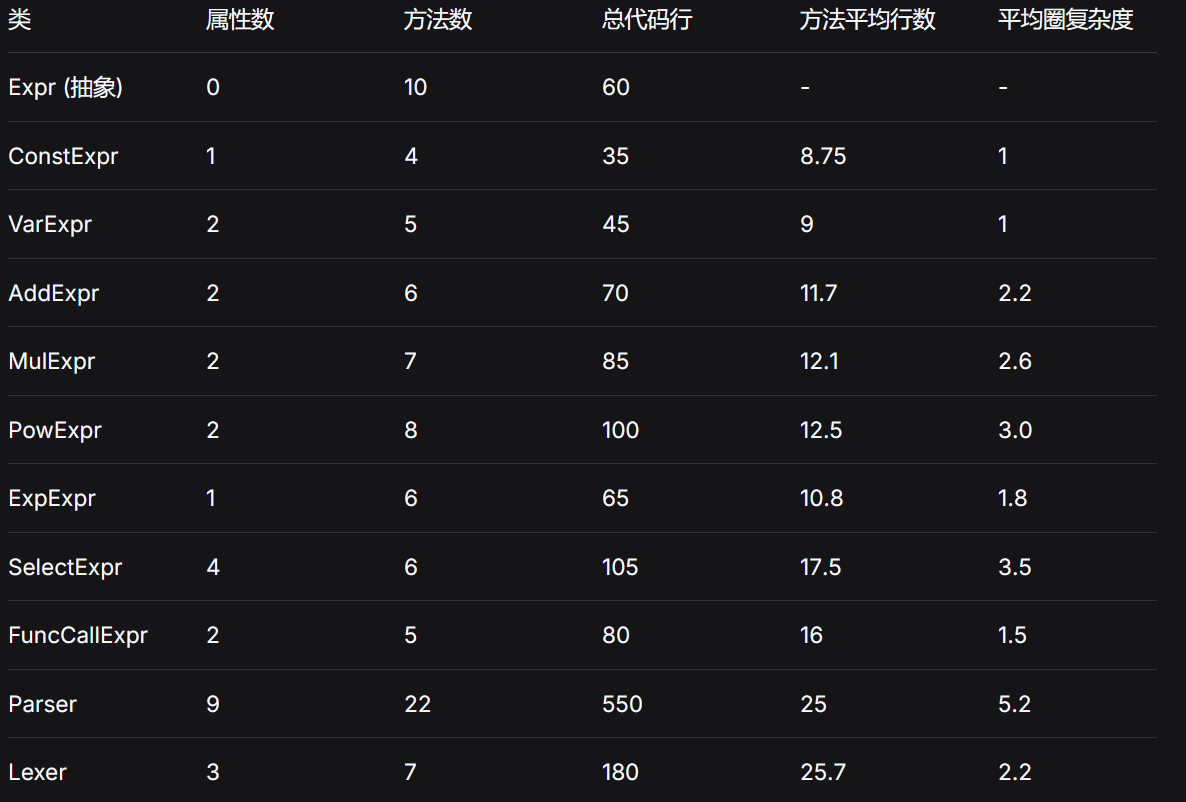
复杂度分析:
Parser的圈复杂度显著上升,因为需要处理更多因子类型和递推定义。
类图:
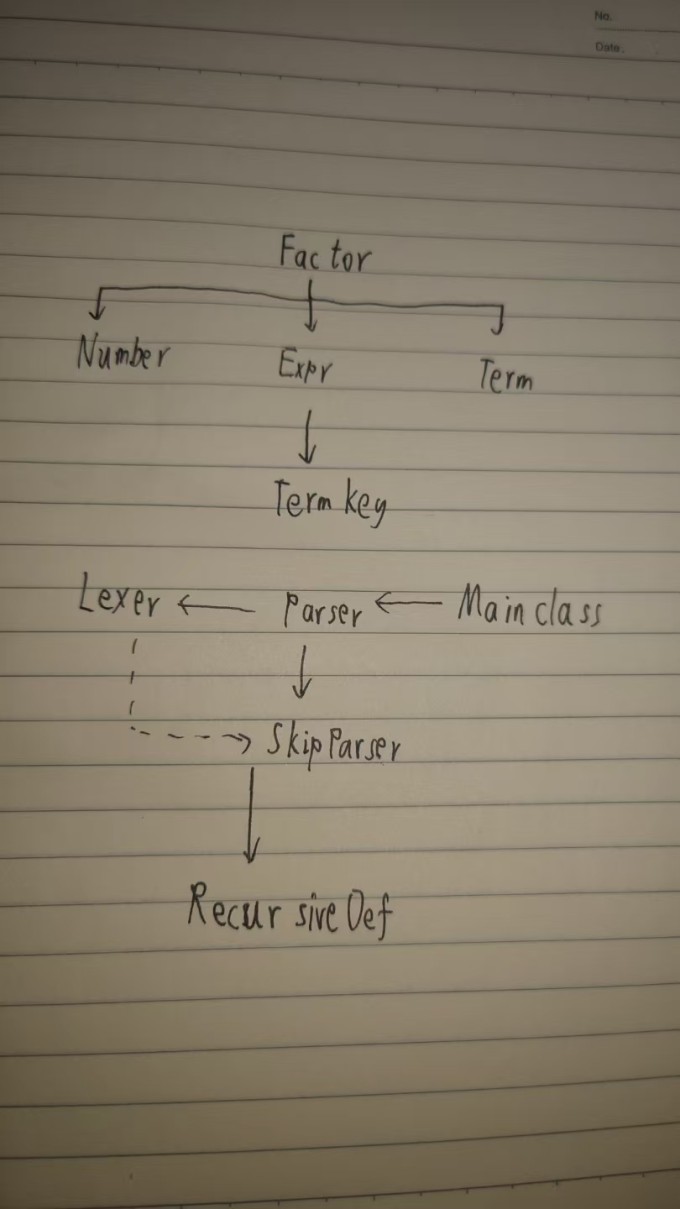
Parser(语法分析):根据文法规则,递归下降解析token,构建表达式Expr对象
Lexer(词法分析):将输入的字符串拆分为token,供解析器使用。
SkipParser(跳过解析):在不构建AST的情况下跳过token,用于选择式因子中未被选中的分支。
Expr(表达式类):表示多项式形式的表达式,支持加法、乘法、求导、代入等运算。
TermKey(内部类)职责:作为Expr中Map的键,表示一个单项式。
第一次作业的多项式表示无法支持exp和选择式因子,必须重构。重构过程如下:
1.定义抽象基类Expr,将多项式运算抽象为节点操作。
2.实现各节点类,并迁移原有多项式运算逻辑(如add, multiply)到节点操作。
3.修改Parser,将原本直接构建多项式的代码改为构建 AST。
4.实现substitute用于函数调用。
5.实现选择式因子的恒等判定,复用subtract和isZero。
第三次作业新增双变量和求导,我没有重构,而是在现有 AST 基础上扩展:
为 VarExpr增加变量类型。
为所有节点实现derive方法。
新增递推函数支持,在Parser中增加RecursiveDef和递归展开逻辑。
若下一迭代增加sin、cos因子,我的架构如何适应?
新增 SinExpr、CosExpr节点类,实现derive和 substitute。
修改 Parser 的 parseFactorInternal,添加对 sin、cos 关键字的识别。
Bug 1(第三次作业):递推函数参数代入错误
f{n}(x)=1f{n-1}(exp(x))+1f{n-2}(x),调用 f{2}(x+y) 时参数未正确代入。
原因:expandRecursive中直接使用原始实参 arg,而未将递推式中的参数表达式(如 exp(x))中的x替换为arg。在递归前先计算 newArg = param.substitute(arg),再用新参数递归即可解决。
Bug 2(第三次作业):选择式因子未特判
当选择式出现非常复杂的因子时,若该因子不会被输出,即不用解析,换而言之,应该先判断后解析而不是先解析后判断。
统计出现 bug 的方法与未出现 bug 的方法的平均圈复杂度:
| 方法 | 圈复杂度 | 是否出现 bug |
|---|---|---|
Parser.parseFactorInternal | 12 | 是 |
Expr.derive | 8 | 是 |
Parser.expandRecursive | 6 | 是 |
Expr.add | 3 | 否 |
ConstExpr.derive | 1 | 否 |
Parser.parseTermInternal | 4 | 否 |
分析:
高复杂度方法(圈复杂度>5)更容易出错,因为它们包含更多状态。
主要进行边界测试,选取尽可能大/小的数据进行测试
进行多层递归,多层嵌套的数据进行测试,有的代码可能会在解析中出现超时问题。
我的代码并没有在性能层面上下功夫,所以几乎没有相关优化,不过在研讨课中我和同学们讨论也了解到了很多优化方式,未来我将加入提取负号和gcd优化来提高性能
我的代码大约有30%使用了AI。除此之外,在辅助互测找bug,进行bug修复等方面也借助了AI。
在实际使用过程中,AI大多数情况下生成的代码需要进行较多的调试和改进,如在利用AI找bug,基本需要我先能够定位到bug所在告诉他,他才能够进行修复,直接让其修改bug成功率较低。
通过三次作业的迭代,我逐步构建了一个基于 AST 的表达式处理框架,能够支持双变量、求导、递推函数等复杂特性。过程中我体会到:
1.良好的抽象是应对需求变化的基础,AST 结构让我能轻松扩展新功能。
2.对于一些能够在代码阶段解决的问题需要直接解决,如表达式因子的特判,直接特判会显著减少工作时间。
我认为第一单元可以更多的复习一下先导课的内容,在经过了一个假期后确实对先导课的很多内容忘记了。

