


309
社区成员
 发帖
 与我相关
 我的任务

 分享
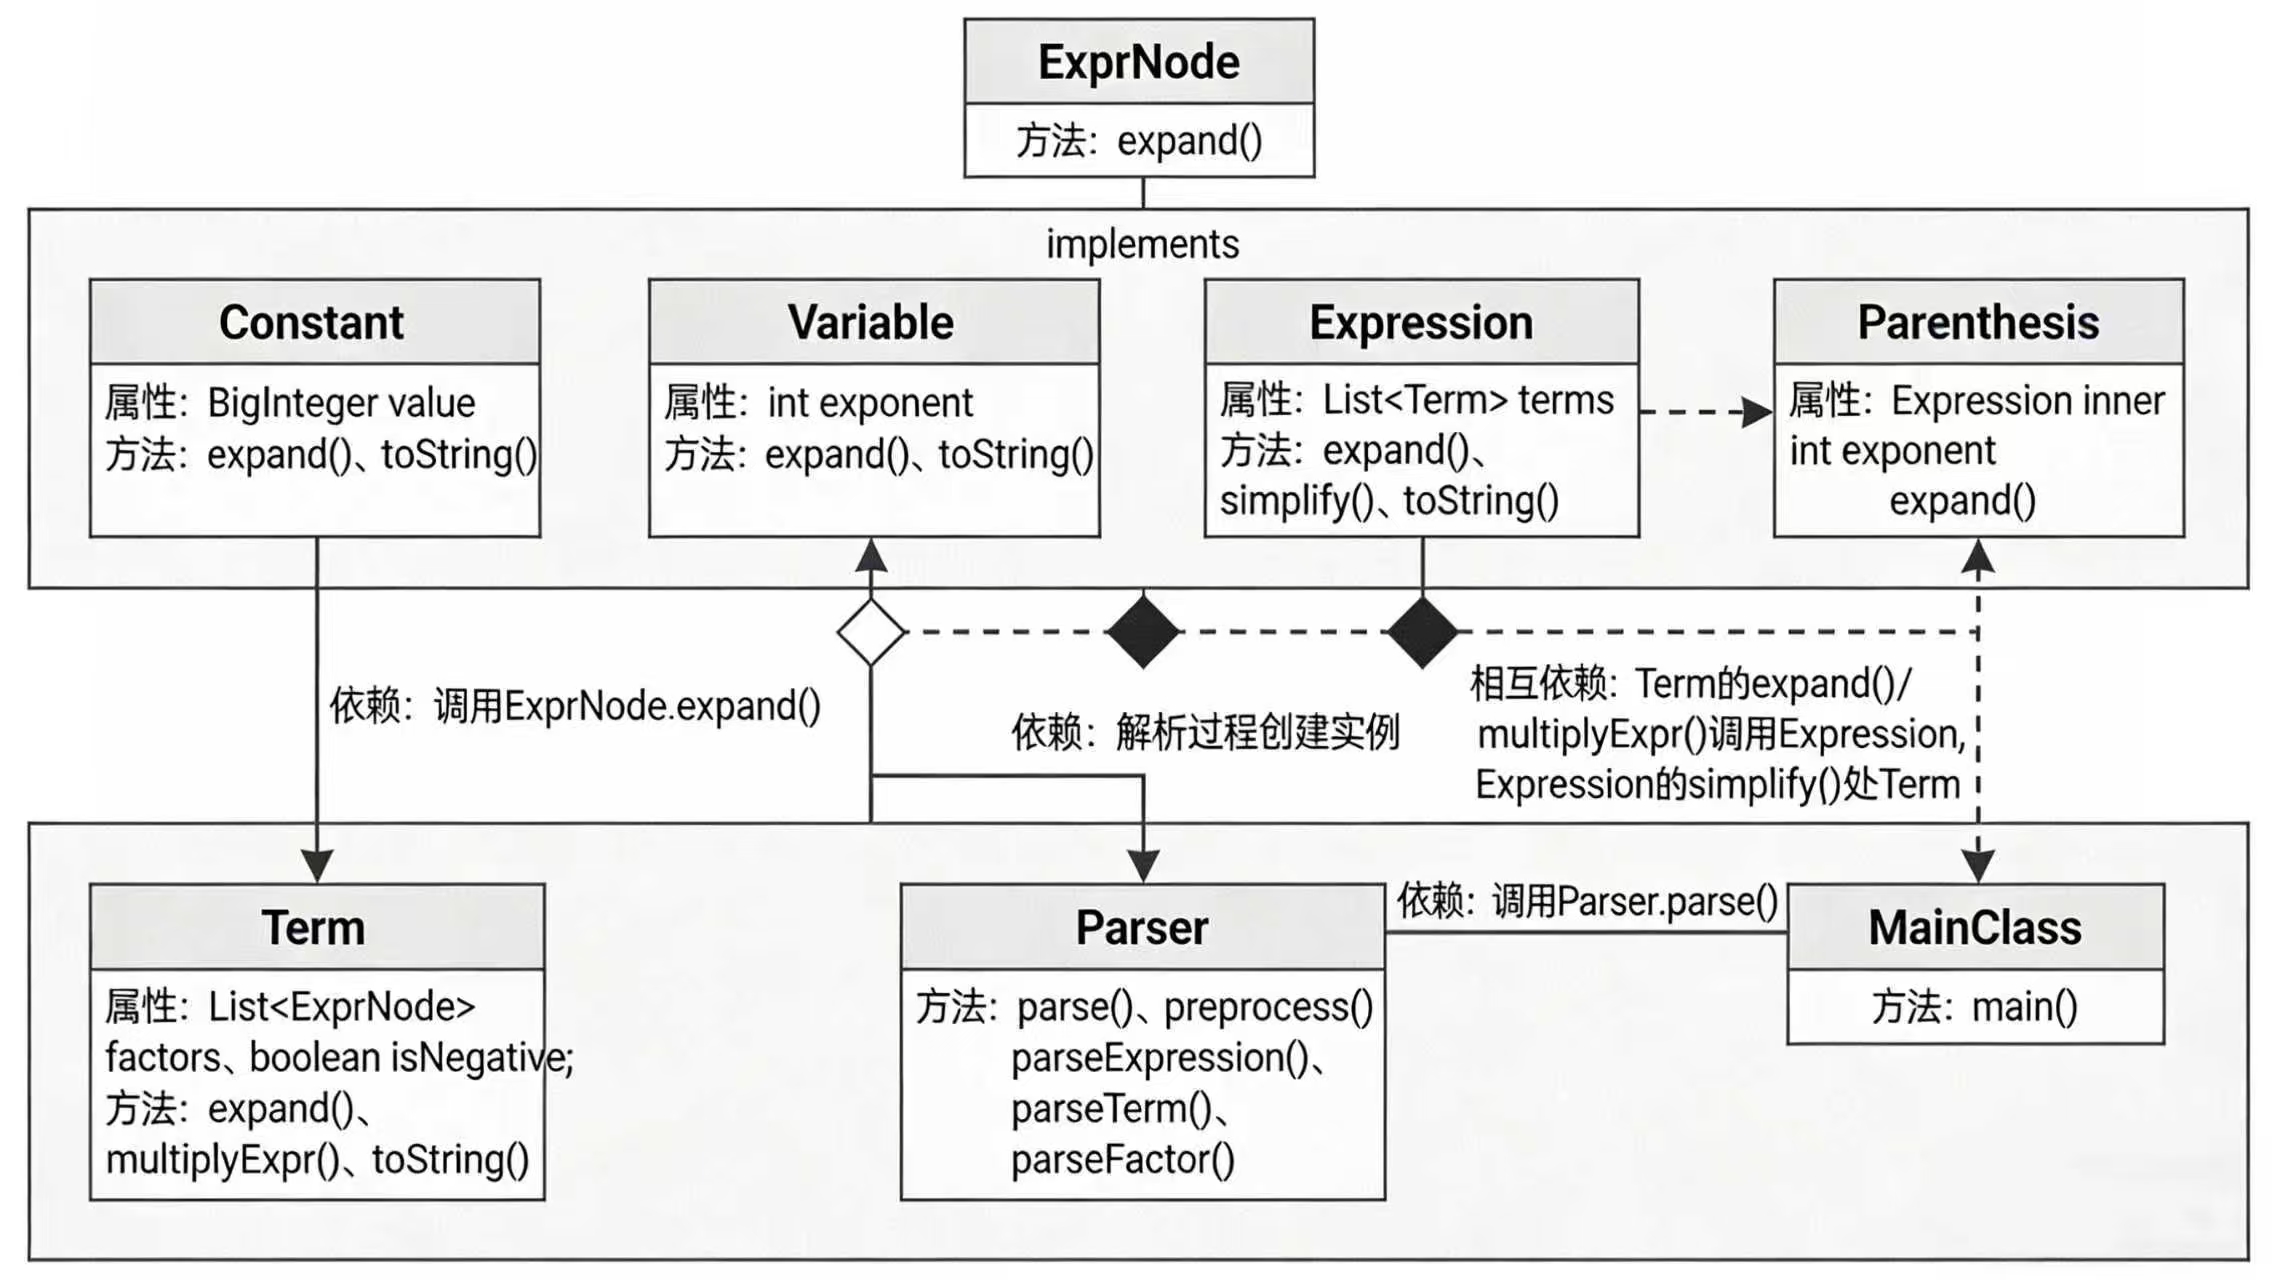
| 类名 | NOA | NOM | CLOC | WMC | CBO | TCC | CCC |
|---|---|---|---|---|---|---|---|
| Parenthesis | 2 | 3 | 44 | 8 | 5 | 0.8 | 0.9 |
| ExprNode | 0 | 1 | 3 | 1 | 0 | - | - |
| Variable | 1 | 4 | 29 | 4 | 1 | 1.0 | 1.0 |
| MainClass | 0 | 1 | 18 | 2 | 4 | - | - |
| Parser | 2 | 13 | 157 | 35 | 8 | 0.75 | 0.85 |
| Expression | 1 | 7 | 122 | 20 | 7 | 0.8 | 0.9 |
| Constant | 1 | 4 | 24 | 2 | 2 | 1.0 | 1.0 |
| Term | 2 | 9 | 185 | 25 | 7 | 0.85 | 0.9 |
我分析了以下结果
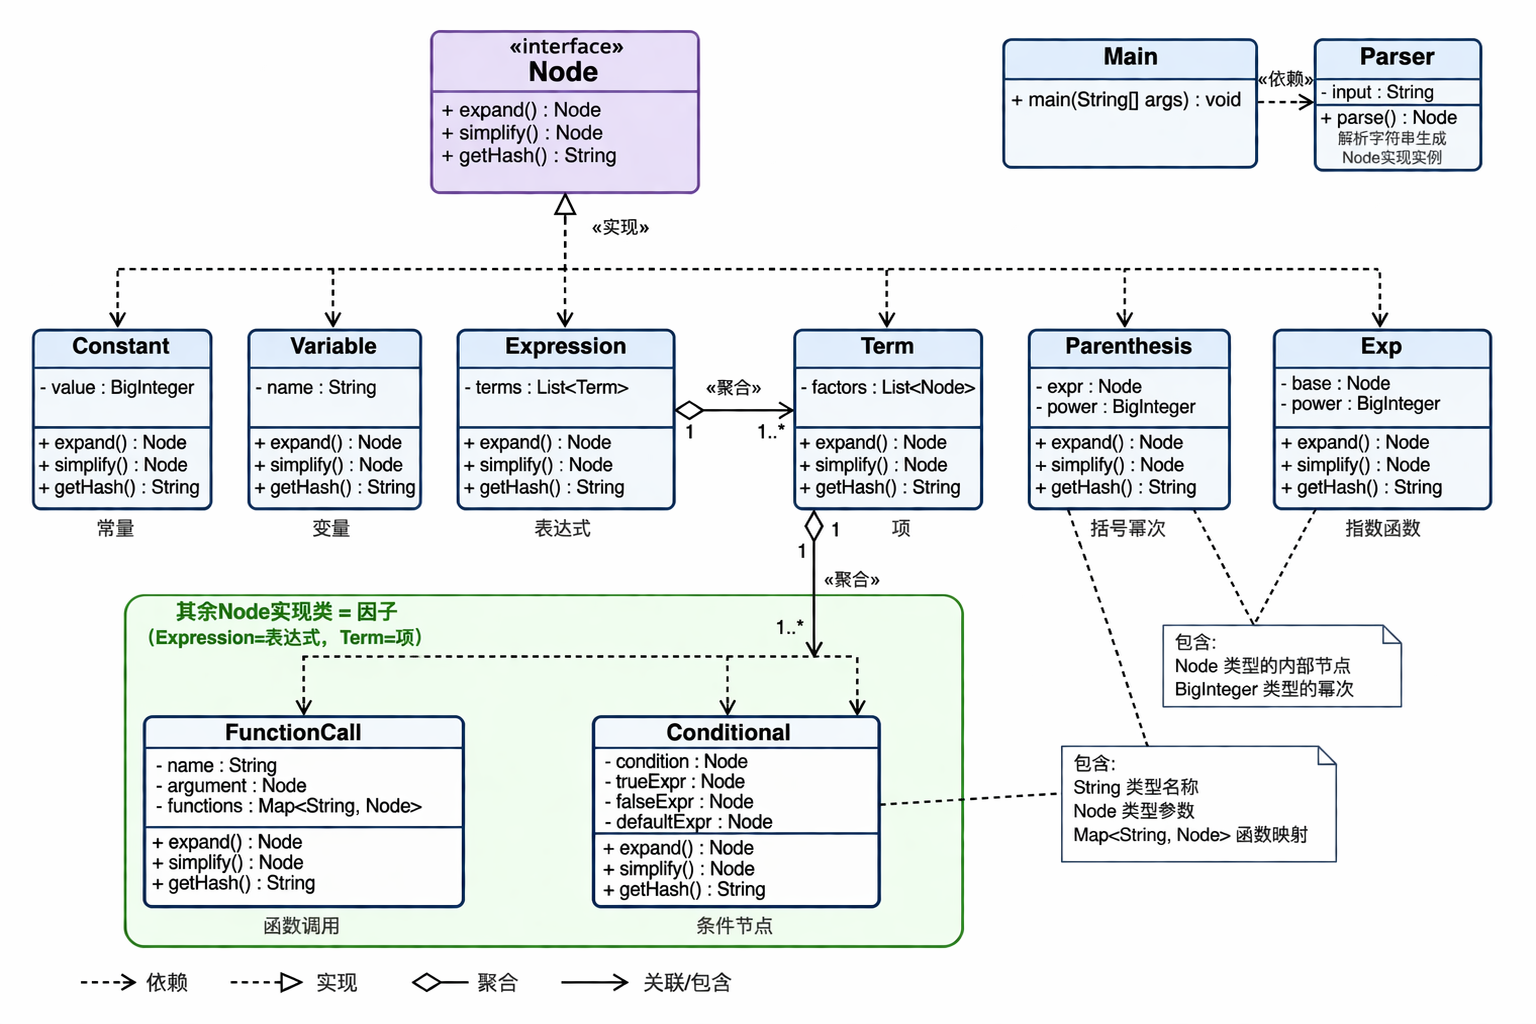
| 类名 | NOA | NOM | CLOC | CCC | WMC | CBO | TCC |
|---|---|---|---|---|---|---|---|
| Variable | 1 | 5 | 38 | 2 | 4 | 2 | 0.20 |
| Main | 0 | 1 | 17 | 4 | 2 | 4 | 1.00 |
| Expression | 1 | 6 | 63 | 6 | 15 | 7 | 0.50 |
| Conditional | 4 | 7 | 46 | 7 | 10 | 7 | 0.45 |
| Constant | 1 | 5 | 36 | 2 | 3 | 2 | 0.20 |
| Node | 0 | 3 | 10 | 0 | 0 | 0 | - |
| Parser | 2 | 8 | 70 | 5 | 18 | 6 | 0.60 |
| Term | 1 | 9 | 97 | 8 | 25 | 9 | 0.70 |
| Exp | 2 | 5 | 46 | 4 | 7 | 4 | 0.30 |
| FunctionCall | 3 | 8 | 91 | 10 | 30 | 11 | 0.65 |
| Parenthesis | 2 | 4 | 44 | 5 | 12 | 5 | 0.40 |
第二次作业ExprNode、Constant、MainClass 等基础类设计比较好,属性少、复杂度低、高内聚低耦合;而Term、Parser、Expression三类代码行数多、CCC与WMC偏高,CBO较高而且TCC偏低,是代码维护与优化的核心重点,整体项目还是结构清晰的,但核心类需进一步简化与拆分以提升可读性与可维护性。
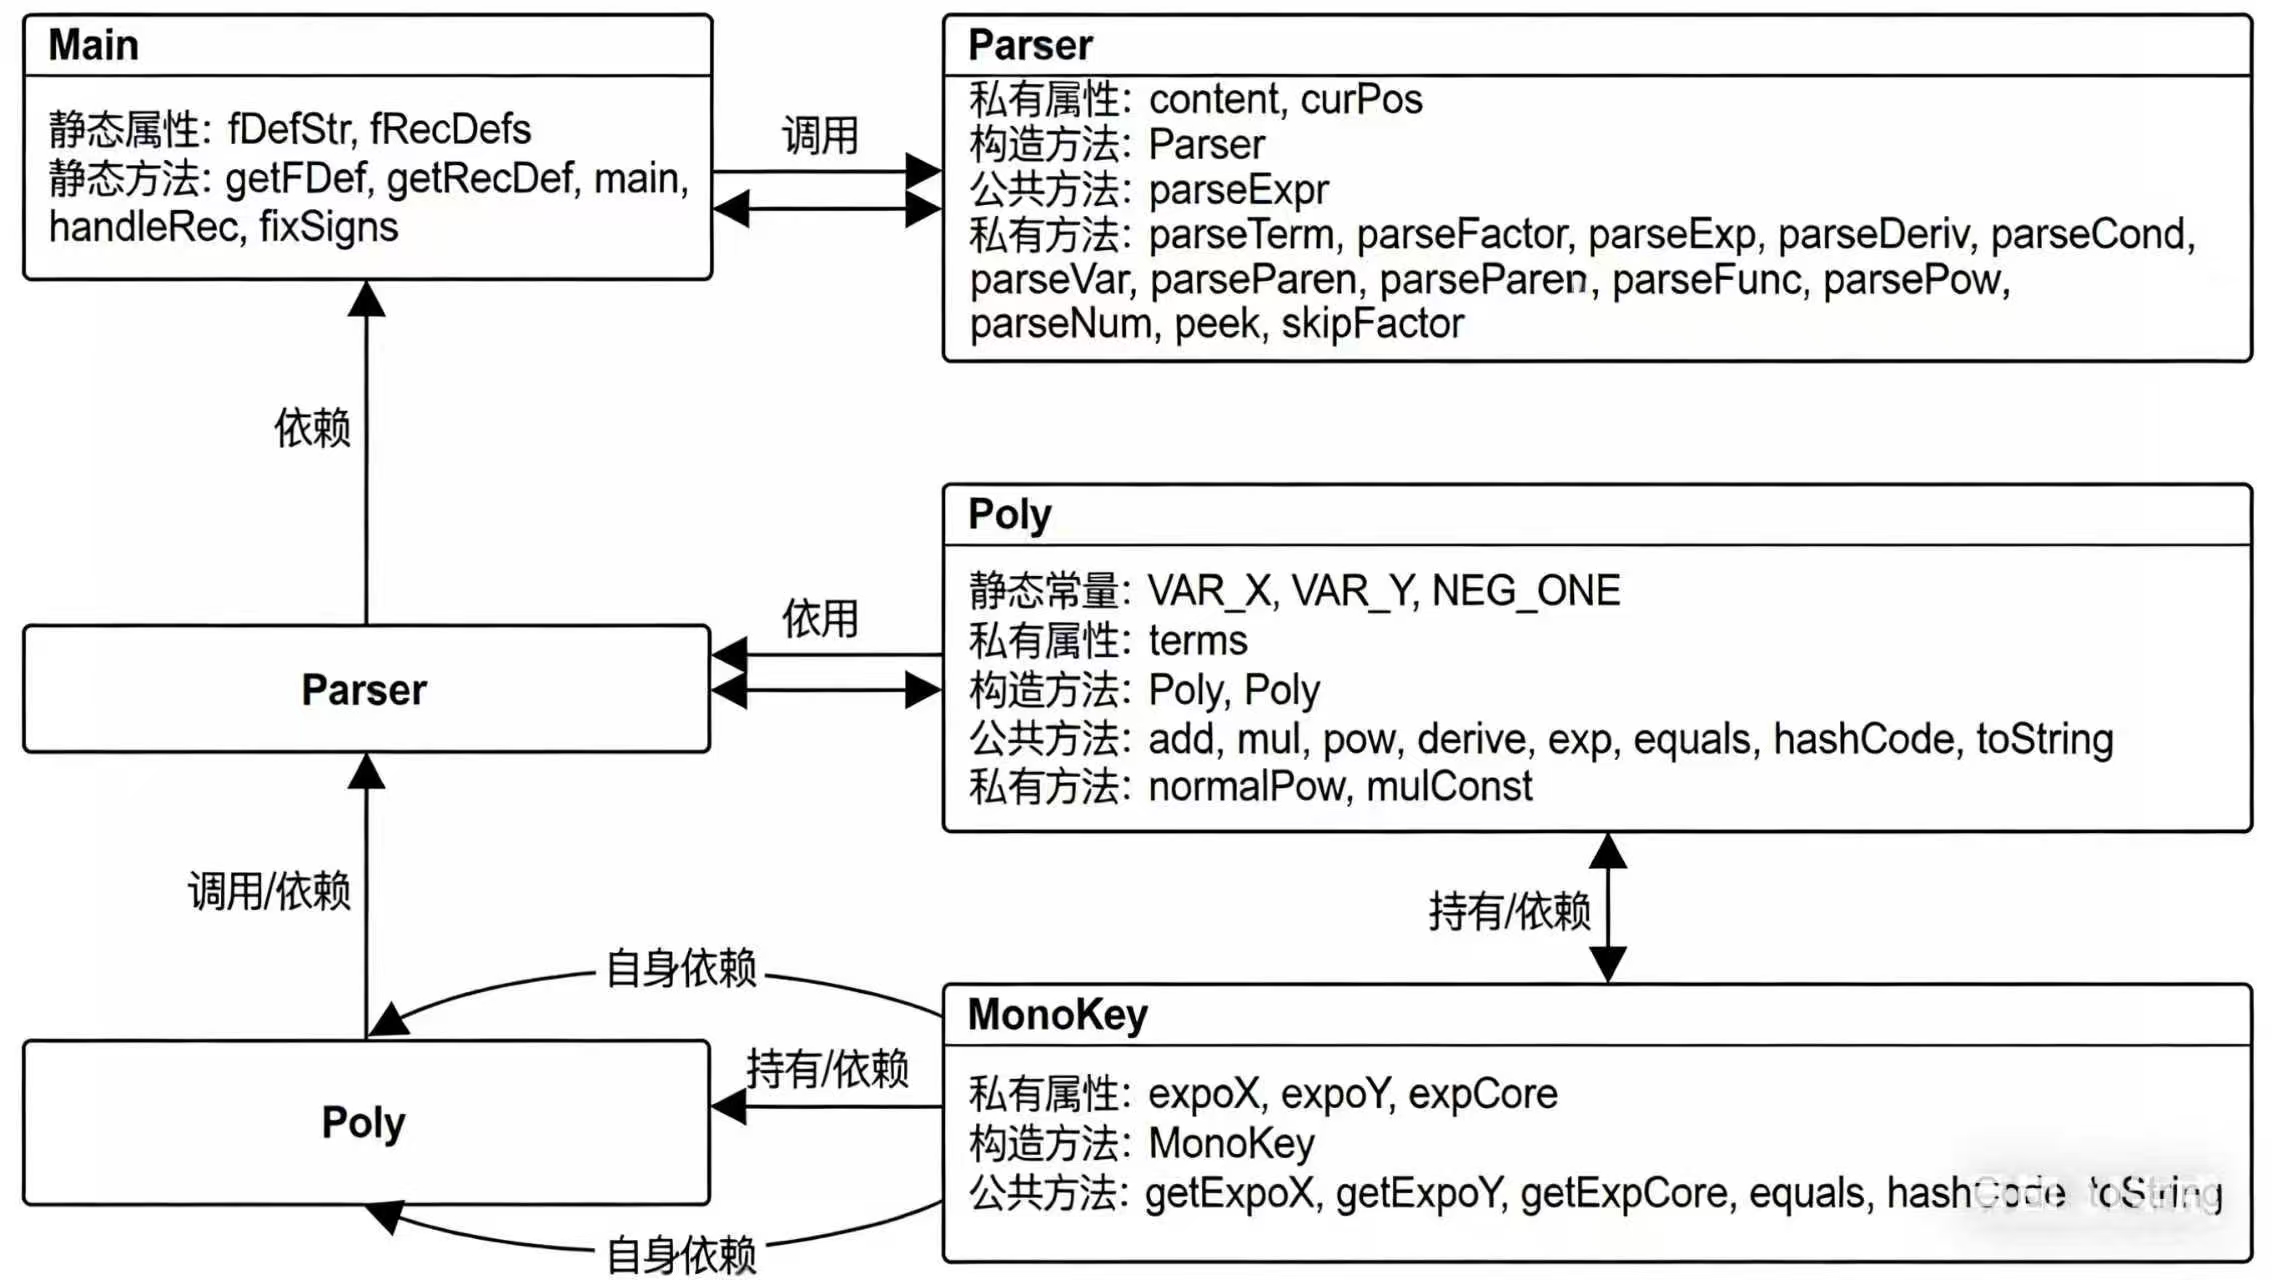
| 类名 | 属性数 (NOA) | 方法数 (NOM) | 类行数 (CLOC) | CCC | WMC | CBO | TCC |
|---|---|---|---|---|---|---|---|
| Main | 2 | 5 | 75 | - | 12 | 2 | 1.0 |
| Parser | 2 | 13 | 215 | - | 45 | 3 | 0.8 |
| Poly | 3 | 11 | 193 | - | 40 | 2 | 0.9 |
| MonoKey | 3 | 4 | 70 | - | 8 | 1 | 1.0 |
整体代码中,Parser 类复杂度最高,是核心解析逻辑载体;MonoKey 内聚性最优,结构简单;四类整体耦合度偏低,但 Parser 的方法复杂度较高,需关注解析逻辑的可维护性,其余类结构简洁、内聚性良好。
第一次作业我采用的是比较普遍的架构,就是MainClass作为主函数入口,Parser作为解析器,第一步对表达式、项、因子一层一层解析下去。第二步是用expand()方法展开表达式。第三步是tostring()方法化简输出。因为每个因子最终都可以化简为a*x^n的形式,所以在化简的时候才用了HashMap以系数和指数为关键字存每个单项式,以方便后续的化简。
第二次作业和第一次作业类似,只是加入了指数因子、自定义函数和选择因子,因此在解析的时候要多考虑这几种情况,其次就是在处理到自定义函数因子或者选择因子的时候判断直接处理代入运算后的结果在进行同样的展开化简。。
第三次作业我原本也是和之前一样,但是后来我尝试了另一种方法,就是将所有因子方法MonoKey单项式类里面然后组合成Poly多项式类。在处理指数部分,我采用了快速幂进行优化。但是这个做法就有点偏离面向对象的思想了,把所有解析因子都放在了Poly类,而没有对每一个“对象”进行处理。第三次作业最终架构有跟ai求教,所以写出了一个比较别致的设计,而且总体代码量并不多,值得学习一下。
在第一次作业中,我在预处理部分出现了问题,没有能够正确识别每个因子前的正号并省略,如果是负号应该怎么处理,将它提出来还是写进下一个因子内部,算是比较基础的错误,后来我专门设计了一个预处理类将读入的字符串先处理成方便解析的标准格式。
第二次作业主要问题出在比如(((x^8)^8)^8)多层嵌套的时候,使用递归处理会出现MLE的报错。其次就是自定义函数的嵌套函数处理,和刚才的问题类似,就是递归深度过深爆栈了。我的处理方法是使用快速幂以及遇到连续的幂指数采用指数相加而不是for循环展开计算。
第三次作业架构已经比较完善了,就是在因子的指数的数据类型是用了int没有使用BigInteger导致超时了,改了以后就没有什么大问题了。
刚开始我会先尝试一些边界样例或者比较复杂的样例,比如时间复杂度高或者多种因子同时出现的样例。之后测不出bug以后再去下载每个人的代码,先看看大概的架构,然后针对一些容易出错的点看看关键部分的代码实现看有没有漏洞,再就是借助ai的帮助发现潜在的漏洞,并构造相对应的样例去进行hack。
在最刚开始的时候,我立志完成一个非常完美的架构设计,这样在之后修复bug以及迭代的时候可以更小的进行的代码的改动,但对于我来说这有点吃力了,于是我就跟ai进行了几万字的交互,分享了我最初的思路,然后让ai进行评判,有什么优劣,最终确定了初步架构。其次,在修复bug的时候,有时候发现不了bug的时候,就会让ai代入样例,帮我检查哪里出现了问题,最终进行修改。
在互测阶段,我使用ai阅读他人的代码,并且发现别人的bug,以构造相应的样例去攻击。
对于这一单元的学习,我感觉挺辛苦的,有时候因为一个代码的小bug思考了一整天,花了很多无效的时间。而且我使用了过多的大模型工具,也可能是刚开始OO的学习还没进入状态。之后我会减少大模型的使用,多进行自己的思考,找到更好的架构设计,解决出现的bug。还有就是这一次的样例我是纯手搓,构造的好不好全凭灵感,之后我要尝试写评测机帮助我进行测试数据的生成,也同时帮助我深刻理解面向对象设计与构造的本质。
我认为对于第一单元的作业,在经历了一个寒假以后,快速进入如此大代码量的工作有点吃力。其次,对于第一单元的实验指引并不是很明确,辅助练习过于少了,并且不够有针对性。因此,可以多加一些循序渐进的练习帮助单元作业的完成。其余部分做的都很不错,有劳各位辛勤的助教以及老师们!

