


309
社区成员
 发帖
 与我相关
 我的任务

 分享
第一次作业的任务是单变量多项式的括号展开与合并同类项。我的整体结构核心是“递归下降解析 + 多项式统一求值”。
| 类名 | 属性个数 | 方法个数 | 代码规模 | 说明 |
|---|---|---|---|---|
| Main | 0 | 2 | 29 行 | 输入输出控制 |
| Parser | 2 | 8 | 143 行 | 递归下降解析核心 |
| Expr | 2 | 3 | 30 行 | 表达式层,管理加减 |
| Term | 1 | 3 | 22 行 | 项层,管理乘法 |
| Factor | 0 | 1 | 3 行 | 因子抽象类 |
| NumberFactor | 1 | 2 | 14 行 | 常数因子 |
| VarFactor | 2 | 2 | 16 行 | 变量因子 |
| ExprFactor | 3 | 2 | 20 行 | 括号表达式因子 |
| Poly | 1 | 11 | 139 行 | 多项式运算与输出核心 |
第一次作业中,复杂度最高的方法主要有两个。第一个是 Parser.parseFactor(),负责处理前导符号、括号因子、变量因子、常数因子和指数读取,分支最多,也是最容易出错的地方。第二个是 Poly.toExprString(),负责最终输出格式,既要保证语义正确,又要保证没有多余括号和空格。
从控制分支和圈复杂度的角度看,Parser 和 Poly 是整个程序中最重的两个类;而 Expr、Term、Factor 体系的职责都比较单一,复杂度相对低。
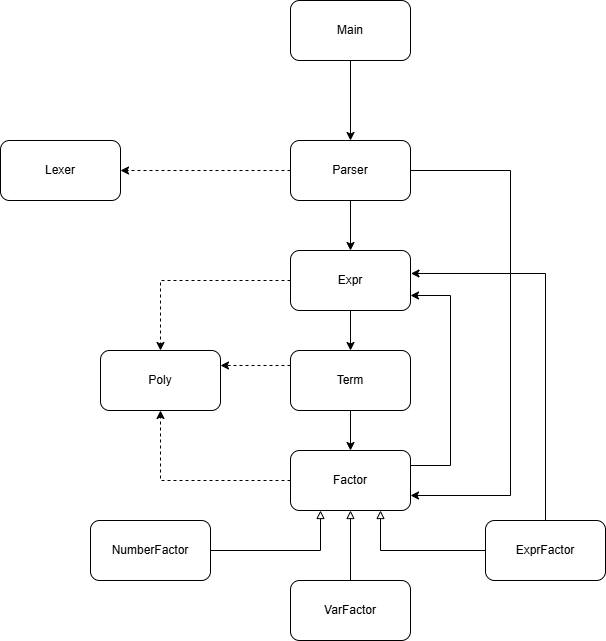
Main 的职责只有读入、去空白、调用解析、输出结果,职责很单一。Parser 负责按照文法把字符串解析成对象结构,是第一次作业的控制核心。Expr 表示加减结构,Term 表示乘法结构,Factor 统一不同因子的求值接口。NumberFactor、VarFactor、ExprFactor 对应三类因子,这种继承结构使 Term 不需要写大量分支判断。Poly 用“指数到系数的映射”表示单变量多项式,便于合并同类项,也便于实现加减乘幂。
优点:语法层和计算层分离得比较清楚,Expr-Term-Factor 和 Poly 分工明确,代码可读性比较好。
缺点:第一次作业的 Poly 只适合单变量多项式,一旦后续出现更一般的表达式结构,这个抽象就会受到限制。另外,Expr 采用“符号列表 + 项列表”的并行数组设计,写起来方便,但内聚性一般。
第二次作业在第一次作业的基础上加入了 exp、自定义函数、选择式因子,程序开始从“纯多项式展开器”向“更一般的表达式处理系统”过渡。
| 类名 | 属性个数 | 方法个数 | 代码规模 | 说明 |
|---|---|---|---|---|
| Main | 0 | 2 | 49 行 | 输入输出控制 |
| FunctionDef | 1 | 2 | 11 行 | 普通函数定义封装 |
| Parser | 3 | 13 | 244 行 | 解析核心 |
| Expr | 2 | 3 | 30 行 | 表达式层 |
| Term | 1 | 3 | 22 行 | 项层 |
| Factor 体系 | 多个 | 多个 | 约 100+ 行 | 新增 exp、函数调用、选择式等子类 |
| Poly | 1 | 15+ | 421 行 | 广义多项式核心 |
| MonoKey | 2 | 10+ | 约 90 行 | 单项式键抽象 |
第二次作业最复杂的方法仍然集中在 Parser 和 Poly 中。Parser.parseFactor() 比第一次作业更复杂,负责 exp(...)、f(...) 和选择式因子的分派。Parser.parseChooseFactor() 也比较复杂,不仅要处理 [(A==B)?C:D] 这种结构,还要正确识别条件部分和两个分支。Poly 中的 normalize()、toExprString()、toFactorString() 和一些和 exp 相关的输出优化方法也变得更重,既要维护语义,又要尽量缩短输出。
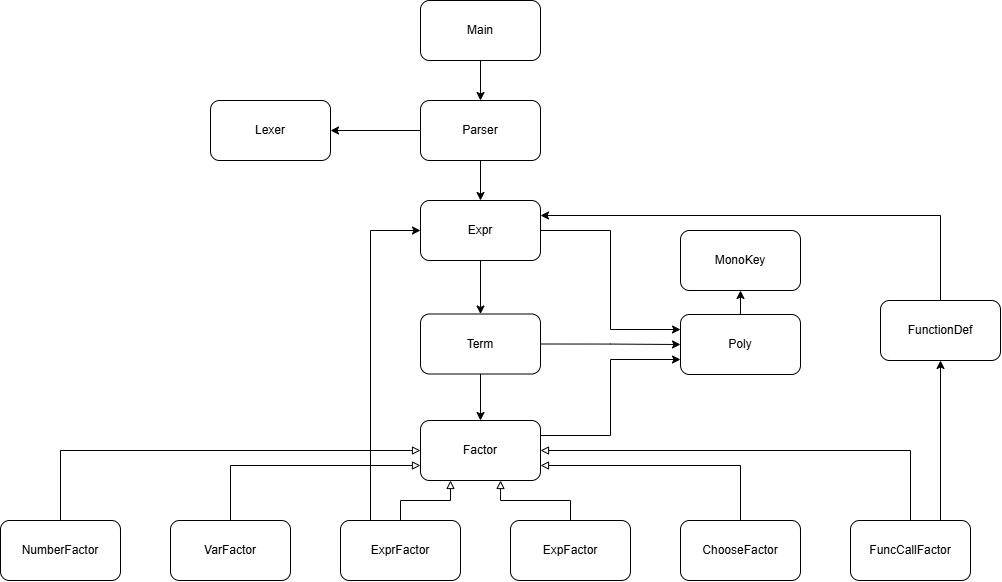
第二次作业中,Factor 体系成为扩展中心。
在第一次作业的 NumberFactor、VarFactor、ExprFactor 之外,我又增加了 ExpFactor、ChooseFactor、FuncCallFactor 等新因子类型。这样做的好处是新增语法大多只需要增加新的因子子类,而不必推翻整个文法结构。FunctionDef 把普通函数定义独立出来,使函数调用不只是字符串替换,而是一个明确的对象行为。Poly 则从第一次作业中的“单变量多项式”推广成了“支持 x 和 exp(...) 的广义单项式系统”。它内部不再只是记录变量指数,而是通过 MonoKey 同时记录变量幂次和指数函数参数。
优点:延续了第一次作业中正确的文法分层,整体结构没有被推翻,扩展点也比较明确。
缺点: Poly 的职责进一步膨胀,它不仅负责运算,还承担了规范化和输出优化的任务。
同时,Parser 中的分支也明显增多,尤其是 parseFactor() 逐渐变成高风险方法。
第三次作业加入双变量、求导算子和递推函数,程序从“表达式展开与替换系统”进一步发展成了一个简化版符号计算系统。
| 类名 | 属性个数 | 方法个数 | 代码规模 | 说明 |
|---|---|---|---|---|
| Main | 0 | 3 | 90 行 | 总体流程控制 |
| Environment | 2 | 4 | 20 行 | 保存函数环境 |
| EvalContext | 3 | 3 | 24 行 | 保存求值上下文 |
| ParseConfig | 6 | 6 | 51 行 | 解析上下文限制 |
| FunctionDef | 1 | 2 | 11 行 | 普通函数定义 |
| RecFunctionDef | 4+ | 4 | 64 行 | 递推函数与缓存 |
| Parser | 3 | 16 | 273 行 | 解析核心 |
| Expr | 2 | 3 | 30 行 | 表达式层 |
| Term | 1 | 3 | 22 行 | 项层 |
| Factor 体系 | 多个 | 多个 | 约 190 行 | 新增导数、递推调用等因子 |
| Poly | 1 | 23 左右 | 446 行 | 双变量广义多项式核心 |
第三次作业中,复杂度最高的类仍然是 Parser 和 Poly。Parser.parseFactor() 和 Parser.parseFunctionLikeFactor() 负责处理普通函数、递推函数、占位调用和求导因子,分支最密。Poly.derivative()、Poly.normalize()、Poly.toExprString() 则是语义最重的几个方法,既要保证求导结果正确,又要保证输出满足必要括号和性能要求。
另外,RecFunctionDef.apply() 虽然代码不算最长,但它位于递推求值的热点路径上,对整体性能影响很大。
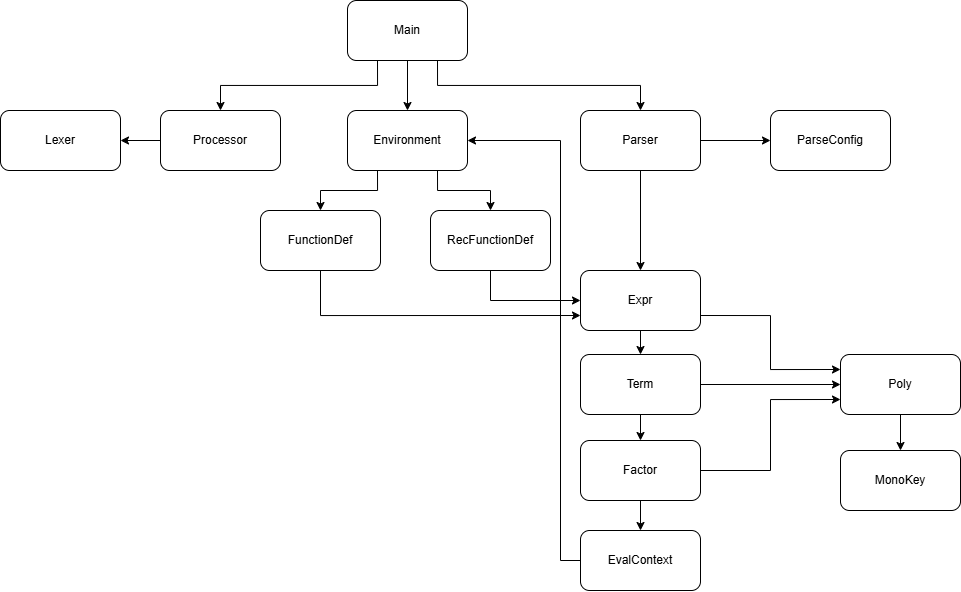
第三次作业中最有价值的三个新抽象是 Environment、EvalContext 和 ParseConfig。Environment 负责保存普通函数和递推函数的定义。EvalContext 负责保存当前实参、全局环境和递推层数,使求值过程具有统一的动态上下文。ParseConfig 负责描述当前解析环境允许出现哪些语法成分,例如函数定义体中不允许 y、不允许求导、不允许选择式等,这样可以把题目限制显式写进程序结构里。RecFunctionDef 负责递推函数展开,并且加入了缓存,避免同一 (序号, 实参) 被重复计算。Poly 则进一步扩展为支持 x^a * y^b * exp(P(x,y)) 这种二元广义单项式表示,并统一承接加减乘幂、求导、规范化和输出。
优点:整体骨架稳定,扩展路线清楚,尤其是上下文抽象比前两次更成熟。
缺点: Poly 过重,它同时承担了数据表示、运算、求导、输出和局部优化,职责偏多。
另外,Factor.java 中放了较多内部逻辑子类,实现上方便,但模块粒度仍然偏粗。
三次作业中,真正稳定下来的部分是 Expr-Term-Factor 这一文法骨架;变化最大的部分则是 Poly 的具体表示方式。
第一次作业的 Poly 只支持单变量多项式;第二次作业推广为支持 exp(...) 的广义单项式;第三次作业又推广为支持双变量与求导的广义单项式系统。
这说明我的架构并不是每次都推翻重写,而是在连续迭代中逐渐识别出了哪些部分是稳定骨架,哪些部分必须随需求继续推广。
第一次作业中,我的主要目标是把字符串表达式稳定地转成对象结构,再统一求值。因此我采用了递归下降解析,并建立了 Expr-Term-Factor 的层次,同时用 Poly 表示单变量多项式。这个阶段的重点是“先把表达式解析对,再把展开和合并同类项做对”。
第二次作业加入 exp、自定义函数和选择式后,第一次作业中“所有表达式最终都能压成普通多项式”的前提开始失效。面对这个变化,我没有推翻原有结构,而是保留文法骨架,把扩展集中在两个位置:一是继续增加新的因子子类,二是推广 Poly 的单项表示方式,使其能够表达 x 和 exp(...) 共同组成的广义单项式。这个阶段的重点变成了“支持更一般的表达式结构”。
第三次作业又加入双变量、求导算子和递推函数,程序开始真正具备符号运算特征。到了这一步,除了继续扩展因子体系和 Poly 之外,我还显式引入了 Environment、EvalContext 和 ParseConfig。这说明程序已经不仅仅是在做静态展开,而是开始拥有“环境”“上下文”“受限文法”这些更成熟的运行时抽象。
如果从结构上看,三次作业最大的变化不是 Expr 和 Term,因为这两个类基本一直比较稳定;最明显的变化集中在以下三点:
Factor 体系不断扩展,逐渐成为新增语法的主要落点;Poly 的表示能力不断被推广,从普通多项式变成广义双变量表达式;这也说明,我的重构不是“整体推翻式重写”,而更像是“保留稳定骨架,逐渐推广核心抽象”。
如果下一次迭代新增的是二阶偏导,例如 dxx(E)、dxy(E)、dyy(E),我认为当前最终设计仍然有一定可扩展性。
原因是:
Poly 已经能够区分 x 与 y;DerivativeFactor 已经把“求导算子”作为独立因子处理,继续增加新的导数算子时,不需要推翻原有文法;Poly.derivative() 已经存在,只需要在现有基础上做多次求导组合即可;Environment 和 EvalContext 不需要大改,因为二阶导不会改变函数环境和代换方式。当然,这种扩展也会进一步增加 Poly 的压力。如果后续需求继续增加,例如更多运算符或者更多函数类型,那么仅靠继续扩展 Poly 可能就不够了,需要把“表示”“运算”“输出”进一步拆开。
第二次作业中,我在强测里遇到的 bug:输入中每个显式指数都不超过 8,但表达式通过多层幂嵌套后,会在语义上产生极大的总指数。例如类似 ((((x^8)^8)^8)... )^8 这样的结构,虽然输入合法,但中间结果中的指数会非常大。我的程序最终错误输出为 1。
这个 bug 的根源不是单纯“某个边界条件忘了判”,而是程序内部对指数的表示不统一。解析器和多个因子类里,指数仍然主要使用 int;但在 Poly 的单项表示里,变量指数又已经使用了更大范围的数据表示。也就是说,程序只在结果层承认指数可能很大,但在前面的解析层和因子层仍然默认指数是小整数。一旦出现深层嵌套幂,这种不一致就会暴露出来。
第三次作业中,我被互测攻击的点主要不是正确性错误,而是 CPU 时间超限。被攻击数据的共同特点很明显:普通函数 f(x) 的定义本身就很复杂,包含多层嵌套 exp 和幂;而待展开表达式又使用了 f(f(f(...))) 这样的多层自复合调用。
结合代码分析,这类性能 bug 的主要原因是我对普通函数调用采取了“立即代入、立即完整求值”的策略。在 FunctionDef.apply() 中,每次函数调用都会重新对整个函数体执行一次 eval;而 VarFactor.eval() 在函数体内部又会把形参 x 直接替换成实参多项式,再继续参与 pow()、mul() 和 normalize()。于是,随着函数体越来越大、调用层数越来越深,整个中间结果规模会迅速膨胀,最终表现为 CPU 时间超限。
如果把这几个 bug 放回到方法层面看,会发现一个现象:真正出问题的方法不一定是最复杂的那个。
| 类型 | 方法 | 特征 |
|---|---|---|
| 有 bug 的方法 | 幂相关求值链、FunctionDef.apply()、VarFactor.eval() | 代码不一定最长,但位于关键数据边界或高频热点上 |
| 相对稳定的方法 | Expr.eval()、Term.eval()、简单常数因子求值 | 逻辑单一,输入输出关系清楚,副作用较少 |
所以我认为,降低 bug 风险的方法不只是“把大方法拆小”,还包括两点:
第一,减少关键数据在不同层次上的表示不一致;
第二,识别真正的运行热点,避免在热点路径上做重复计算。
第一次作业互测时,我发现一类有效的 hack 点:构造最终结果为 0 的表达式。
例如:
| 输入 | 正确结果 | 暴露的问题 |
|---|---|---|
x^0-1 | 0 | 幂化简后归零,未正确输出 |
x-(+x) | 0 | 一元正号与项抵消处理不当 |
++x+(-+x)-(x)+(--x) | 0 | 多层符号折叠后整体归零处理不当 |
这些样例都合法,而且覆盖了不同来源的零结果:有的是幂化简后归零,有的是括号和一元正号参与抵消,有的是连续符号折叠后归零。很多程序在普通情况下能够输出正确结果,但一旦所有项都被消掉,就会输出空串而不是 0,最后被判成 Format Error | Empty output。
第三次作业中,我做的主要优化是:当表达式中出现多个相同的 exp(...) 结构时,尝试把这个 exp(...) 当作公因式提出来;然后把“提取公因式后的表达式”和“不提取公因式的原式”分别转成字符串,比较两者长度,输出更短的那个。
题目的性能分和输出长度相关,在第二次作业强测汲取的经验在第三次作业中运用 。如果直接保持原样输出,表达式虽然正确,但长度可能较长;如果提取公共的 exp(...) 因子,有时能明显缩短结果。
不过,这种优化不是无条件进行的。因为提取公因式后,有时会增加括号、乘号等额外符号,导致结果反而更长。所以我没有固定采用某一种形式,而是同时保留“提取后”和“提取前”两个候选结果,最后用长度比较来选择更优输出。
这个优化的优点是实现成本不算高,而且能直接对性能判定起作用。缺点是它仍然只是局部优化,不能保证得到全局最短输出。后续如果继续改进,可以把“同时构造多个等价候选式并比较长度”的思路推广到更多等价变形上,而不只是局限于 exp(...) 公因式提取。
在本单元三次作业中,我使用大模型的比例大约在 30% 左右。主体结构和主要代码仍然是自己完成的,但在优化、查错和分析边界问题时,大模型提供了比较多的辅助。
我使用大模型最主要的场景有两个:
总体来看,大模型在性能优化和 bug 修复上的完成效果是比较好的。只要我能提供足够具体的输入样例、错误现象和相关代码,它通常能较快给出比较有价值的分析方向。但在互测阶段,大模型在“主动帮我找最有杀伤力的 hack 点”这件事上并不算特别聪明。它能给出一些常见边界点,但不一定总能抓到最容易卡掉别人程序的输入。
本次互测房间里,我暂无明确怀疑对象,所以这一部分我不做主观判断。仅从我自己接触到的代码来看,还没有足够强的依据去认定某位同学大量使用了 AI 生成代码。
第一单元给我的最大感受是:刚开始看上去像在写一个“字符串处理程序”,但做着做着就变成了一个“表达式系统设计问题”。
第一次作业时,我主要关注的是怎么把文法解析对、怎么把括号展开对;第二次作业开始,我逐渐意识到仅靠“把结果算出来”是不够的,程序内部还需要有能持续扩展的表示方式;到了第三次作业,双变量、求导和递推函数一起出现,我才真正体会到“架构设计”在连续迭代里的意义。
这一单元里,我收获最大的不是某一个具体技巧,而是两点。
第一,稳定的骨架要尽量早建立,比如 Expr-Term-Factor 这一层次在三次作业里一直都能用;
第二,真正容易出问题的地方,往往不是最显眼的地方。像指数的内部表示不一致、普通函数调用的热点性能问题,都是我在实践里吃过亏之后才真正意识到的。
如果让我对第一单元课程提一点改进建议,我觉得可以从下面几个方向优化:
很多同学第一次作业能把文法写出来,但对“表达式内部应该怎么表示”理解不够,结果第二次、第三次作业一加新需求,前面的设计就很难改。
如果课程在第一次作业前就更明确地强调“数据表示决定后续可扩展性”,大家后面重构的压力可能会小一些。

