


309
社区成员
 发帖
 与我相关
 我的任务

 分享
本次作业我的最终架构如下:
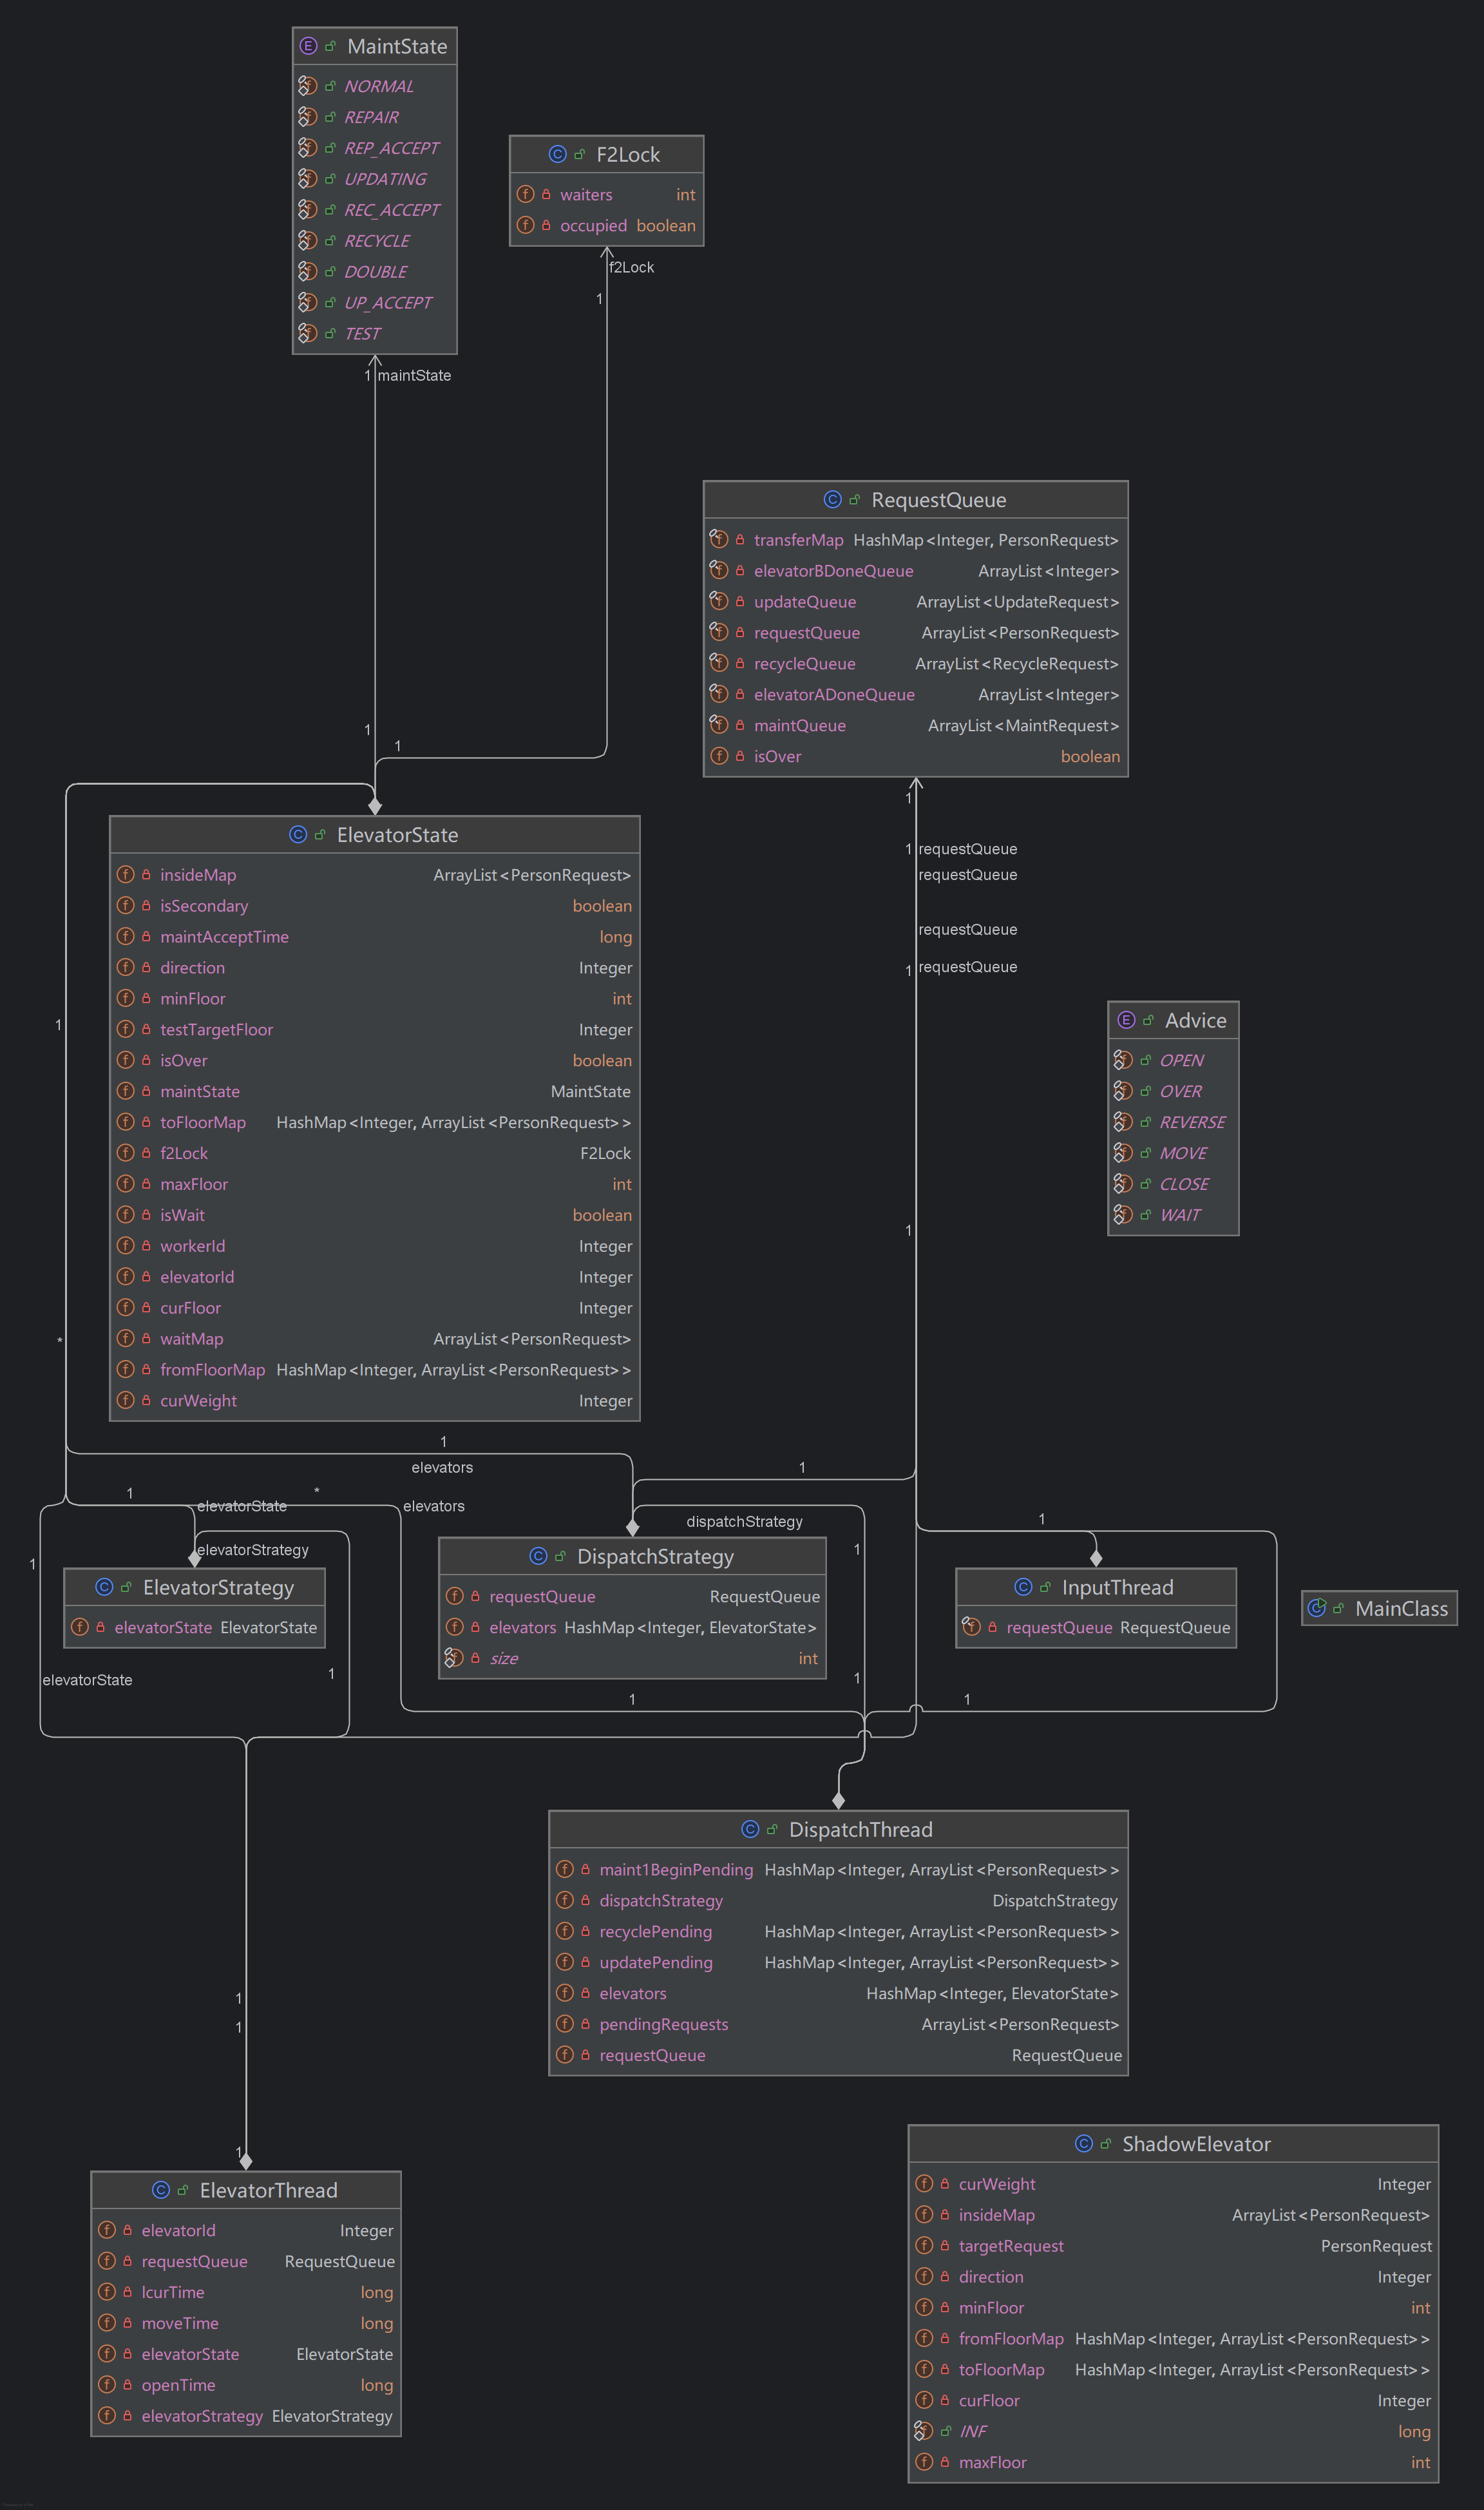
本单元作业的数据冲突主要体现在数据的共享读写上,在涉及到加锁时需要谨慎使用,如果漏加锁会出现线程安全问题,但如果加锁过多又会影响程序的性能。因此需要仔细思考哪些地方需要加锁,哪些地方可以不加。
在本单元作业中,我加锁的主要对象有RequestQueue和ElevatorState。其中RequestQueue包含全局等待队列。我将所有对队列的增、删、查方法都设为同步方法,同步块中的处理语句主要是极其简短的集合操作,确保了加锁时间极短,不会造成线程阻塞,减少了其它线程等待锁的时间。在ElevatorState中主要保存了电梯的状态,包括当前楼层,载重,内部队列等,调度器需要读取电梯状态来分配乘客,而电梯线程随时在修改这些状态。因此我对addRequest、receiveMaint、endRecycle以及状态查询等关键方法进行了同步,这些同步块中操作也较为简单,在确保线程安全的同时兼顾了其它线程等待锁的时间。
此外,在第三次作业中增加了双轿厢的改造,为避免轿厢在F2层的碰撞问题,需要单独设置一个锁。对此,我将其单独抽离成一个类F2Lock,利用waiters和occupied状态位进行精准的并发控制,避免了锁的嵌套,同时使架构更加清晰。
我的调度器采用了生产者-消费者模型,InputThread将请求加入RequestQueue中,DispatchThread从RequestQueue中获取请求,再通过DispatchStrategy选定要分配给哪部电梯,最后交给ElevatorThread。整体的关系链是:InputThread->RequestQueue->DispatchThread->ElevatorThread。其中我把调度器单独抽离出来,只负责将请求分发给电梯和收回当前被暂时结束的请求并重新分配这些请求,具体的选择电梯的过程放在了DispatchStrategy中。
在第二和第三次作业中,我采用了影子电梯模拟作为调度策略。每次有新请求到来时,DispatchStrategy会深拷贝当前所有可用电梯的状态生成 ShadowElevator。影子电梯在内存中快速模拟运行,计算出接送该乘客所需的预估代价。优先选择代价小,重量小和内部乘客数量少的电梯,同时给每部电梯增加分配人数限制,避免因其它电梯不可用时给一部电梯分配过多请求导致超时。电梯的
InputThread获取请求,调用RequestQueue.addPersonRequest(),唤醒等待在全局队列上的DispatchThread。DispatchThread被唤醒后,选定一台电梯,调用目标电梯的ElevatorState.addRequest(),并唤醒该电梯。ElevatorThread被唤醒,发现有任务,开始工作。
在第一次迭代中并未出现bug。
在第二次迭代中未考虑到请求都被分配到一部电梯的情况,导致互测时出现了TLE。
在第三次迭代中,回收双轿厢时因为没注意多加了一句状态变化,导致在副轿厢回收的短时间内被错误地判为可接客,出现了WA。此外给影子电梯的模拟步数过多,导致CPU有可能略微超时。
我的debug方法主要是配合大模型辅助检查,让大模型生成了一个评测机,但效果似乎不太好,自己审查代码时也发现了几处错误,但没有完全发现所有bug。同时由于多线程运行的不确定性,对于一些样例可以多次测评观察是否会偶发异常。
在三次作业的迭代中,我深刻体会到线程安全的核心不在于无脑地滥用synchronized加锁,而在于“控制共享可变状态的访问域与原子性”。真正的线程安全是通过清晰的架构设计来实现的,例如在本系统中,我尽可能将所有多线程并发读写的冲突点,如电梯当前的载重、楼层、等待队列等全部收拢并严密封装在ElevatorState这一单一对象内部。外界对电梯状态的任何修改与探查,都必须通过该对象暴露的、经过细粒度同步加锁的安全接口来完成;同时,对于像状态切换与范围限制这样在业务上不可分割的动作,必须利用同步块保证其执行的原子性,从而彻底根绝因时间窗口错位导致的竞态条件出错。
层次化设计的本质是“关注点分离”与“职责解耦”,它直接决定了面对需求变更时代码的抗脆弱性。在我的电梯系统中,我严格划定了物理线程层(ElevatorThread,只管跑循环与物理睡眠)、状态数据层(ElevatorState,只负责维护属性与加锁同步)、以及决策算法层(ElevatorStrategy/DispatchStrategy,无状态的纯逻辑计算)。这种设计使得我的策略类成为绝程安全的纯函数,不受任何底层锁机制的干扰;同时,当第三次作业需要新增双轿厢模式时,我无需颠覆原有的电梯运行框架,只需在调度层增加创建、销毁备用轿厢的逻辑,并在底层引入 F2Lock 互斥对象即可。层次化不仅让代码更加清晰易懂,更为多线程环境下排查死锁提供了清晰的逻辑边界。
在第二单元中,我使用大模型的比例相较于第一单元有提升。由于之前没有接触过多线程,对相关知识和策略了解很少,因此我利用大模型学习了相关知识。此外,对于一些策略,如LOOK调度,影子电梯等,大模型可以帮助我们生成伪代码或部分代码,大大减少了我们查找相关资料的时间。但整体架构和设计还是不能完全交给大模型,必须自己设计并验证,大模型在这方面只能起到辅助作用。大模型没有完整的工程上下文意识,而且如果过度依赖大模型生成包含锁逻辑的代码,极易引入隐蔽的死锁。因为大模型往往只关注局部逻辑的最优解,而忽视了诸如synchronized嵌套获取顺序等全局死锁条件。因此在这单元中,我主要进行架构和设计,以及大部分关键代码的编写,对于一些重复,简单的部分可以让大模型完成。此外在debug方面,可以让大模型编写评测机,但效果并不能得到保证。在中测中可以将报错信息和代码给大模型,这种情况下它往往能根据报错信息快速指出可能的错误,使得debug更加方便。互测时也可以先让大模型检查一遍代码,找出一些明显的错误。
这单元和第一单元差别较大,初次接触多线程,和之前的单线程是完全不同的体验。单线程下只要程序逻辑严密,结果必定是相同的,但多线程的不确定性非常明显。在本地运行和在评测机运行可能得到完全不同的结果,本地环境和评测机环境也不同,这导致即使本地没有问题,评测时也可能出现意料不到的错误。这要求我们在设计和编写时需要更加仔细,避免可能的竞态错误,在正确的地方加锁和同步块。此外,这一单元的性能优化也变得更加玄学,由于后续请求的不可知性导致几乎不可能有最优解,即使是影子电梯这些也只能做到局部最优,一些数据下可能和随机分配性能也差不太多。这也提示我们有的时候没必要过度追求性能,应优先保证程序的正确性和优良的架构。

