


309
社区成员
 发帖
 与我相关
 我的任务

 分享
本单元使用UML的方法,引导我们开展正向建模。分两阶段来完成本次作业,第一阶段要求在编写代码之前绘制一阶类图,提前构思代码的整体架构,不宜过细,可能会因为出现未预料到情况导致在代码编写阶段需要对架构进行较大改动;同时也不宜过粗,未能达到正向建模的目的。在第二阶段则需要提交代码和二阶类图,评测机会从两阶类图间的相似性、关键词覆盖率、核心类设计、核心类的属性与方法设计等多维度进行评测。在编写代码的同时及时调整二阶类图的实现能够比较有效的整体把握框架。
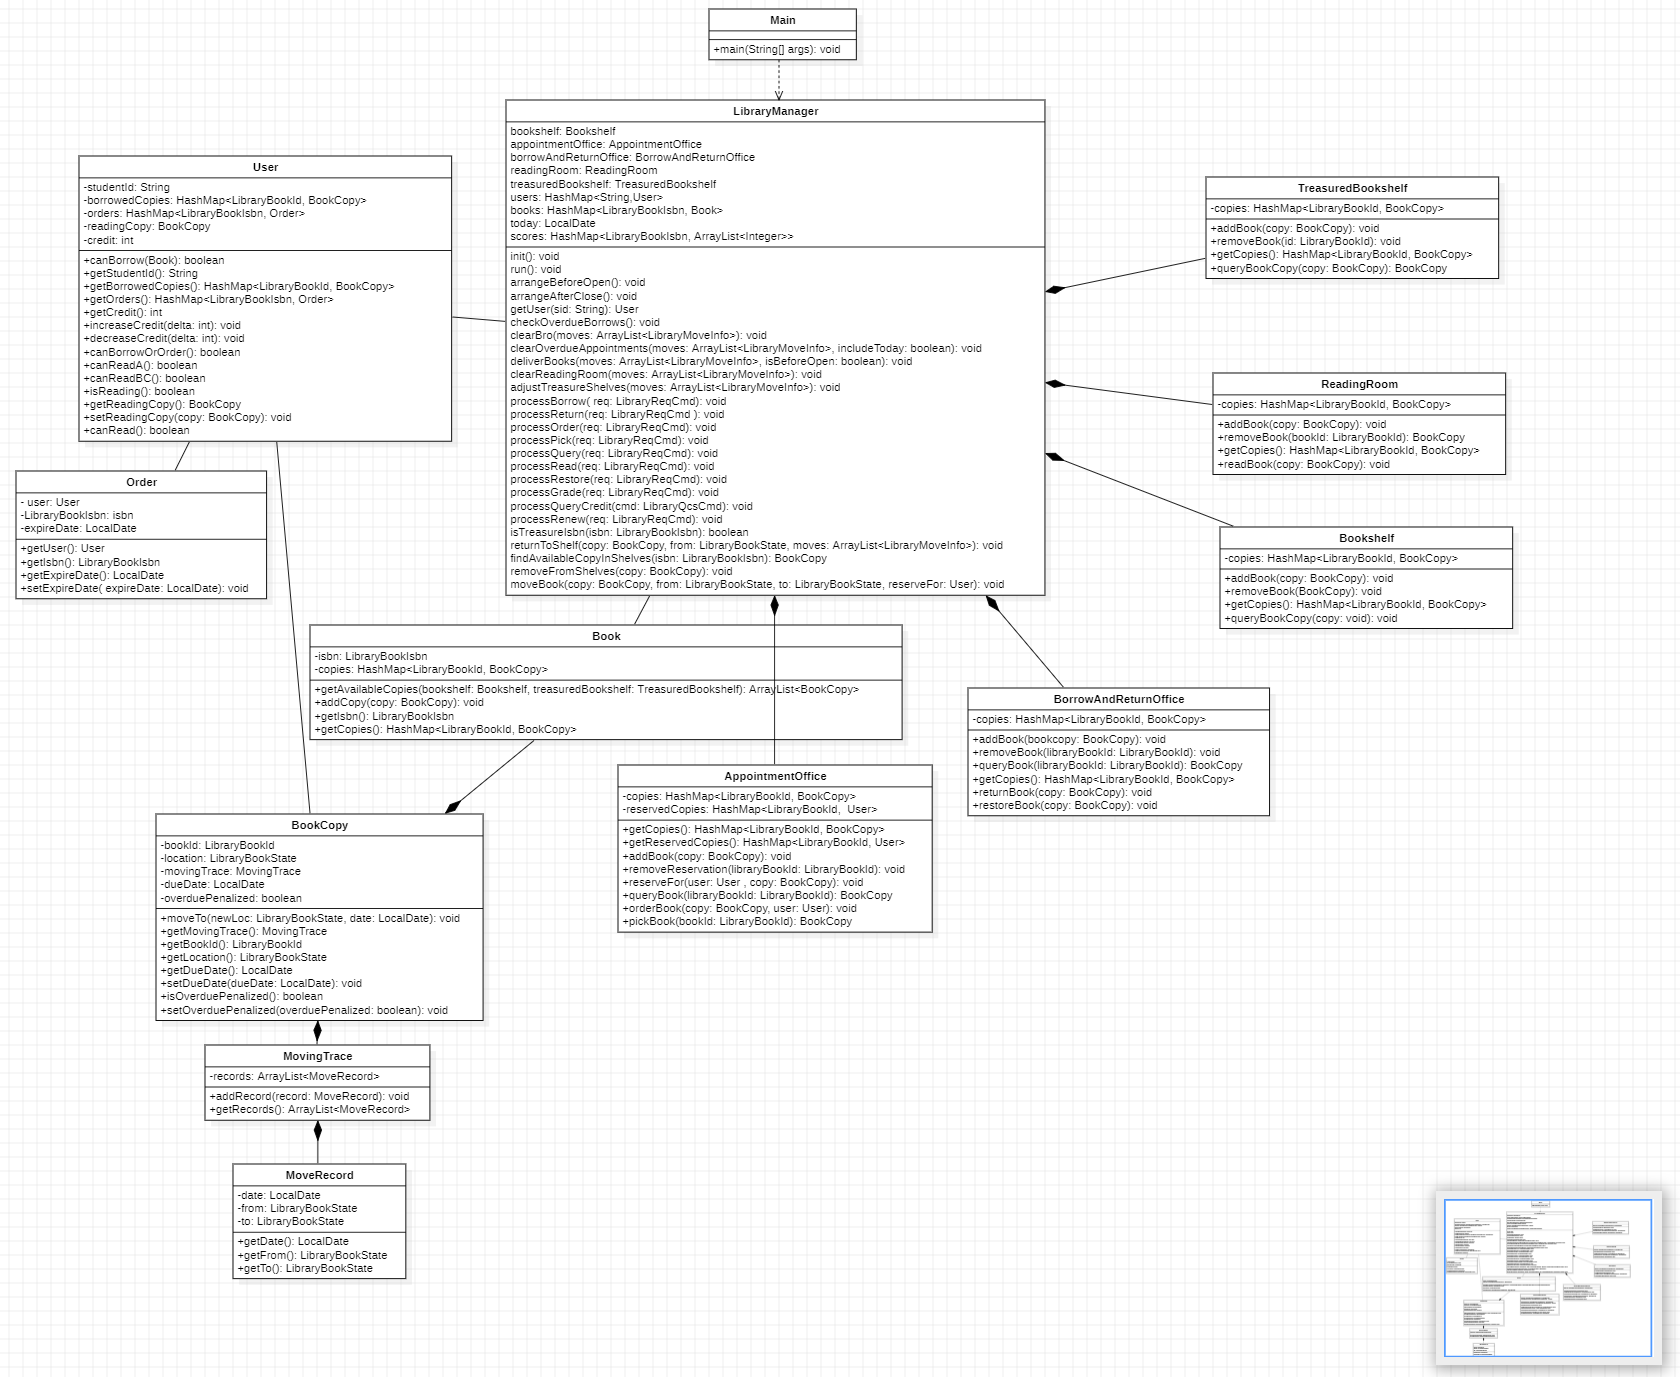
本单元目标是实现一个图书管理系统,需要模拟图书的位置,开馆闭馆和用户借阅等一系列规则。图书会在图书馆的不同部位(书架,归还处,预约处,用户)之间移动
一个虽显冗杂但思路清晰的方案是,整体采用以 LibraryManager 为中心的集中管理式架构,将不同的地方单独建类,每个类提供方法进行书籍的移动。
这个方法最大的优点是:架构清晰,可迭代性强,高内聚低耦合。
在核心实体设计上,我建立了以下类:
| 类 | 职责 | 关键属性 |
|---|---|---|
Book | 管理同一 ISBN 的所有副本 | isbn, copies |
BookCopy | 单本副本的状态与历史 | bookId, location, movingTrace |
User | 用户借阅/预约状态 | borrowedCopies, orders |
Order | 预约单 | user, isbn, expireDate |
借阅规则通过 User.canBorrow(isbn) 实现数量限制检查:B 类一人一本,C 类同一 ISBN 一人一本,A 类不可借。预约规则在 processOrder 中检查是否有未完成的预约,以及是否已持有同类型图书。取书时检查预约处是否有为该用户预留的、未过期的副本,且取后仍满足借阅数量限制。
整理流程是本次迭代的难点。我设计了 arrangeBeforeOpen 和 arrangeAfterClose 两个方法,集中处理清空借还处、清理过期预约、为有效预约送书等操作。deliverBooks 方法实现了从书架上取出副本送往预约处,并根据是开馆前还是闭馆后送达设置不同的保留期限(today.plusDays(4) 或 today.plusDays(5))。这个简洁的日期计算贯穿了后续所有迭代。
本次迭代新增了精品书架、评分、阅读和归还功能,让图书馆从一个“借还窗口”升级为更真实的阅读空间。
架构上,我引入了 TreasuredBookshelf(精品书架)和 ReadingRoom(阅览室)两个新地点,同样以 HashMap 方式管理。BookCopy 的可移动状态从原来的 4 种扩展到 6 种(增加了 TREASURED_BOOKSHELF 和 READING_ROOM),移动轨迹输出也相应增加了 tbs 和 rr 两种简写。
评分系统的核心是一个 HashMap<LibraryBookIsbn, ArrayList<Integer>> scores,记录每个 ISBN 的所有评分。isTreasureIsbn 方法计算平均分(向下取整),判定是否 ≥4 分。这个判定结果驱动了精品书架的动态调整——每次开馆前整理时,adjustTreasureShelves 遍历所有书架上的书,根据当前评分将书在普通书架和精品书架之间迁移。
阅读流程带来了“当日阅读后未归还”的状态管理。我在 User 中增加了 readingCopy 字段,限制用户同一时刻只能阅读一本书。闭馆后整理时,阅览室中的所有书都会被移回书架(通过 clearReadingRoom),无需用户主动操作。用户也可以选择在闭馆前主动归还(processRestore),书会从阅览室移至借还处。
整理流程的复杂度明显上升:需要先调整精品书架(因为评分可能已变化),再清理阅览室和借还处,最后为有效预约送书。这个顺序至关重要——如果先清理再调整,可能导致同一本书被移动两次,违反“每本书每次整理最多移动一次”的规则。我通过将 adjustTreasureShelves 放在 clearReadingRoom 和 clearBro 之前执行,让放回的书直接落入正确的书架类型,避免了二次移动。
本次迭代的架构改动虽然不多,但精品书架和阅览室的引入为后续信用分系统预留了自然的扩展点——书籍的位置状态已经覆盖了所有可能的生命周期阶段,信用分系统只需要在这些状态的转换点上添加判断条件即可。
本次迭代引入了用户信用分系统、图书借阅期限限制以及续订操作,这些新规则让图书馆的管理从简单的“位置移动”升级为带有时间维度和信用约束的动态行为模拟。在架构上,我延续了前两次迭代的轻量化设计思路——依然不设立独立的地点类,而是直接用 HashMap 在 LibraryManager 内部管理各个位置的图书副本集合。所有新增的状态与逻辑都被巧妙地内聚到原有的 User 和 BookCopy 两个实体类中,改动最小化却功能完备。
User 类新增了 credit 属性(初始 100,上限 180,下限 0),并提供了 increaseCredit / decreaseCredit 方法以及 canBorrowOrOrder、canReadA、canReadBC 三个权限查询。借阅、预约、阅读操作前都会先检查信用分是否满足阈值,使得信用分成为控制用户行为的一道动态门槛。
BookCopy 类则增加了 dueDate(借阅到期日)和 overduePenalized(逾期是否已扣分)两个字段。借阅或取书成功时,根据类别给副本设置 dueDate(B 类 15 天,C 类 30 天);续订时如果未逾期,则将 dueDate 向后延长 7 天。所有日期比较都以 LocalDate 的 isAfter 方法完成,清晰可靠。
逾期扣分的实现采用了“延迟一次性扣分”的策略:每天开馆前整理时,checkOverdueBorrows() 遍历所有用户持有的副本,若已过 dueDate 且尚未扣分,则扣除 15 分并置 overduePenalized 为 true,有效避免了重复扣分。闭馆后整理时,对未主动归还阅读图书的用户扣 10 分,对预约到期未取书的用户扣 15 分,这些扣分动作都嵌入在已有的整理流程中,没有增加额外遍历。按时还书和主动归还阅读图书的加分则分别在 processReturn 和 processRestore 中直接完成。
续订操作几乎是一个“纯净”的规则检查:判断持有且未逾期,通过则 dueDate += 7 并输出成功,否则拒绝。信用分查询则通过识别 LibraryQcsCmd 指令直接输出 user.getCredit(),与其它请求处理方式一致。
整个迭代几乎没有改动原有的图书移动和整理框架,只是在关键节点插入了信用与时间的判断逻辑,保持了系统的简洁性和可理解性。这种“在实体上增加状态,在控制器中增加判断”的增量式设计,正是前两次迭代积累下来的架构优势。
| UML 元素 | 代码实现 | 一致性说明 |
|---|---|---|
| 关系 | 代码中的成员变量 | LibraryManager 持有各地点实例(聚合),User 持有 HashMap<LibraryBookId, BookCopy>(关联),均与类图连线一致。 |
| 状态图 | @Trigger 注解 | BookCopy 的位置迁移通过 @Trigger(from = "...", to = "...") 标记了每个状态转移方法,状态图与代码严格对应。 |
| 顺序图 | @SendMessage 注解 | processOrder 方法标注了 @SendMessage(from = "LibraryManager", to = "AppointmentOffice"),与顺序图中的消息流一致。 |
在本次图书馆管理系统的三次迭代中,我利用大语言模型作为正向建模的辅助工具:快速梳理出核心实体与业务流程,生成初步类图框架并检查关键词覆盖率;在绘制状态图和顺序图时,模型帮助我确定状态迁移路径、Trigger方法名和消息名称,确保与代码中 @Trigger、@SendMessage 注解一致;代码阶段,模型提供了初始框架并针对每次增量需求给出修改方案,同时辅助调试评测中的逻辑错误(如逾期重复扣分、输出格式遗漏)。大模型显著提升了从需求到UML、再到代码的转化效率,但依赖它时仍需人工把关,以纠正其偶尔忽略的边界规则或格式细节。这种协作模式让我在保持架构主动性的同时,获得了即时反馈,强化了对面向对象设计原则的理解。
在最初设计表达式解析系统时,我没有充分考虑迭代扩展的需求。第一次作业采用了Poly和Mono的结构来管理多项式,这个设计在单变量幂函数场景下工作良好,但当第二次作业引入指数函数、自定义函数后,原有的归约形式$Poly=\sum Mono=\sum a_ix^{b_i}$无法容纳$e^{expr}$这样的因子,导致不得不进行了一次较大的重构,引入了Expression和Element的归一化形式。这次重构的教训让我意识到:架构设计必须预留扩展空间,核心抽象要能覆盖可预见的变体。
因此在第二次迭代时,我做了两个影响深远的决策:一是引入Factor接口统一管理所有因子类型,二是创建FunctionTable作为全局函数管理类,将函数定义与表达式解析解耦。这两个设计在第三次作业引入求导算子和递推函数时发挥了巨大作用——新增功能只需添加新的Factor实现类,完全不需要修改已有的解析和计算逻辑。这种“对扩展开放、对修改封闭”的设计让我体会到了接口抽象的真正价值。
第二单元的电梯调度系统让我在并发架构上有了全新的认识。采用了生产者-消费者模式,将调度器(Distributor)和电梯(Elevator)通过WaitingList这个共享容器连接起来,每个电梯内部再独立持有Strategy对象负责决策。这种分层设计使得“决策”和“执行”完全解耦,在后续引入检修、双轿厢改造等复杂流程时,我只需要修改Strategy和新增Shaft协同类,核心的调度框架完全不需要改动。
这次经历也加深了我对第一单元“将特定功能独立封装”经验的理解:Strategy的分离让电梯调度算法可以独立演进,Shaft的引入让双轿厢的互斥逻辑与单轿厢正常运行互不干扰。这种高内聚低耦合的架构使得增量开发的体验极为舒适——每次新增需求,改动范围都被严格控制在少数几个类内部。
第三单元由课程组直接给定JML规格和架构,我的主要精力放在了内部数据结构的选择和性能优化上。虽然没有自主架构设计,但这个单元让我深刻理解了一个道理:好的规格不等于好的实现。JML 中的receivedVideos在规格层面只是一个抽象的序列,但具体用LinkedList还是自定义双向链表+HashMap映射,性能差异可能达到数量级。这种在既定架构框架下通过数据结构选型和缓存策略来优化性能的实践,为我第四单元自主设计时的权衡提供了重要参照。
第四单元的图书馆管理系统,我在架构设计时面临一个抉择:是否像第二单元那样为每个地点(书架、借还处、预约处、阅览室)单独建类?如果按照“高内聚低耦合”的教条,每个地点应该是一个独立的类,负责自己内部的图书管理。但经过分析,我发现这些地点类的“业务逻辑”极其简单——本质上只有addBook和removeBook两个操作,强行建立多个类反而会增加大量样板代码。
最终的方案是将各地点以HashMap<LibraryBookId, BookCopy>的形式直接内嵌在LibraryManager中,同时保留Book、BookCopy、User等核心实体类和LibraryManager作为总控制器。这个看似“简化”的设计实际上是一种务实的权衡:当子模块没有独立的行为逻辑时,强行拆分类并不会带来更好的可维护性,反而增加了代码跳转的认知负担。后续三次迭代的实践证明,这个架构虽然“简单”,但新增信用分、借阅期限、续订等功能时,只需要在User、BookCopy和LibraryManager中增量修改,完全没有需要重构的地方。
整个OO课程四个单元,我始终坚持搭建自己的评测机进行自动化测试。这套评测系统的核心思想是:数据生成器负责构造测试输入,对拍器负责将待测程序的输出与标准答案或规则验证器进行比对。在整个课程中,我没有任何一个数据点是因WA而扣分的,仅有两个TLE源于性能问题。
第一单元的表达式评测机,数据生成器采用纯随机策略:按照文法规则递归随机生成表达式。这种方式能覆盖大量常规情况,但它有一个致命缺陷——极端样例被命中的概率极低。例如深层递归嵌套、0^0边界、exp(0)化简等特殊情况,纯随机几乎不可能生成。结果在互测中被同房同学用精心构造的极端数据hack了,暴露出我代码在边界处理上的漏洞。这次教训让我意识到:随机测试只能验证“通常情况正确”,而真正的bug往往隐藏在边界和极端场景中。
从第二单元开始,我彻底改造了评测机的数据生成思路,引入了策略驱动的数据生成模式:
dense策略生成密集乘客请求,maint_stress策略聚焦于多部电梯同时检修的压力测试,update_recycle策略专门测试双轿厢改造与回收的边界时序。数据生成器每次运行时,从这些策略中随机选择,保证覆盖不同类型的压力点。Validator类,接收程序的输出,模拟电梯状态迁移,实时检查每一步操作的合法性(时序、载重、双轿厢冲突、检修流程等),不合法则立即报告错误。这种验证方式比简单对拍强大得多。从第二单元开始,这种分层测试策略让我在互测阶段几乎没有被hack过,两个TLE扣分分别来自电梯调度效率不足和第三单元某个方法的记忆化优化缺失——这属于性能问题而非逻辑错误。整体来看,策略驱动 + 极端手动构造 + 规则验证器的测试方法论,在复杂交互式系统的评测中表现出色,是我在整个OO课程中最有价值的实践经验之一。
回顾四个单元的OO学习,最大的收获不是掌握了某门编程语言或某个框架,而是一套从抽象设计到具体实现、从局部功能到系统集成的工程思维方法。
在架构层面,我经历了从“想到哪写到哪”到“先建模再编码”的转变。第一单元的重构让我认识到抽象接口和归一化表达式的重要性,第二单元的生产者-消费者模式和决策执行分离让我体会到架构设计对增量开发的巨大影响,第四单元的两阶类图实践让我真正理解了正向建模的价值。
在测试层面,从纯随机到策略驱动、从结果对拍到规则验证,我建立了一套可复用、可迭代的自动化测试体系。这套体系不仅在本课程中保护了我的分数,更重要的是让我理解了“测试是开发的一部分,而非开发后的附加步骤”这个现代软件工程的核心观念。
在大模型协作方面,四个单元的实践让我形成了清晰的协作模式:模型负责需求梳理、框架生成和简单错误的快速定位,我负责架构决策、关键算法实现和对模型输出的批判性审查。这种“人机分工”让我的开发效率成倍提升,但同时也让我更加确信——真正理解业务逻辑、做出正确架构权衡的能力,仍然是开发者不可替代的核心素养。

