


7,832
社区成员
 发帖
 与我相关
 我的任务

 分享
环境:犀牛派 X1(Qualcomm QCS8550)+ AidLux Ubuntu 22.04结果:MiniCPM5-2B W4A16 全程跑在 Hexagon NPU 上,实测约28 tokens/s,完全离线
之前一直觉得"端侧大模型"是个噱头——要么是 CPU 上硬扛,慢到没法用;要么是拿个 0.5B 的小模型意思一下。
这次在犀牛派 X1 上把MiniCPM5-2B跑通了,而且是实实在在跑在Hexagon NPU上:用高通的 QNN 2.48 后端,AidLux 官方的 AidGen SDK 做推理引擎。中文对话流畅,速度约 28 tokens/s,全程不联网。
这篇文章把整个流程记录下来,包括几个卡了我很久的坑。
|
项目 |
配置 |
|
开发板 |
犀牛派 X1(RhinoPi-X1) |
|
SoC |
Qualcomm QCS8550(kalama 平台) |
|
NPU |
Hexagon DSP,dsp_arch v73 |
|
内存 |
14 GiB + 7.4 GiB Swap |
|
存储 |
104 GB(可用约 85 GB) |
|
系统 |
Ubuntu 22.04.2 LTS(AidLux 2.0,内核 5.15.148-android13) |
版本清单:
aidgen-sdk 2.4.3.166 # 推理引擎主库
aidgen-qnn248 2.4.3.166 # QNN 2.48 后端插件
aidlux-aistack-base 1.3.1.169 # 被安装器降级过,见坑 2
aid-mms 1.2.61 # 模型下载工具
qairt/qnn248 /usr/local/lib/aidlux/qairt/qnn248
libaidgen.so.2.4.3 /usr/local/lib
AidLux 的 ModelFarm 里同一个模型通常有多个后端可选。以 Qwen3.5 系列为例:
$ mms list -a Qwen3.5
Model Precision Chipset SOC Backend
Qwen3.5-0.8B-llamacpp Q4_0 qcs8550 Qualcomm QCS8550 LlamaCPP
Qwen3.5-2B-llamacpp Q4_0 qcs8550 Qualcomm QCS8550 LlamaCPP
llama.cpp版本走 CPU/GPU,兼容性好、部署简单、跨平台,缺点是把活儿全压在 CPU 上——这块板子的 6 个核心跑 2B 模型,速度很难和 NPU 相比。
而 QNN 版本是为这颗 SoC 的 NPU 专门编译量化的:权重 W4A16(4bit 权重 + 16bit 激活),模型被打包成.aidem格式,由 QNN HTP 后端加载到 Hexagon DSP 上执行。代价是强绑定——模型包只能用于指定芯片 + 指定 QNN 版本,换块板子就得换包。
如果你只是想快速体验,llama.cpp 更省事;想吃满硬件性能,就必须走 QNN 这条路。
动手前先确认三件事:架构、内存、NPU 是否暴露。
$ uname -m
aarch64
$ cat /sys/devices/soc0/machine
QCS_KAILUA
$ free -h
total used free shared buff/cache available
Mem: 14Gi 4.5Gi 9.1Gi 48Mi 1.1Gi 9.6Gi
Swap: 7.4Gi 0B 7.4Gi
NPU 相关的设备节点可以在/usr/local/lib/aidlux/qairt/下找到,只要装了aidgen-qnn248这个包,运行库就是齐的:
$ ls -la /usr/local/lib/libaidgen*
libaidgen.so -> libaidgen.so.2
libaidgen.so.2 -> libaidgen.so.2.4.3
libaidgen.so.2.4.3
libaidgen_qnn248.so -> libaidgen_qnn248.so.2
libaidgen_qnn248.so.2.4.3
内存建议留 8 GB 以上:2B 模型的权重虽然只有 1.66 GB,但 QNN 还会额外申请 DMA 缓冲区做中间张量,加上桌面环境本身的开销,内存紧张时加载会直接失败(见坑 4)。
AidLux 默认的源指向开发环境,实测 TLS 握手会失败。先换成正式源:
sudo cp -n /etc/apt/aid_sources.list /etc/apt/aid_sources.list.before-minicpm5
echo 'https://appcenter.aidlux.com' | sudo tee /etc/apt/aid_sources.list
sudo aid-pkg update
sudo aid-pkg install aidgen-sdk --without-progress
sudo aid-pkg install aidgen-qnn248 --without-progress
依赖关系是自动解析的,aidgen-qnn248会依赖aidgen-sdk,aidgen-sdk又会依赖aidlms-sdk和aidlux-aistack-base。
安装过程中你会看到这样一行 warning:
dpkg: warning: downgrading aidlux-aistack-base from 1.3.1.175 to 1.3.1.169
这是正常现象——官方安装器把系统里的aidlux-aistack-base从 1.3.1.175 降到了 1.3.1.169,属于 SDK 侧要求的版本对齐。装完后本模型验证可运行。如果降级后你还有别的应用依赖新版,记得手动装回去。
验证安装:
aid-pkg installed | grep aidgen
# aidgen-qnn248 2.4.3.166
# aidgen-sdk 2.4.3.166
AidLux 提供mms(ModelFarm)命令行工具来下载官方模型。
mms login
会弹出浏览器或让你输入账号密码。注意:mms list不登录也能用,但mms get必须登录,否则返回MMS login required。
$ mms list -a MiniCPM5
Model Precision Chipset SOC Backend
-------------- --------- ------- ------------------------ -------
MiniCPM5-1B W4A16 qcs8550 Qualcomm QCS8550 QNN2.36
MiniCPM5-2B W4A16 qcs8550 Qualcomm QCS8550 QNN2.48
...
三个参数必须严格对上:模型名 / 精度 / 芯片 / 后端版本。
mms get \
-m MiniCPM5-2B \
-p W4A16 \
-c qcs8550 \
-b QNN2.48 \
-d /home/aidlux/models/minicpm5-2b
下载约 1.66 GB,得到qnn248_qcs8550_cl8192.zip(cl8192= context length 8192)。
mms get失败时仍然返回退出码 0。
如果你写脚本用$?判断下载是否成功,会被这个行为坑惨。比如我尝试下载 Qwen3.5-4B 时:
$ mms get -m Qwen3.5-4B -p W4A16 -c qcs8550 -b QNN2.48 -d ./package
Error: model not found. Invalid chipset for -c: qcs8550
$ echo $?
0
命令"成功"退出了,但目录里什么都没有。所以下载完必须检查文件是否真的存在:
ls -lh /home/aidlux/models/minicpm5-2b/qnn248_qcs8550_cl8192.zip
顺带一提,那个 Qwen3.5-4B 在官网页面上明确列着 QCS8550 / QNN2.48 / W4A16,但mms list里查不到,且页面的下载链接字段是空的,is_contact和is_commercial都是 true。官网展示 ≠ 你能下载,页面上的参数不能当作可下载的依据,一切以mms list为准。
解压后目录长这样:
rnn248_qcs8550_cl8192/
├── aidgen_config.json # AidGen 引擎入口配置
├── minicpm5-2b-htp.json # QNN HTP 后端详细参数
├── htp_backend_ext_config.json # DSP 扩展配置(性能档位)
├── aidgen_chat_template.txt # 官方对话模板示例
├── minicpm5-2b-tokenizer.json # 词表(约 9.4 MB)
├── minicpm5-2b_qnn248_qcs8550_cl8192_1_of_4.serialized.bin.aidem # 546 MB
├── ..._2_of_4.serialized.bin.aidem # 368 MB
├── ..._3_of_4.serialized.bin.aidem # 368 MB
├── ..._4_of_4.serialized.bin.aidem # 646 MB
└── prefix-kvcache/
├── kv-cache.primary.qnn-htp # 预编译 KV Cache(22 KB)
└── dialog.json
几个关键点:
aidgen_config.json内容很简洁,主要就是告诉引擎去哪儿找权重:
{
"backend_type": "genie",
"prefix_path": "prefix-kvcache/kv-cache.primary.qnn-htp",
"model": {
"path": [
"minicpm5-2b_qnn248_qcs8550_cl8192_1_of_4.serialized.bin.aidem",
"minicpm5-2b_qnn248_qcs8550_cl8192_2_of_4.serialized.bin.aidem",
"minicpm5-2b_qnn248_qcs8550_cl8192_3_of_4.serialized.bin.aidem",
"minicpm5-2b_qnn248_qcs8550_cl8192_4_of_4.serialized.bin.aidem"
]
}
}
真正的性能参数在minicpm5-2b-htp.json里:
{
"context": { "size": 8192, "n-vocab": 130560, "bos-token": -1, "eos-token": [1, 130073] },
"sampler": { "seed": 42, "temp": 1, "top-p": 0.95, "top-k": 20, "greedy": false },
"engine": {
"n-threads": 3,
"backend": {
"type": "QnnHtp",
"QnnHtp": {
"kv-dim": 128,
"use-mmap": true,
"cpu-mask": "0xe0"
}
},
"model": {
"positional-encoding": { "type": "rope", "rope-dim": 64, "rope-theta": 5000000 }
}
}
}
注意"cpu-mask": "0xe0"—— 二进制1110_0000,即只使用5 / 6 / 7 号核心,也就是 SoC 上频率最高的那三个大核;配合n-threads: 3,把推理线程锁在大核上,避免被小核拖慢。这是端侧推理很典型的调优手法。
这块板子上 Linux 能看到的核心频率分布,也能印证这个设计意图:
cpu0 ~ cpu2 : 2016000 Hz # 小核
cpu3 ~ cpu4 : 2803200 Hz # 中核
cpu5 : 3187200 Hz # 超大核
AidGen SDK 提供的是 C++ 头文件接口(aidlux/aidgen/aidgen.hpp),核心就三个类:Context(引擎上下文)、Generator(生成器)、Tokenizer。
核心代码chat.cpp(为便于阅读,这里省略了语音输入部分):
#include "aidlux/aidgen/aidgen.hpp"
#include <iostream>
#include <string>
#include <cstdio>
using namespace aplux::aidgen;
int mainintargc,char**argv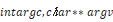 {
set_log_level(LogLevel::ERROR);
ContextProperties props;
props.stream = true; // 流式输出
props.enable_profiler = true; // 打开性能统计,用来测速
props.enable_prompt_cache = false;
auto ctx = Context::create_instance("aidgen_config.json", props, BackendType::QNN248);
if (!ctx) return 1;
auto ec = ctx->initialize();
if (ec != ErrorCode::SUCCESS) {
std::cerr << "Context initialization failed: " << int(ec) << '\n';
return 1;
}
auto gen = Generator::create_instance(ctx);
if (!gen) return 1;
ec = gen->initialize();
if (ec != ErrorCode::SUCCESS) {
std::cerr << "Model loading failed: " << int(ec) << '\n';
return 1;
}
std::string input;
bool first = true;
while (true) {
std::cout << "\n你:" << std::flush;
if (!std::getline(std::cin, input) || input == "/quit") break;
if (input.empty()) continue;
// 关键:多轮对话必须手动 reset,否则上下文会串
if (!first && gen->reset() != ErrorCode::SUCCESS) return 1;
first = false;
// 严格按模型自带模板构造提示词
std::string prompt = "<s> <|im_start|>user\n" + input +
"<|im_end|>\n<|im_start|>assistant\n<think>\n\n</think>\n";
bool failed = false, ended = false;
std::cout << "模型:" << std::flush;
ec = gen->run(prompt, [&](const GenEvent& event, void*) {
if (event.state == GenState::ERROR || event.state == GenState::ABORT) failed = true;
if (event.state == GenState::END) ended = true;
std::cout << event.text << std::flush; // 流式打印
});
std::cout << '\n';
if (ec != ErrorCode::SUCCESS || failed || !ended) {
std::cerr << "Generation failed or incomplete: " << int(ec) << '\n';
return 1;
}
ProfileData perf;
if (gen->get_profiler(perf) == ErrorCode::SUCCESS)
std::cerr << "[速度 " << perf.generator.generate_tps << " tokens/s,生成 "
<< perf.generator.generated_token_count << " tokens]\n";
}
return gen->finalize() == ErrorCode::SUCCESS ? 0 : 1;
}
编译(注意-Wl,-rpath,少了这一步运行时会找不到libaidgen.so.2):
cd /home/aidlux/models/minicpm5-2b
g++ -std=c++17 -O2 chat.cpp -o minicpm-chat \
-L/usr/local/lib -Wl,-rpath,/usr/local/lib -laidgen -pthread
配套的启动脚本chat.sh很简单,就是切到模型目录(因为aidgen_config.json里的路径是相对路径):
#!/usr/bin/env bash
set -euo pipefail
cd /home/aidlux/models/minicpm5-2b/qnn248_qcs8550_cl8192
exec ../minicpm-chat "$@"
运行:
bash /home/aidlux/models/minicpm5-2b/chat.sh
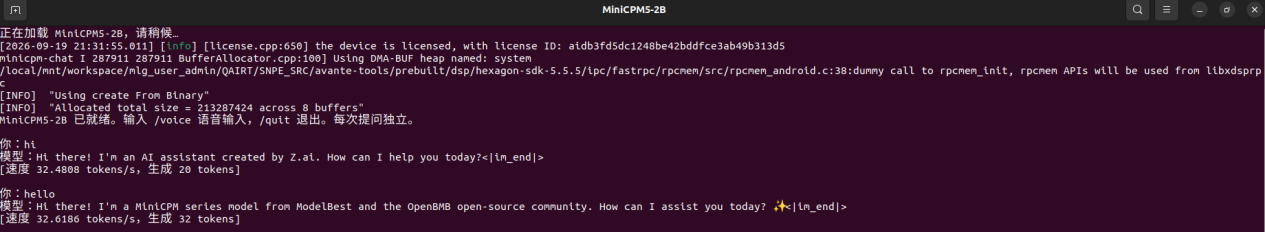
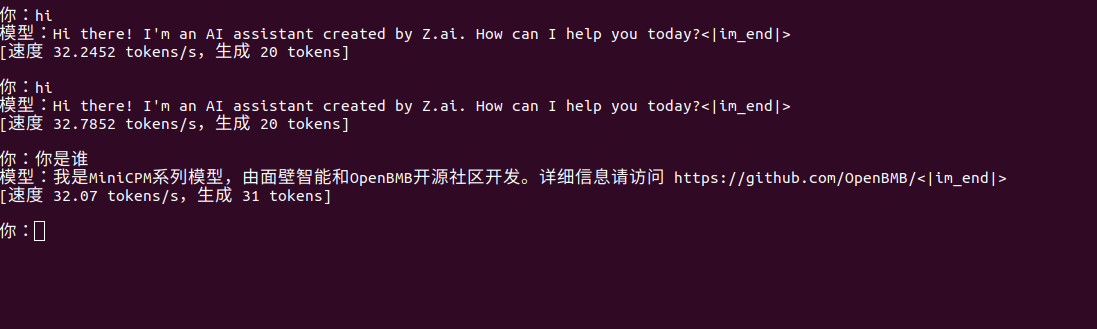
启动后会看到引擎申请 DMA 缓冲区并加载权重:
[info] [license.cpp:650] the device is licensed, with license ID: aid****
BufferAllocator.cpp:100] Using DMA-BUF heap named: system
[INFO] "Using create From Binary"
[INFO] "Allocated total size = 213287424 across 8 buffers"
Allocated total size = 213287424—— 运行期额外申请了约213 MB的 DMA 缓冲(8 个 buffer),这部分是除权重之外的内存开销。
然后是对话:
你:请介绍一下你自己
模型:我是 MiniCPM5-2B,一个轻量级的中文大语言模型……
[速度 28.18 tokens/s,生成 35 tokens]
实测数据:
|
指标 |
数值 |
|
生成速度 |
约 28.18 tokens/s |
|
单次生成量 |
35 tokens |
|
权重体积 |
1.66 GB(zip)/ 约 1.9 GB(解压) |
|
运行期 DMA 缓冲 |
213 MB |
|
上下文长度 |
8192 |
|
精度 |
W4A16 |
|
后端 |
QNN 2.48 / Hexagon HTP v73 |
连续提问也验证过:1+1返回 2,中国首都是哪里返回北京,程序正常退出(退出码 0)。
aid-pkg update报 TLS 连接错误,换成正式源https://appcenter.aidlux.com后解决。记得备份原文件。
aidlux-aistack-base从 1.3.1.175 降到 1.3.1.169。不影响本模型,但如果你还有别的应用依赖新版,降级后可能出问题,需要手动恢复。
见 6.4 节。这是最阴的一个坑——脚本里判断退出码完全不可靠,必须检查产物文件是否存在。
这个是踩得最惨的。桌面窗口开着聊天没关,我再开一个终端跑命令行版,直接崩:
[INFO] "Allocated total size = 213287424 across 8 buffers"
[ERROR] "Could not create context from binary for context index = 2 : err 1002"
[ERROR] "Create From Binary FAILED!"
[E][implqnn248.cpp:1008][AIDG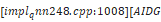 EN:Backend:QNN248] Failed to create the dialog
Model loading failed: -20
err 1002是 NPU 侧的资源创建失败——NPU 上下文已经被占用(或者内存不足)。排查方法:
pgrep -af minicpm-chat # 看是不是还挂着旧进程
free -h # 看可用内存
杀掉残留进程后重新启动即可:
pkill -f minicpm-chat
结论:minicpm-chat是单实例资源模型,同一时间只能有一个进程持有 NPU 上下文。桌面快捷方式和终端命令行不要同时开。
gen->run()是累积式的,不会自动清空历史。如果上一句问了"1+1",下一句问"那 2+2 呢",模型会带着前面的 KV 状态继续生成。
解决办法就是每轮之前调一次gen->reset():
if (!first && gen->reset() != ErrorCode::SUCCESS) return 1;
我这边做成了每个问题互相独立的模式——简单、可预测,不会出现上下文越滚越长导致速度下降的问题。如果你要做真正的多轮对话,就别 reset,但要注意 context size 8192 的上限。
MiniCPM5 是思考模型,模板必须严格按官方aidgen_chat_template.txt来:
<s><|im_start|>user
{你的问题}<|im_end|>
<|im_start|>assistant
<think>
</think>
注意最后的<think>\n\n</think>\n——这是非思考模式的写法,用一个空的 think 块让模型直接出答案。
如果你漏掉,或者自己随便写个User: xxx\nAssistant:,模型要么输出乱码,要么把思考过程全吐出来,速度也会因为多生成一堆 token 而暴跌。
只写-laidgen不写-Wl,-rpath,/usr/local/lib,编译能过,但运行时:
error while loading shared libraries: libaidgen.so.2: cannot open shared object file
因为/usr/local/lib不一定在ld.so的默认搜索路径里。加上 rpath 最省事。
打字麻烦,加了个语音输入:在聊天窗口输入/voice,按回车开始录音,再按回车结束,识别结果会显示出来,确认后发送。
用的是Vosk 小型中文模型(vosk-model-small-cn-0.22,43 MB),本地离线识别,不联网、不上传、不保存录音。
核心是parec按 16 kHz / 单声道拉流喂给识别器:
command = ['parec', '--raw', '--format=s16le', '--rate=16000', '--channels=1']
command.append('--device=' + source)
这里有两个实测发现的细节:
1. 麦克风端口要选对。犀牛派 X1 的红色 LINE IN 口,在 PulseAudio 里实际对应headset-mic端口,另外两个端口(speaker-mic、handset-mic)接同样的麦克风都采不到声音。所以代码里做了强制端口切换:
DEFAULT_QAL_PORT = 'headset-mic'
# 通过 pactl set-source-port regular0 headset-mic 切换
2. 板载没有麦克风。官方音频规格只有 3.5mm Line in / Line out,而且 Line in 是线路电平输入,需要带前置放大的麦克风,普通驻极体麦克风直插基本没信号。最省事的是插一个USB 麦克风/耳麦,免驱,系统直接识别。
脚本会优先挑名称或描述里带USB的录音设备。另外还加了静音电平检测——如果录完全程电平接近 0,直接提示"没有采到声音"并说明需要外接麦克风,而不是让你对着一句"识别失败"发呆。
每次敲命令太麻烦,加个.desktop文件放到~/Desktop/:
[Desktop Entry]
Type=Application
Name=MiniCPM5 本地聊天
Comment=MiniCPM5-2B QCS8550 NPU
Exec=/usr/bin/gnome-terminal --wait --title=MiniCPM5-2B -- /bin/bash /home/aidlux/models/minicpm5-2b/desktop-chat.sh
Icon=utilities-terminal
Terminal=false
Categories=Utility;
desktop-chat.sh做了一件事:出错时不让窗口立刻消失,方便看错误信息。
#!/usr/bin/env bash
printf '正在加载 MiniCPM5-2B,请稍候…\n'
bash /home/aidlux/models/minicpm5-2b/chat.sh
status=$?
if [ "$status" -ne 0 ]; then
printf '\n模型启动或运行失败(退出码 %s),请保留上面的错误信息。\n' "$status"
read -r -p '按回车关闭窗口…'
fi
exit "$status"
这个很有必要——双击图标启动的终端窗口如果程序崩了会瞬间关闭,你根本来不及看err 1002之类的错误。
整体流程其实就六步:
几点体会:
后面想试试给模型挂上工具调用(function calling),让它能真正干点活,而不只是聊天。如果有进展再写一篇。
本文部署记录于 2026-09-19,环境为犀牛派 X1 + AidLux 2.0(Ubuntu 22.04)/ QCS8550 / QNN 2.48。

