犀牛派X1使用mid-360激光雷达(入门方法)
社区首页 (3679)
 我加入的社区 我管理的社区 官方推荐社区
76
其他社区
3679
请编写您的帖子内容
社区频道(14)
显示侧栏
卡片版式
全部
AI 开发
边缘智能
骁龙 PC
IoT 物联网
XR/VR/AR/MR
Gaming 游戏
Auto 汽车
开发者中文专区
博客
活动
资讯
视频
硬件开发案例
最新发布
最新回复
标题
阅读量
内容评分
精选
28
评分
回复


犀牛派X1使用mid-360激光雷达(入门方法)
简要概述:本文主要指导mid-360的入门使用,从驱动出点云,到利用FAST-LIO2建图,进而利用其导航避障等,给出了具体学习路线,让路径变得明晰。 可以通过这个网页互动app来跟踪指导自己的学习进度,更加详细的指导尽在这里。 https://30
复制链接 扫一扫
分享
IoT 物联网
43
评分
回复

NPU 架构总览:为什么边缘侧需要专用 AI 加速器
边缘 AI 的三道墙,把模型从训练服务器搬到设备端,第一件事不是「怎么跑」,而是「为什么必须换个硬件跑」
复制链接 扫一扫
分享
AI 开发
46
评分
回复
高通QNN部署避坑实录:SDK版本矩阵、HTP上下文、NPU串行锁——官方文档没说的9个坑
1. **先查版本,再改参数**。90% 的诡异报错都是版本问题,报错信息永远不会告诉你这一点。 2. **别信日志,信延迟**。端侧部署最大的陷阱是"静默降级"——代码没报错,但根本没走 NPU。用延迟数字来判断。
复制链接 扫一扫
分享
AI 开发
52
评分
回复

高通 QCS6490 实战:低功耗边缘端部署 1.5B/3B SLM + 多模态离线智能体 Demo
低功耗边缘端部署 1.5B/3B SLM:高通芯片上的多模态端侧智能体实战 拿到瑞莎 Dragon Q6A(Radxa Dragon Q6A)之后,如果只是跑一个普通的视觉检测,多少有点浪费这块板子搭载的高通 QCS6490 芯片与 12 TOPS
复制链接 扫一扫
分享
AI 开发
58
评分
回复

瑞莎Q6A实战:把开源 MindPaw 改造成端侧 AI 情感机器狗
它是一只桌面级四足机器狗,犀牛派 A1 实战,把开源 MindPaw 改造成端侧 AI 情感机器狗
复制链接 扫一扫
分享
边缘智能
45
评分
1
在 Windows on Snapdragon 上开发本地语音助手,把 Whisper 模型部署到 NPU 时,音频切片和推理调度怎么设计更合理?
在 Windows on Snapdragon 上开发本地语音助手,把 Whisper 模型部署到 NPU 时,音频切片和推理调度怎么设计更合理?
复制链接 扫一扫
分享
AI 开发
40
评分
1
AI PC 上部署 Stable Diffusion 类文生图模型时,Adreno GPU 显存不足导致生成失败,通常有哪些缓解方案?
AI PC 上部署 Stable Diffusion 类文生图模型时,Adreno GPU 显存不足导致生成失败,通常有哪些缓解方案?
复制链接 扫一扫
分享
AI 开发

47
评分
1

在骁龙设备上用 TensorFlow Lite 调用 QNN delegate,模型推理速度反而不如 CPU,可能是哪些原因?
在骁龙设备上用 TensorFlow Lite 调用 QNN delegate,模型推理速度反而不如 CPU,可能是哪些原因?
复制链接 扫一扫
分享
AI 开发
50
评分
1

QNN 模型转换时,部分 ONNX 算子显示“unsupported op”导致转换失败,应该优先按什么顺序排查?
QNN 模型转换时,部分 ONNX 算子显示“unsupported op”导致转换失败,应该优先按什么顺序排查?
复制链接 扫一扫
分享
AI 开发
55
评分
回复
把 GPT-SoVITS 搬上高通 QCS8550 NPU:从训练好的音色到 OpenAI 兼容 TTS 服务
一台高通 QCS8550 开发板,一个用 GPT-SoVITS v2Pro 训练好的中文音色。目标很简单:让它在板子的 NPU 上跑起来,并且像 OpenAI 的 /v1/audio/speech 一样可以直接调用。过程并不简单——静态图改写、8
复制链接 扫一扫
分享
边缘智能
72
评分
2

没有清闲座椅怎么办?在犀牛派 X1 上做一个工位 AI 教练:姿态识别、久坐监测与体感交互
设备:犀牛派 X1(高通 QCS8550,AidLux / Ubuntu 22.04)|相机:Logitech C920,/dev/video2,1280×720 MJPG|姿态:AidLite TFLite GPU,float32,上半身 31 点
复制链接 扫一扫
分享
AI 开发
62
评分
回复

犀牛派 X1 从刷机到上手:AidLux 3.0.0.124、USB 摄像头和 QNN236 体检
设备:犀牛派 X1(高通 QCS8550,kalama)|系统:Android 13 + AidLux 3.0.0.124,Ubuntu 22.04,内核 5.15.178-android13|日期:2026-09-15 实刷,2026-09-28
复制链接 扫一扫
分享
边缘智能
96
评分
回复
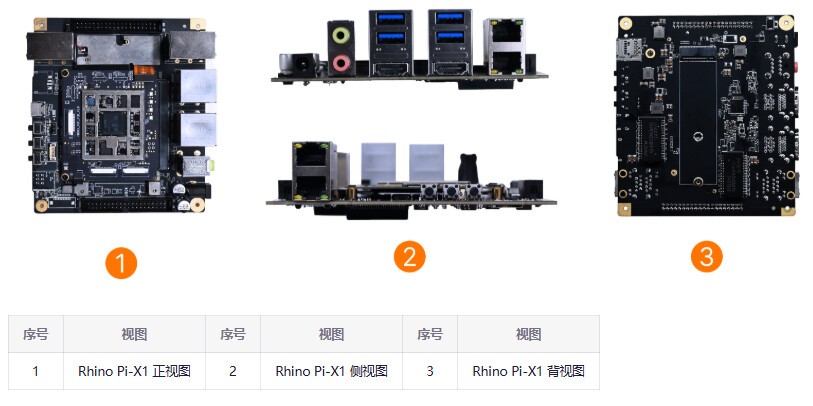
把 Qwen3-Reranker 搬上高通 NPU:在 FV01 上跑通 4096 token 重排序的全过程
设备:FV01 开发板(高通 QCS8550,Ubuntu 22.04)|模型:Qwen3-Reranker-0.6B|精度:fp16本文流程同样适用于犀牛派 X1 开发板。代码与模型:https://github.com/zhouzengming
复制链接 扫一扫
分享
边缘智能
94
评分
回复
没买犀牛派 X1,也能先做什么?公开规格核对与基线采集模板
本文适合还没拿到犀牛派 X1、但想提前准备实验的人。你将得到一份公开规格核对表、Linux/ADB 基线采集命令,以及设备到手后的验证清单。本文没有 X1 板端实测,所有模拟输出都只是记录格式示例。 一 为什么先建立基线 边缘 AI 开发会同时涉及系
复制链接 扫一扫
分享
边缘智能
94
评分
回复
犀牛派 X1 性能实测:CPU、GPU、内存与存储跑分及温度功耗分析
一、测试背景 最近对一块基于高通 QCS8550 平台的犀牛派 X1 开发板进行了性能测试,主要关注以下几个方面: CPU 单核和多核性能; GPU 图形与计算性能; 内存带宽; 存储读写速度; 空载和满载温度; 满载功耗以及长时间运行时的降频情况
复制链接 扫一扫
分享
边缘智能
94
评分
回复
犀牛派 X1 实战:使用 Ollama 部署 Qwen 1.8B,附 API 参数与性能实测
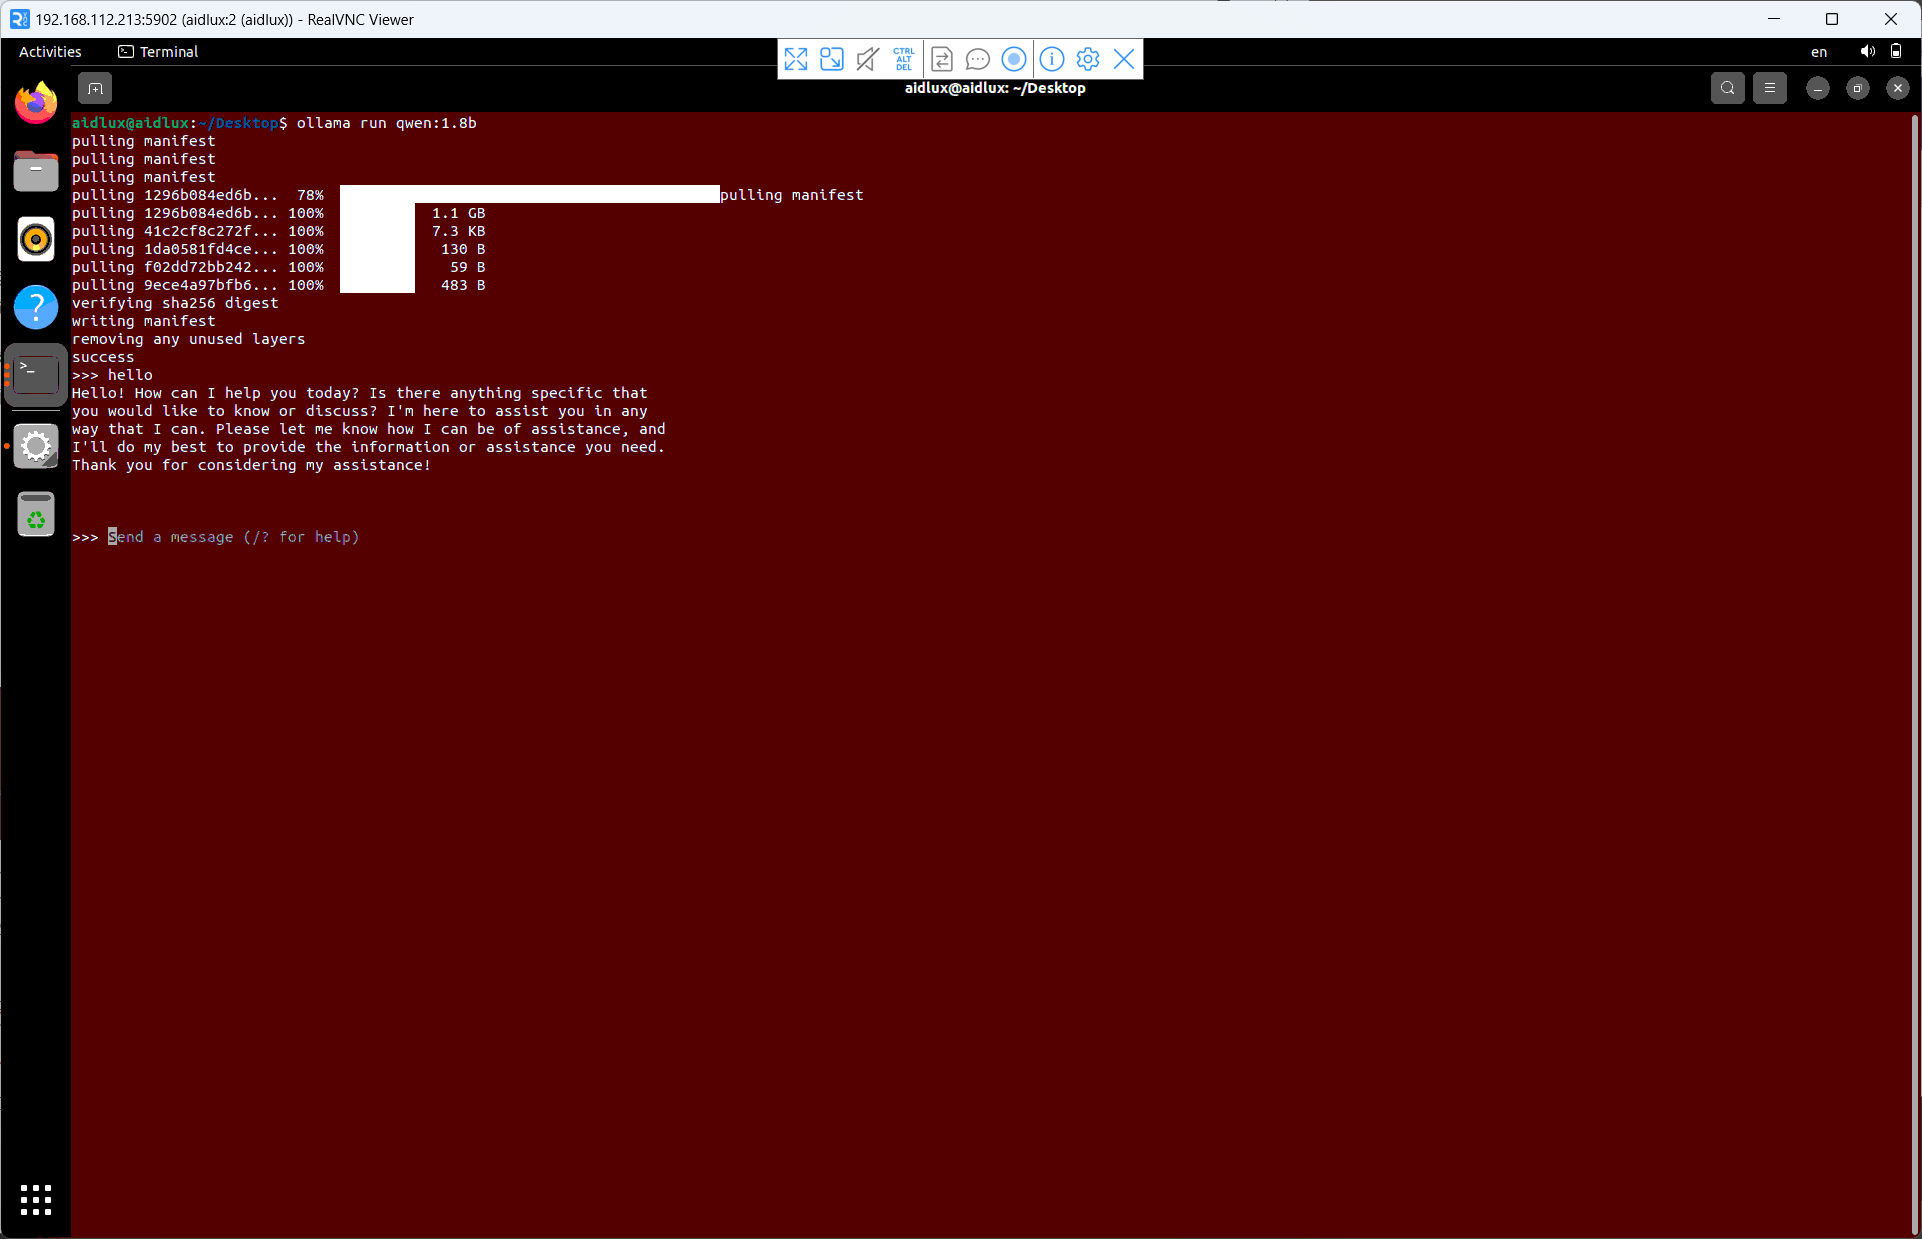
本文记录在犀牛派 X1 上通过 Ollama 部署qwen:1.8b的完整过程,并使用 Ollama API 测试模型加载时间、输入速度、输出速度和 CPU 占用。文章最后还会分析中文提示词乱码、首轮加载时间和上下文长度带来的影响。 一、测试目标
复制链接 扫一扫
分享
边缘智能
77
评分
1

骁龙 AI PC 本地部署 LLM,开启 HTP burst 模式可以提升 token 生成速度,该参数如何配置,开启后需要关注哪些日志指标?
骁龙 AI PC 本地部署 LLM,开启 HTP burst 模式可以提升 token 生成速度,该参数如何配置,开启后需要关注哪些日志指标?
复制链接 扫一扫
分享
骁龙 PC
82
评分
1

高通 QNN 自定义算子开发,在 Hexagon HTP 上实现自定义算子,为什么不能直接使用 malloc/new 做动态内存分配?
高通 QNN 自定义算子开发,在 Hexagon HTP 上实现自定义算子,为什么不能直接使用 malloc/new 做动态内存分配?
复制链接 扫一扫
分享
AI 开发
81
评分
1

Snapdragon Spaces Unity 项目,Dual Render Fusion 模式下 App 退到后台,XR 内容会停止渲染,这个机制是什么,如何按需修改业务逻辑?
Snapdragon Spaces Unity 项目,Dual Render Fusion 模式下 App 退到后台,XR 内容会停止渲染,这个机制是什么,如何按需修改业务逻辑?
复制链接 扫一扫
分享
XR/VR/AR/MR
85
评分
1

骁龙 AI PC 上,用 llama.cpp 调用 Adreno GPU 跑本地 LLM,需要提前准备哪些依赖,编译时要开启什么编译选项?
骁龙 AI PC 上,用 llama.cpp 调用 Adreno GPU 跑本地 LLM,需要提前准备哪些依赖,编译时要开启什么编译选项?
复制链接 扫一扫
分享
骁龙 PC
为您搜索到以下结果:
7,748
社区成员
6,466
社区内容
 发帖
 与我相关
 我的任务

高通开发者论坛
本论坛以AI、IoT、PC 、XR、Auto等核心板块组成,为开发者提供便捷及高效的学习和交流平台。
高通开发者专区主页:https://qualcomm.csdn.net/
复制链接 扫一扫
 分享
确定
社区描述
本论坛以AI、IoT、PC 、XR、Auto等核心板块组成,为开发者提供便捷及高效的学习和交流平台。
高通开发者专区主页:https://qualcomm.csdn.net/ 物联网人工智能开源 企业社区 北京·东城区
社区管理员

加入社区
获取链接或二维码

- 近7日
- 近30日
- 至今
加载中
社区公告
暂无公告