


7,697
社区成员
 发帖
 与我相关
 我的任务

 分享
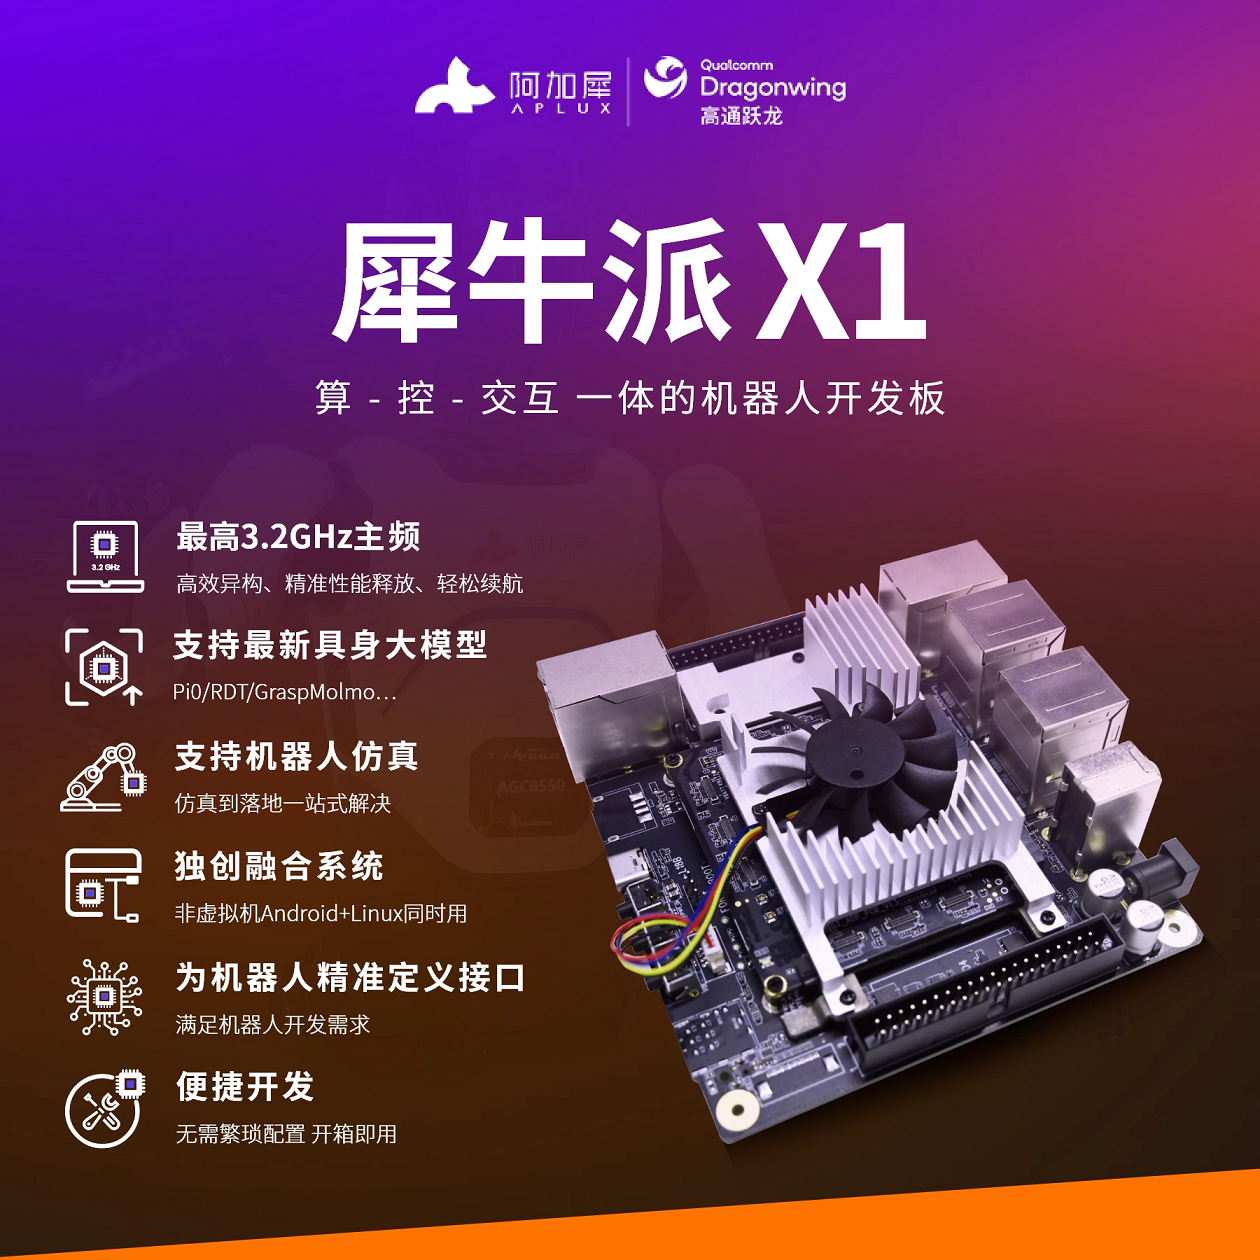
Dragonwing(跃龙):高通面向工业 / 嵌入式 IoT、边缘 AI、机器人、无人机、智能视觉等企业级场景的品牌。
Snapdragon(骁龙):面向手机、平板、笔电、车载等消费级终端。
QCS8550 是 Dragonwing Q8 系列旗舰,4nm、Adreno 740 GPU、Hexagon NPU、Wi‑Fi 7,主打高性能边缘 AI 与异构计算。
Hexagon SDK 是面向 DSP/NPU 的底层通用开发工具链;
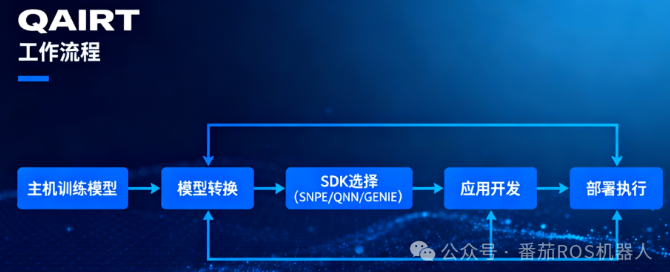
QAIRT 是面向 AI 模型的上层推理部署栈(含原 QNN、SNPE、GENIE)。两者在层级、用途、接口和使用方式上完全不同。
一、定位与层级对比
Hexagon SDK(底层通用 DSP/NPU 开发)
全称:Qualcomm Hexagon SDK
层级:硬件层 / 系统层 —— 直接对 Hexagon DSP/HTP 做原生编程
核心用途:
编写、编译、调试C/C++ 算法,跑在 Hexagon DSP/HTP 上
利用 HVX(512/1024 位向量扩展) 做图像 / 视频 / 信号处理
开发非 AI 类高性能计算任务(滤波、FFT、编解码、传感器融合)
运行时:自带 QuRT(DSP 实时 OS),管理 DSP 线程与调度
典型输出:.so 或 .elf —— DSP 原生可执行文件 / 库
QAIRT(上层 AI 推理部署栈)
全称:Qualcomm AI Runtime(原 QNN SDK + SNPE + GENIE 整合而来)
层级:应用层 / AI 推理层 —— 面向训练好的 AI 模型(ONNX/TensorFlow/PyTorch)
核心用途:
模型转换 + 量化 + 优化:把 PC 训练的模型转成高通硬件可执行格式(.dlc/.qnn)
多硬件调度:自动分配算子到 CPU/GPU/HTP(NPU),异构并行
推理 API:提供 C/C++/Python 接口,直接在 App 里调用 AI 推理
典型输出:优化好的模型文件(.dlc/.qnn)+ 推理运行时库
二、核心区别(表格)
|
对比项 |
Hexagon SDK |
QAIRT(含 QNN/SNPE/GENIE) |
|---|---|---|
| 开发对象 |
DSP/HTP 硬件本身、C/C++ 算法 |
训练好的 AI 模型(ONNX/TF/PT) |
| 编程方式 |
手写 C/C++,调用 HVX intrinsics |
模型转换工具( |
| AI 支持 |
无内置 AI 框架,需手动写算子 |
原生支持 CNN/Transformer/LLM,自动算子映射 |
| 适用场景 |
音视频编解码、信号处理、传感器融合、自定义算法 |
图像分类、检测、分割、NLP、LLM、AIoT 推理 |
| 硬件调度 |
手动指定 DSP/HTP |
自动异构(CPU/GPU/HTP) |
| 上手难度 |
高(需懂 DSP 架构、HVX、QuRT) |
中(熟悉模型转换 + API 即可) |
| 代表工具 |
qcc 编译器、qdsp6 调试器、hexagon-sim |
qnn-converter、qairt-visualizer、snpe-net-run |
三、与 QCS8550(Dragonwing)的关系
Hexagon SDK:QCS8550 内置 Hexagon HTP(NPU),Hexagon SDK 是开发 HTP 底层算法的必备工具。
QAIRT:QCS8550 官方推荐的 AI 部署栈,支持 INT8/FP16 量化、HTP 加速、LLM 推理,是边缘 AI 落地的首选。
四、如何选择?
如果你要手写 DSP 算法、做底层信号处理、自定义算子 → 用 Hexagon SDK。
如果你要部署现成 AI 模型(CNN/LLM)、快速落地 AI 应用 → 用 QAIRT(QNN)。
Qualcomm® AI Runtime (QAIRT) SDK 和 Qualcomm AI Engine Direct SDK 区别
一、整体关系(别再混淆)
从 v2.32.0 开始,高通把原来三个名字统一收归到 QAIRT SDK 产品下:
Qualcomm AI Runtime (QAIRT) SDK
包含三大组件:
QNN(Qualcomm AI Engine Direct) —— 底层、高性能、细控制
SNPE(Snapdragon Neural Processing SDK) —— 高层、简单、自动调度
GENIE —— LLM / 生成式 AI 扩展(基于 QNN)Qualcomm
也就是说:QNN ≠ QAIRT,QNN 是 QAIRT 的一部分;QAIRT 是大合集。
二、Qualcomm AI Runtime (QAIRT) SDKs
定位:高通官方统一 AI 推理栈,面向所有高通平台(手机 / 车载 / 边缘 / 机器人)
工具链:模型转换、量化、编译、性能分析
多个 runtime:SNPE、QNN、GENIE
统一安装包:下载一次 QAIRT,里面包含 SNPE 和 QNN 目录Qualcomm
用途:从简单 Demo 到量产高性能、从 CV 到 LLM 全覆盖
三、Qualcomm AI Engine Direct SDK(QNN)
别名:QNN SDK、Qualcomm Neural Network
定位:更贴近硬件的底层推理 SDK,为极致性能和精细控制设计
核心特点:
细粒度控制:可指定每个算子跑在 CPU/GPU/HTP/DSP
高性能 + 小体积:编译成平台专属 .so/.bin,内存占用最小
模块化后端:CPU/GPU/HTP 独立库,按需链接
自定义算子强:方便写 HVX/HTP 原生算子
典型输出:
libQnnModel.so(模型库)
context.bin(HTP 专用二进制)
适用场景:量产、高帧率、低时延、大模型、自定义算子
四、SNPE(对比理解)
高层 API,简单易用
自动异构调度:自动分配 CPU/GPU/HTP
输出统一 .dlc,跨平台好
代价:体积更大、控制粒度粗、性能略低于 QNN
五、一张表总结区别
|
对比项 |
QAIRT SDKs |
AI Engine Direct(QNN) |
SNPE |
|---|---|---|---|
| 层级 |
总框架 / 产品包 |
底层高性能 runtime |
高层易用 runtime |
| 关系 |
包含 QNN、SNPE、GENIE |
QAIRT 的子集 |
QAIRT 的子集 |
| 控制粒度 |
可选 QNN(细)或 SNPE(粗) | 极细
(算子级) |
粗(自动调度) |
| 性能 |
取决于所选 runtime | 最高 |
中等 |
| 上手难度 |
可选(SNPE 易,QNN 难) |
较难 |
简单 |
| 适合 |
全场景开发 |
量产、高性能、LLM |
快速原型、Demo、简单部署 |
六、在 QCS8550(Dragonwing)上怎么选
做产品、追求极致性能 / 低时延 / LLM → 用 QNN(AI Engine Direct)
快速验证、Demo、不想调硬件细节 → 用 SNPE(在 QAIRT 包里)
开发 DSP/HTP 原生算法 → 用 Hexagon SDK(和 QAIRT 互补)


