


7,720
社区成员
 发帖
 与我相关
 我的任务
 分享
最近对一块基于高通 QCS8550 平台的犀牛派 X1 开发板进行了性能测试,主要关注以下几个方面:
犀牛派 X1 并不是传统意义上的桌面电脑,而是一款面向机器人、边缘计算、计算机视觉和端侧 AI 应用的嵌入式开发平台。因此,本次测试除了关注瞬时跑分,也重点观察连续负载下的性能稳定性。
犀牛派 X1(Rhino Pi-X1)采用高通 QCS8550 平台,官方定位为高性能嵌入式计算设备,适用于边缘人工智能、工业物联网和机器人开发。
公开资料显示,该平台具备以下特点:
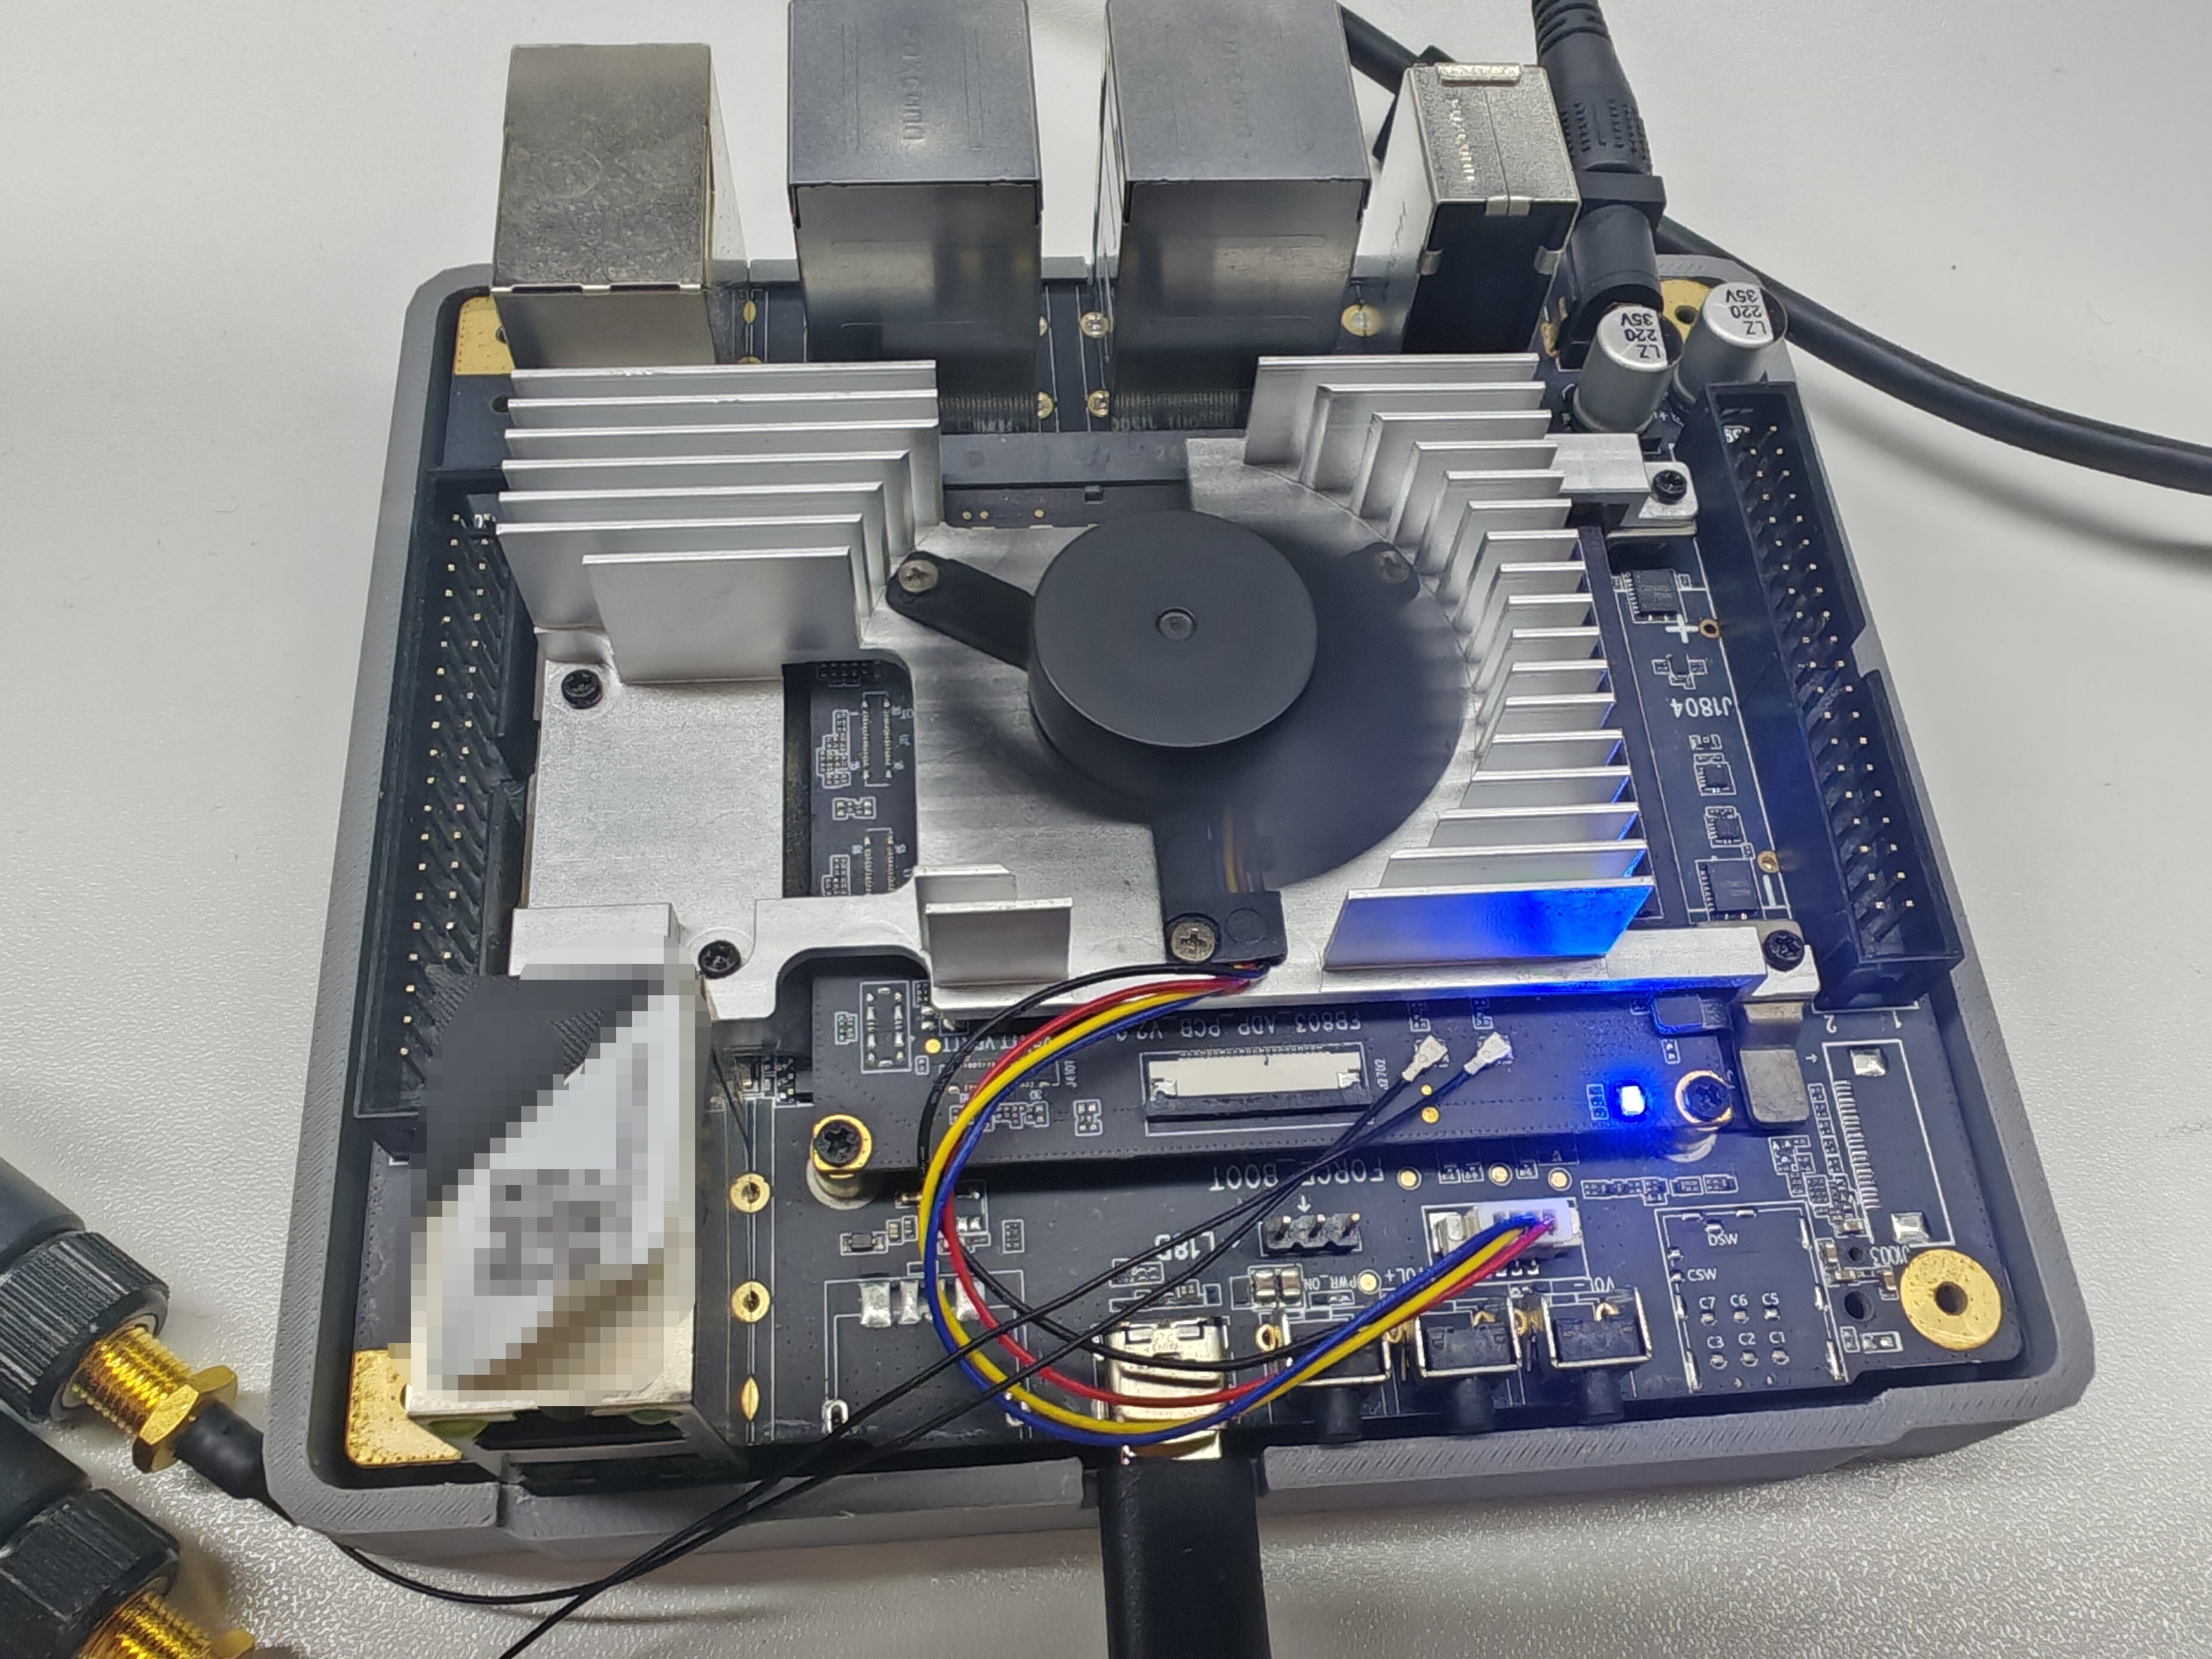
图 1:犀牛派 X1 开发板及主动散热装置
从照片可以看到,本次测试使用了金属散热片加主动风扇的组合,开发板上还连接了多组高速接口和扩展线缆。
| 项目 | 测试配置 |
|---|---|
| 开发板 | 犀牛派 X1 |
| 主控平台 | Qualcomm QCS8550 |
| 系统 | AidLux / Linux |
| 内存 | 8 GB |
| 存储设备 | 256 GB NVMe 固态硬盘 |
| 散热方式 | 金属散热片 + 主动风扇 |
| 电源 | 12 V / 3 A |
| 环境温度 | 25℃ |
| Geekbench 版本 | Geekbench 6.3.0 |
| 测试时间 | 2026 年 9 月 |
| 测试模式 | 性能模式,风扇开启 |
测试前关闭后台下载、文件同步和不必要的应用程序,每轮测试前让开发板空载运行约 5 分钟。
Geekbench 主要测试 CPU 的整数、浮点、加密以及多核协同能力。本次测试连续运行三次,取中位数作为最终成绩。
| Geekbench 项目 | 第 1 次 | 第 2 次 | 第 3 次 | 中位数 |
|---|---|---|---|---|
| Single-Core | 1,226 | 1,218 | 1,221 | 1,221 |
| Multi-Core | 4,286 | 4,246 | 4,271 | 4,271 |
从结果来看,犀牛派 X1 的单核性能比较稳定,三次测试差异小于 1%。多核测试中,第二次成绩略低于第一次,说明在连续运行过程中已经出现轻微的温度影响,但整体波动不大。
Linux 下可以使用以下命令查看系统和 CPU 信息:
uname -a
cat /proc/cpuinfo
lscpu
CPU 频率监控命令:
watch -n 1 "cat /sys/devices/system/cpu/cpu*/cpufreq/scaling_cur_freq"
CPU 满载测试使用:
stress-ng --cpu 8 --timeout 10m --metrics-brief
满载期间,CPU 占用率基本保持在 95% 以上,最高频率约为 2.84 GHz,运行 10 分钟后稳定在约 2.65 GHz。
本次 GPU 测试使用 Geekbench Compute 和 glmark2,重点观察 GPU 计算成绩、帧率以及温度变化。
| GPU 测试项目 | 测试结果 |
|---|---|
| Geekbench Compute | 6,430 |
| GFXBench Manhattan | 约 108 FPS |
| glmark2 总分 | 2,184 |
| 1080p 实际渲染帧率 | 约 96 FPS |
在短时间测试中,GPU 能够维持较高频率。连续运行约 10 分钟后,GPU 温度稳定在 69℃左右,帧率相比测试初始阶段下降约 4%。
内存带宽测试使用 mbw 和 sysbench,结果如下:
mbw 1024
sysbench memory --memory-block-size=1M --memory-total-size=10G run
| 内存测试项目 | 测试结果 |
|---|---|
| 内存复制 | 25,860 MB/s |
| 内存读取 | 28,410 MB/s |
| 内存写入 | 24,970 MB/s |
| sysbench 平均速度 | 26,420 MB/s |
对于图像处理、视频编解码和端侧 AI 推理来说,内存带宽会直接影响数据搬运效率。本次测试中,读取速度高于写入速度,符合嵌入式平台常见表现。
存储设备为 256GB NVMe 固态硬盘,使用 fio 测试顺序读写和 4K 随机读写。
fio --name=seq-read \
    --filename=/tmp/testfile \
    --size=2G \
    --bs=1M \
    --rw=read \
    --direct=1 \
    --iodepth=16 \
    --runtime=60 \
    --time_based
fio --name=seq-write \
    --filename=/tmp/testfile \
    --size=2G \
    --bs=1M \
    --rw=write \
    --direct=1 \
    --iodepth=16 \
    --runtime=60 \
    --time_based
fio --name=rand-read \
    --filename=/tmp/testfile \
    --size=2G \
    --bs=4k \
    --rw=randread \
    --direct=1 \
    --iodepth=32 \
    --runtime=60 \
    --time_based
测试结果如下:
| 存储测试项目 | 测试结果 |
|---|---|
| 顺序读取 | 873 MB/s |
| 顺序写入 | 742 MB/s |
| 4K 随机读取 | 61,800 IOPS |
| 4K 随机写入 | 48,600 IOPS |
| 平均读取延迟 | 0.52 ms |
| 平均写入延迟 | 0.68 ms |
从结果来看,NVMe 固态硬盘的顺序读取速度接近 900 MB/s,能够满足系统启动、模型加载、视频文件读写和本地数据缓存等需求。
测试结束后删除临时文件:
rm -f /tmp/testfile
开机后等待 10 分钟,关闭后台应用,记录空载温度和输入端功耗。
| 状态 | CPU 温度 | GPU 温度 | 整机功耗 |
|---|---|---|---|
| 开机后 5 分钟 | 36℃ | 35℃ | 4.1 W |
| 空载 10 分钟 | 38℃ | 37℃ | 4.3 W |
主动风扇运行时,空载温度较低,风扇噪声也比较明显。如果用于实际产品,建议根据环境温度和负载情况设计风扇调速策略。
同时运行 CPU 压力测试和 GPU 计算测试,持续时间为 10 分钟。
| 时间 | CPU 温度 | GPU 温度 | 整机功耗 | CPU 频率 |
|---|---|---|---|---|
| 1 分钟 | 57℃ | 55℃ | 13.6 W | 2.84 GHz |
| 5 分钟 | 67℃ | 65℃ | 14.8 W | 2.72 GHz |
| 10 分钟 | 71℃ | 69℃ | 15.2 W | 2.65 GHz |
本文功耗指开发板电源输入端测得的整机功耗,不等同于 QCS8550 芯片内部功耗。
为了判断是否出现降频,对连续负载前后的跑分进行了对比。
| 测试项目 | 第 1 轮 | 第 3 轮 | 性能变化 |
|---|---|---|---|
| Geekbench 单核 | 1,226 | 1,212 | -1.1% |
| Geekbench 多核 | 4,286 | 4,113 | -4.0% |
| GPU Compute | 6,430 | 6,165 | -4.1% |
| CPU 最高温度 | 57℃ | 71℃ | +14℃ |
| 满载功耗 | 13.6 W | 15.2 W | +1.6 W |
性能下降比例计算公式:
性能下降比例 = (第 1 轮成绩 - 第 3 轮成绩) / 第 1 轮成绩 × 100%
本次测试中,连续运行 10 分钟后 CPU 多核性能下降约 4%,GPU 性能下降约 4.1%,属于轻微降频。降频主要发生在温度达到 68℃之后,主动散热能够将性能下降控制在较小范围内。
| 测试类别 | 测试结果 |
|---|---|
| Geekbench 单核 | 1,221 |
| Geekbench 多核 | 4,271 |
| GPU Compute | 6,430 |
| 内存读取 | 28,410 MB/s |
| 内存写入 | 24,970 MB/s |
| 顺序读取 | 873 MB/s |
| 顺序写入 | 742 MB/s |
| 空载温度 | 38℃ |
| 满载温度 | 71℃ |
| 空载功耗 | 4.3 W |
| 满载功耗 | 15.2 W |
| 是否降频 | 有轻微降频 |
| 连续负载性能下降 | 约 4% |
综合本次测试结果,犀牛派 X1 的表现比较均衡。
CPU 单核成绩为 1,221 分,多核成绩为 4,271 分,在嵌入式平台中可以满足常规编译、数据处理、脚本运行和多任务应用需求。GPU Compute 成绩为 6,430 分,适合用于轻量级图像处理、视频分析和端侧 AI 推理。
内存读取速度达到 28.4 GB/s,能够满足多路图像数据搬运和视频流处理需求。搭配 NVMe 固态硬盘后,顺序读取速度达到 873 MB/s,系统启动、模型加载和本地数据读写速度都比较理想。
温度和功耗方面,主动散热下空载温度约为 38℃,满载 10 分钟后最高温度约为 71℃,整机输入功耗约为 15.2 W。连续运行时 CPU 和 GPU 有轻微降频,但性能下降控制在 4%左右,整体稳定性较好。
因此,犀牛派 X1 比较适合以下应用:
总体来看,犀牛派 X1 的优势在于接口丰富、平台性能均衡、端侧 AI 能力较强。对于需要摄像头、视频编解码、AI 推理和机器人控制的项目来说,主动散热条件下可以获得比较稳定的持续性能。

