


101
社区成员
 发帖
 与我相关
 我的任务

 分享
| 这个作业属于哪个课程 | 202601-福大-软件工程实践-W班 |
|---|---|
| 学号-姓名 | 102400332-杨伟烨 |
| 这个作业要求在哪里 | 软件工程实践第二次作业——与AI结对编程(顶会热词统计) |
| 这个作业的目标 | 与AI结对编程完成CV会议热词统计平台的需求理解与原型设计、编程实现与部署、记录结对过程并使用CodeArts代码托管 |
| 其他参考文献 | 《构建之法》第3、4、8章;DBLP 公开数据;ECharts 文档 |
codestyle.md(来源:Airbnb JavaScript Style Guide + Vue.js 官方风格指南)子任务拆解:需求理解(NABCD)→ 学习原型工具(墨刀)→ 与 AI 讨论 → 界面原型设计 → 后端编码 → 前端编码 → 关键词统计 → 部署华为云 → 博客撰写。
| PSP | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | ||
| · Estimate | · 估计这个任务需要多少时间 | 30 | 15 |
| Development | 开发 | ||
| · Analysis | · 需求分析(含学习新技术:Node.js / Vue3 / 墨刀 / DBLP API) | 60 | 43 |
| · Design Spec | · 生成设计文档(NABCD、原型复刻说明、博客骨架) | 60 | 112 |
| · Design Review | · 设计复审(人工评审 NABCD/原型,多轮迭代修改) | 30 | 22 |
| · Coding Standard | · 代码规范(编写 codestyle.md,标注来源) | 20 | 38 |
| · Design | · 具体设计(系统架构、数据库表、REST API 设计) | 120 | 97 |
| · Coding | · 具体编码(后端 5 功能 + 前端 5 页面 + 爬虫 + 关键词统计) | 600 | 408 |
| · Code Review | · 代码复审(自我复审 + AI 结对复审) | 120 | 70 |
| · Test | · 测试(功能测试、修复 bug、提交修改) | 120 | 53 |
| Reporting | 报告 | ||
| · Test Report | · 测试报告 | 40 | 28 |
| · Postmortem & Process Improvement Plan | · 事后总结,并提出过程改进计划 | 60 | 65 |
| 合计 | 1260 | 951 |
| 模块 | 要点 |
|---|---|
| N 需求 | 帮助小刚等 CV 入门者在三大顶会(CVPR/ICCV/ECCV)海量论文中,快速、直观了解近几年热门研究方向。 痛点量化:CVPR 2025 单届 13008 投稿 / 2878 录取,人工逐篇总结不可行。 核心痛点:① 信息过载 ② 方向迷茫 ③ 缺乏聚合 ④ 趋势难判断。 用户角色:小刚(兴趣小白)、研究生(找方向/开题)、导师(掌握动态)、助教(验证功能)。 |
| A 做法 | 构建「数据爬取 → 关键词抽取统计 → 可视化分析」一站式 Web 平台,聚焦三大顶会。 功能1 爬取/导入:单篇输入 + 批量导入,抓摘要/关键词/原文链接;数据源 DBLP 公开 API + 会议官网 + 数据集。 功能2 列表管理:增删改查 + 精确/模糊检索;本地无结果时联网爬取。 功能3 Top10:关键词抽取(英文分词 + 停用词过滤 + TF-IDF/TextRank)取 Top10,并做热门原因分析(体量/趋势/扩散/权威四维归因)+ 发展前景评级(🚀新兴 / 📈上升 / 📊成熟 / 📉降温)。 功能4 图谱:关键词共现力导向图,点击节点看相关论文。 功能5 动图:多年 × 多会议热度对比,6 种统计口径可切换(词频 / 文档占比 / TF-IDF / 热度 / 归一化 / 动量),ECharts 动态渲染导出 GIF。 横切能力:中英双语切换(论文保留原文、热词中英对照、界面文案双语)。 技术栈:Vue3 + Vite + ECharts(前端)· Node.js + Express(后端)· SQLite(数据库)· 英文分词 + 停用词过滤 + TF-IDF/TextRank(关键词)· axios + cheerio(爬虫)。 功能边界:仅覆盖 CVPR/ICCV/ECCV 三会 + 近若干年(2022 至今);抓取字段限于标题/摘要/关键词/原文链接,不解析全文 PDF;定位课程教学场景,不做账号体系/多租户/全文翻译。 性能考量:数万条论文 SQLite 建索引 + 分页查询;关键词统计离线预计算并缓存结果;爬虫限速 + 重试 + 失败降级;前端图表降采样与懒加载,保证单机部署流畅。 |
| B 好处 | ① 小刚零门槛几分钟看懂热点,省数十小时逐篇阅读;② 科研者快速找方向、找综述入口;③ 导师跨会跨年判断冷热趋势;④ 完整「爬取-分析-可视化」工程实践教学案例。 一句话卖点:不用读一篇论文,也能看懂 CV 顶会在研究什么。 |
| C 竞品 | 对标小刚痛点:通用检索(Google Scholar/知网)无热点榜单;DBLP 只有元数据无统计;AMiner 功能重、门槛高;Semantic Scholar/arXiv/Connected Papers 国内访问不稳、无热词趋势动图。 差异化:垂直聚焦三顶会 + 热词洞察 + 低门槛可视化 + 中英双语,抢占细分空白。 体验风险应对:图谱引导式交互防看不懂;分页 + 预计算防卡顿;多数据源容灾防爬取失败;明确统计口径防不信任。 行业趋势:知识图谱化、可视化动态化、数据开放化、垂直精细化——本项目以图谱 + 动图 + 开放数据 + 垂直定位顺势而为。 自身短板:① 数据质量受公开源限制(关键词字段缺失/不统一);② 仅覆盖三会、非全领域;③「热度」为自定义口径、非权威指标;④ 教学级规模,无账号/权限/高可用;⑤ 爬取可能不全、有时延。 短板应对:明确口径 + 注明数据来源 + 多源补全 + 迭代完善,用「垂直聚焦 + 可解释统计」弥补规模与权威性不足。 |
| D 交付 | 华为云 CodeArts/云服务器部署 + 原型网页链接 + 博客。 节奏:阶段一(NABCD+原型)→ 阶段二(编码+部署)→ 发布。 推广:现场演示 + 博客图文/GIF 展示 + 群内分享。 迭代:按反馈完善,预留「了解更多」「年度热词演变」加分项。 |
| 角色 | 用户故事 |
|---|---|
| 小刚(兴趣小白) | ① 首页一眼看 Top10 热门方向;② 每方向有「为什么热」原因 + 前景标签;③ 关键词图谱点击看论文;④ 热词中英对照;⑤ 热度走势动图看涨跌;⑥ 可切换多种统计口径;⑦ 中英文一键切换。 |
| 研究生(科研入门) | ⑧ 单篇输入题目爬取;⑨ 批量导入列表;⑩ 增删改查 + 模糊检索;⑪ 本地无结果自动联网爬取;⑫ 跨会议/跨词/跨年组合对比。 |
| 导师/科研人员 | ⑬ 对比 CVPR vs ICCV vs ECCV 的热度差异。 |
| 管理员/助教 | ⑭ 查看数据来源与统计口径,验证结果可复现。 |
| # | 页面 | 核心内容 | 对应功能 |
|---|---|---|---|
| P1 | 首页/热门方向总览 | Top10 卡片(热度 + 迷你趋势 + 热门原因 + 前景标签)+ 关键词图谱 + 热词云 + 会议分布 | 功能 3、4 |
| P2 | 热度走势对比页 | 会议多选 + 年份范围 + 口径切换 + 动态柱状图动图 + 多词折线 | 功能 5 |
| P3 | 论文列表管理 | 表格 + 增删改 + 精确/模糊检索 + 分页 + 无结果联网爬取 | 功能 2 |
| P4 | 论文爬取/导入 | 单篇输入 + 批量导入(txt/csv)+ 进度 + 结果反馈 | 功能 1 |
| P5 | 关键词图谱页 | 力导向关系图(节点大小 = 热度)+ 点击节点看论文 | 功能 4 |
| P6 | 详情/关于 | 论文详情(摘要保留原文)+ 三会背景 + 统计口径 + 数据来源 | 附加 |
全局组件:顶部导航栏(含中英文切换按钮)。
数据流转:P4 入库 → P3 管理 → P1 总览 → P5 图谱 → P6 详情;P1 → P2 走势动图。
| 层 | 选型 | 说明 |
|---|---|---|
| 前端 | Vue3 + Vite + ECharts | 单页应用,ECharts 做柱状/折线/力导向图/动态柱状图 |
| 后端 | Node.js + Express | REST API(论文 CRUD、爬取、统计、图谱数据) |
| 数据库 | SQLite(better-sqlite3) | 嵌入式免安装,部署零维护 |
| 爬虫 | axios + cheerio | 优先 DBLP 公开 API |
| 关键词 | 英文分词 + 停用词过滤 + TF-IDF / TextRank | CV 论文为英文 |
| 动图 | ECharts 动态渲染 + 录屏导出 GIF | 前端动画后录屏 |
原型/网页原型.html(HTML + ECharts,用于与 AI 对齐交互逻辑)https://modao.cc/proto/sqrKRAZtlupd1AC18zz2D/sharing?view_mode=read_only&screen=rbpVW6leXWSLpharm
原型设计/墨刀图片/
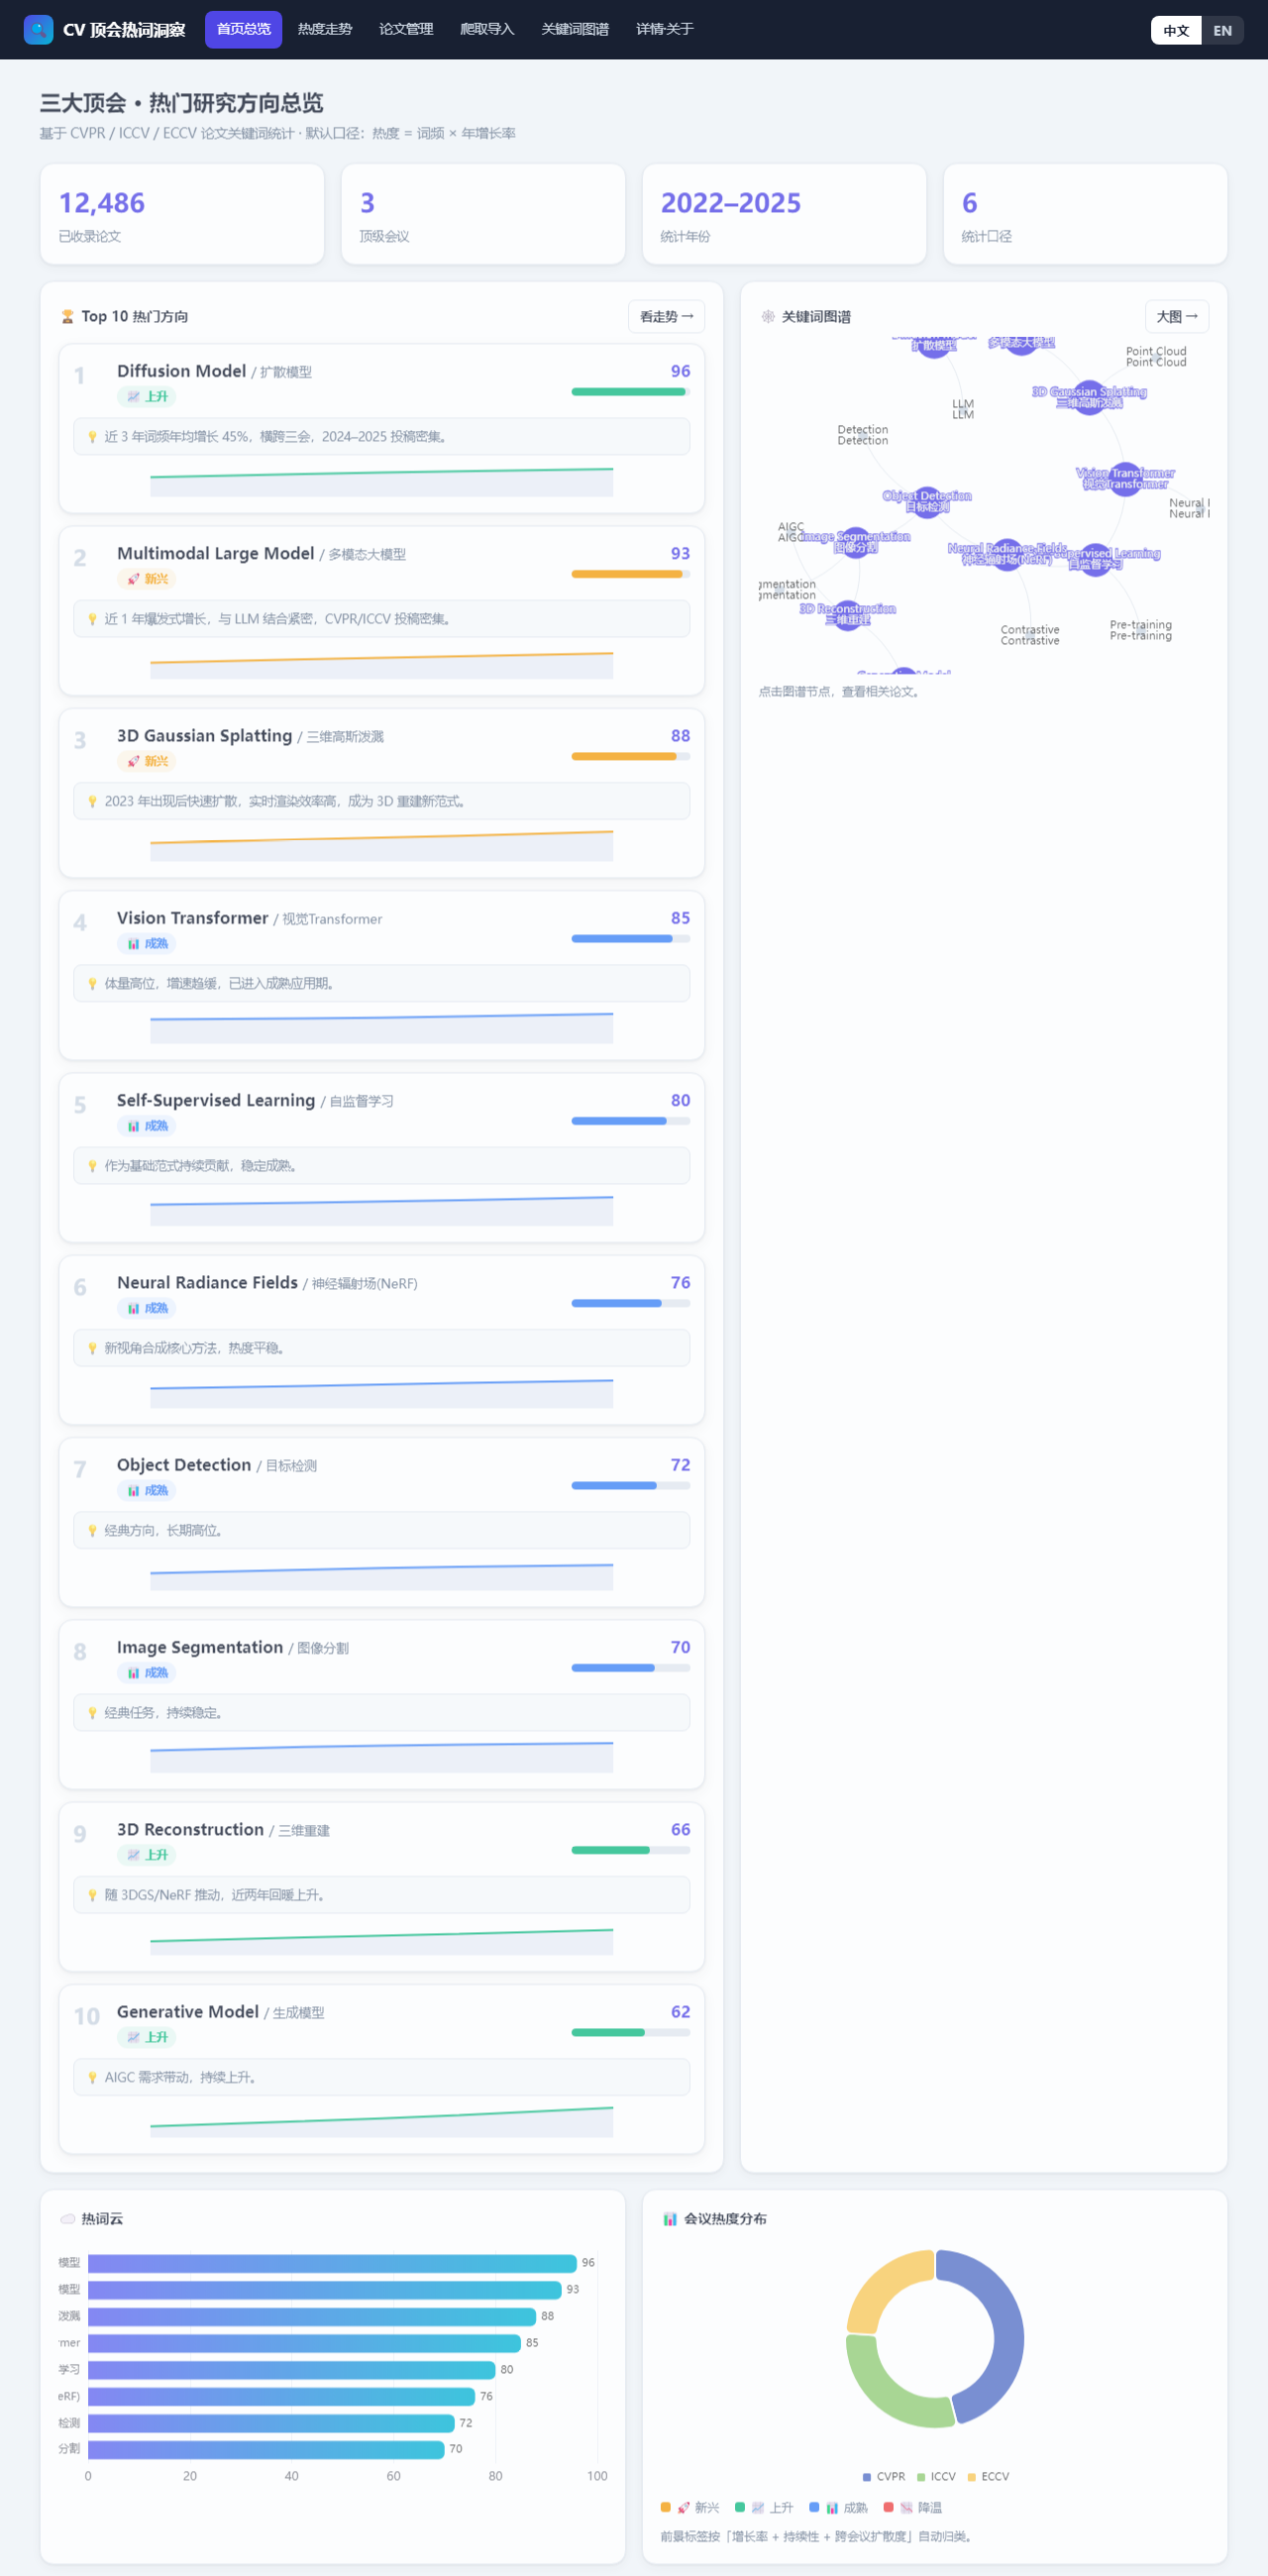
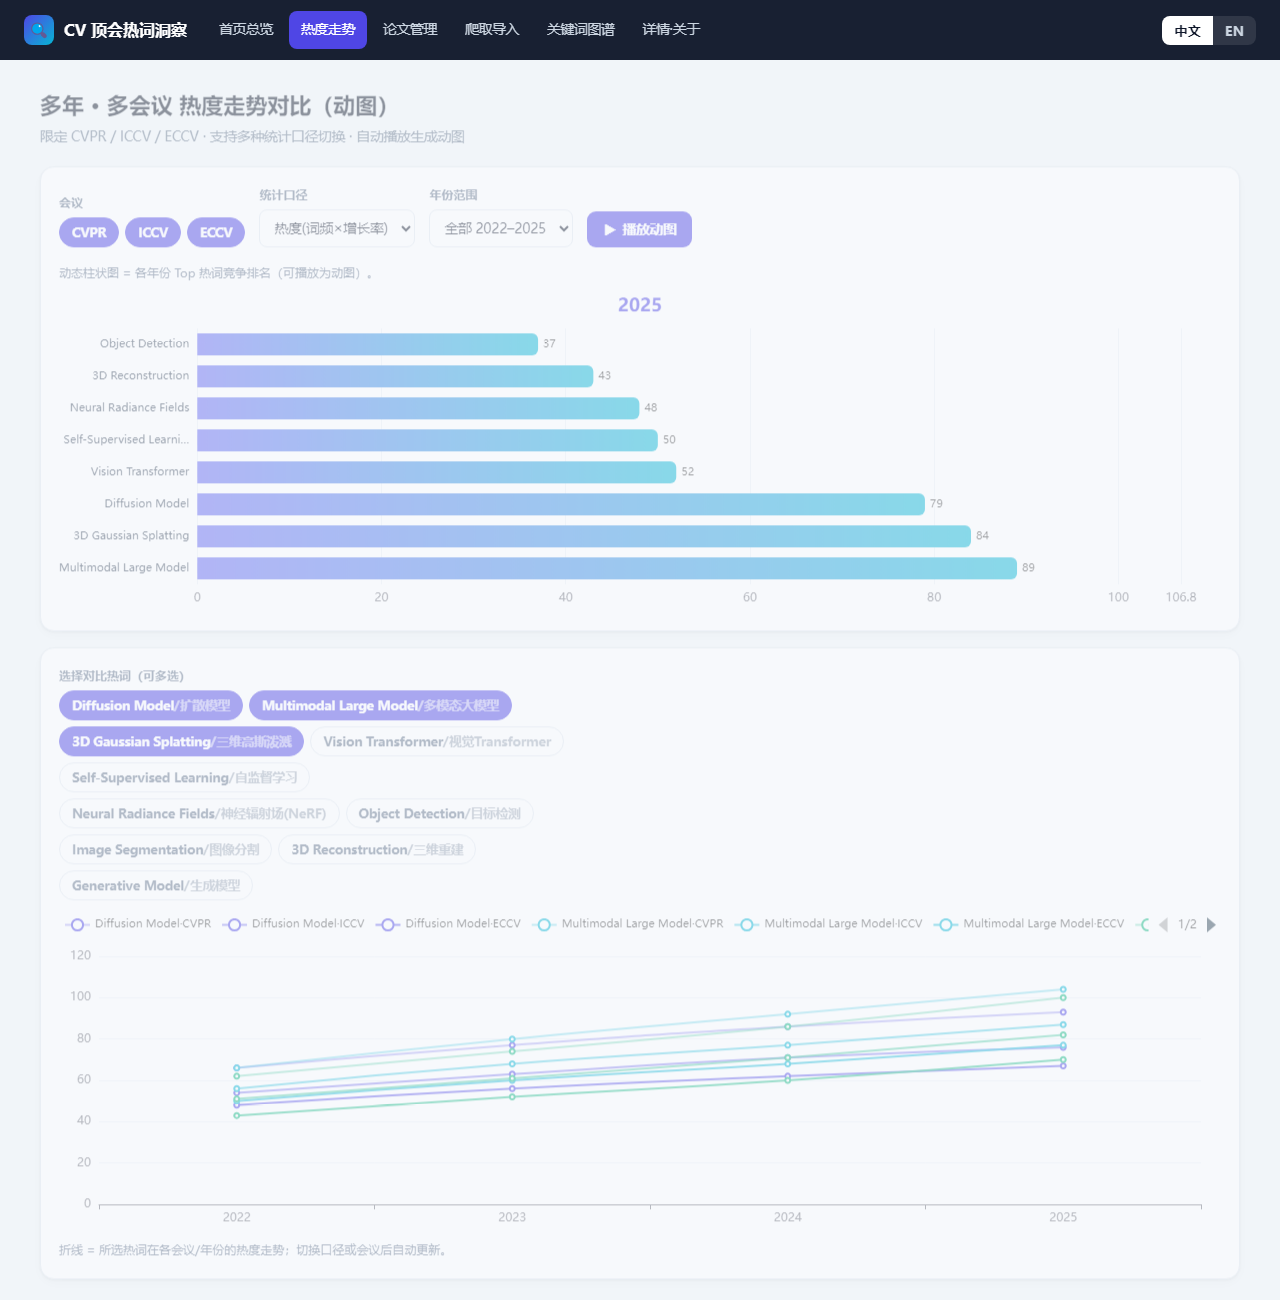
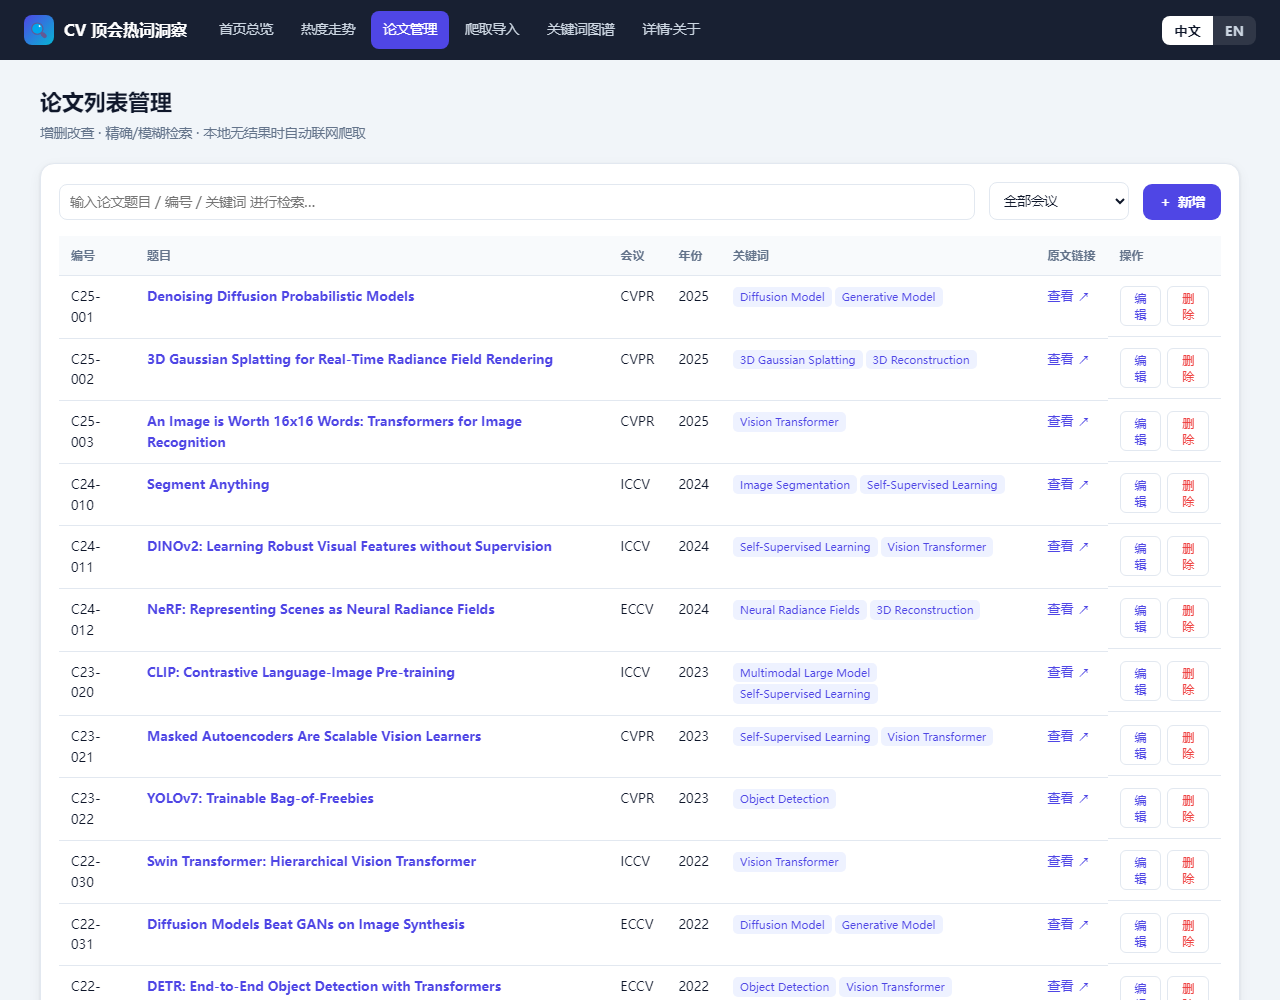
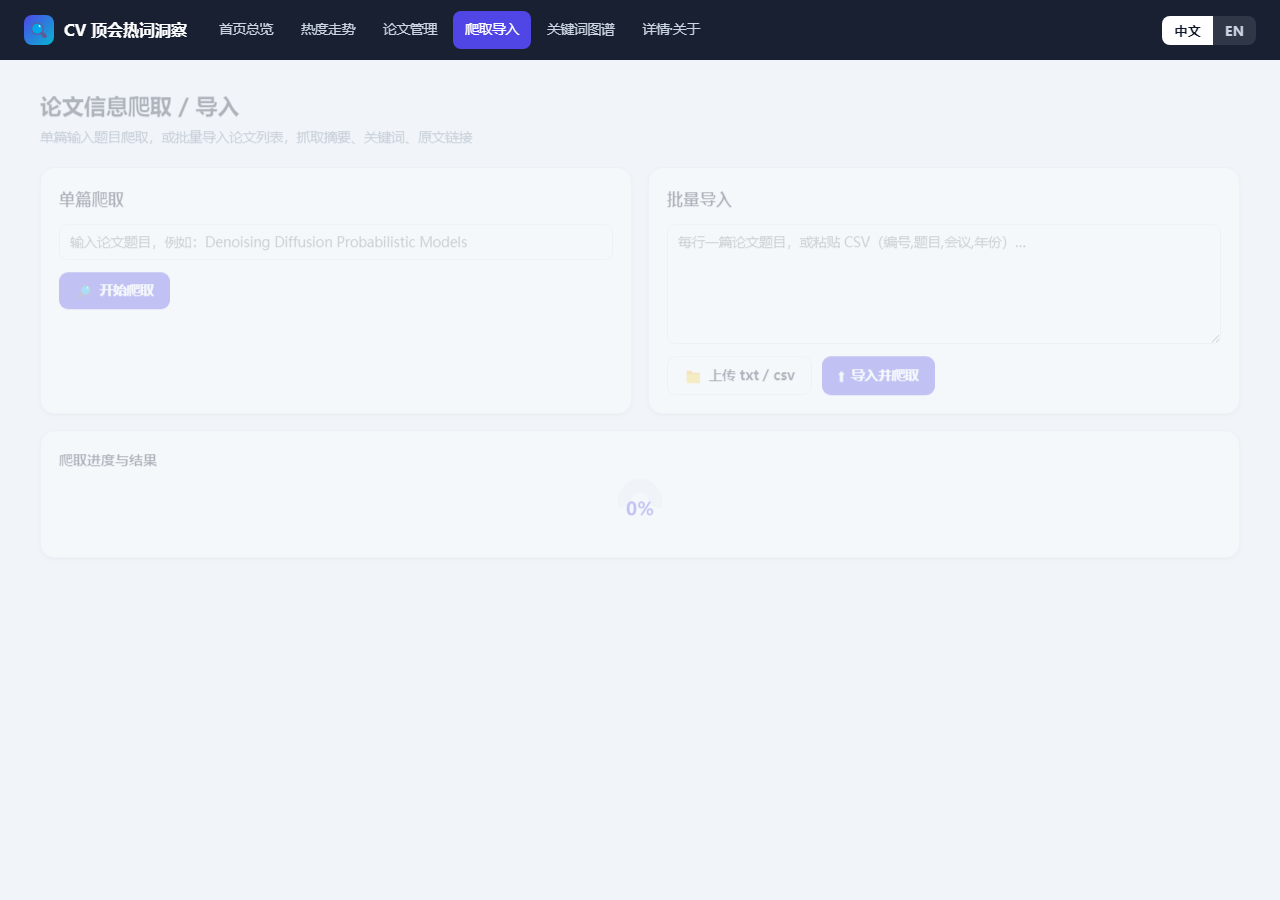
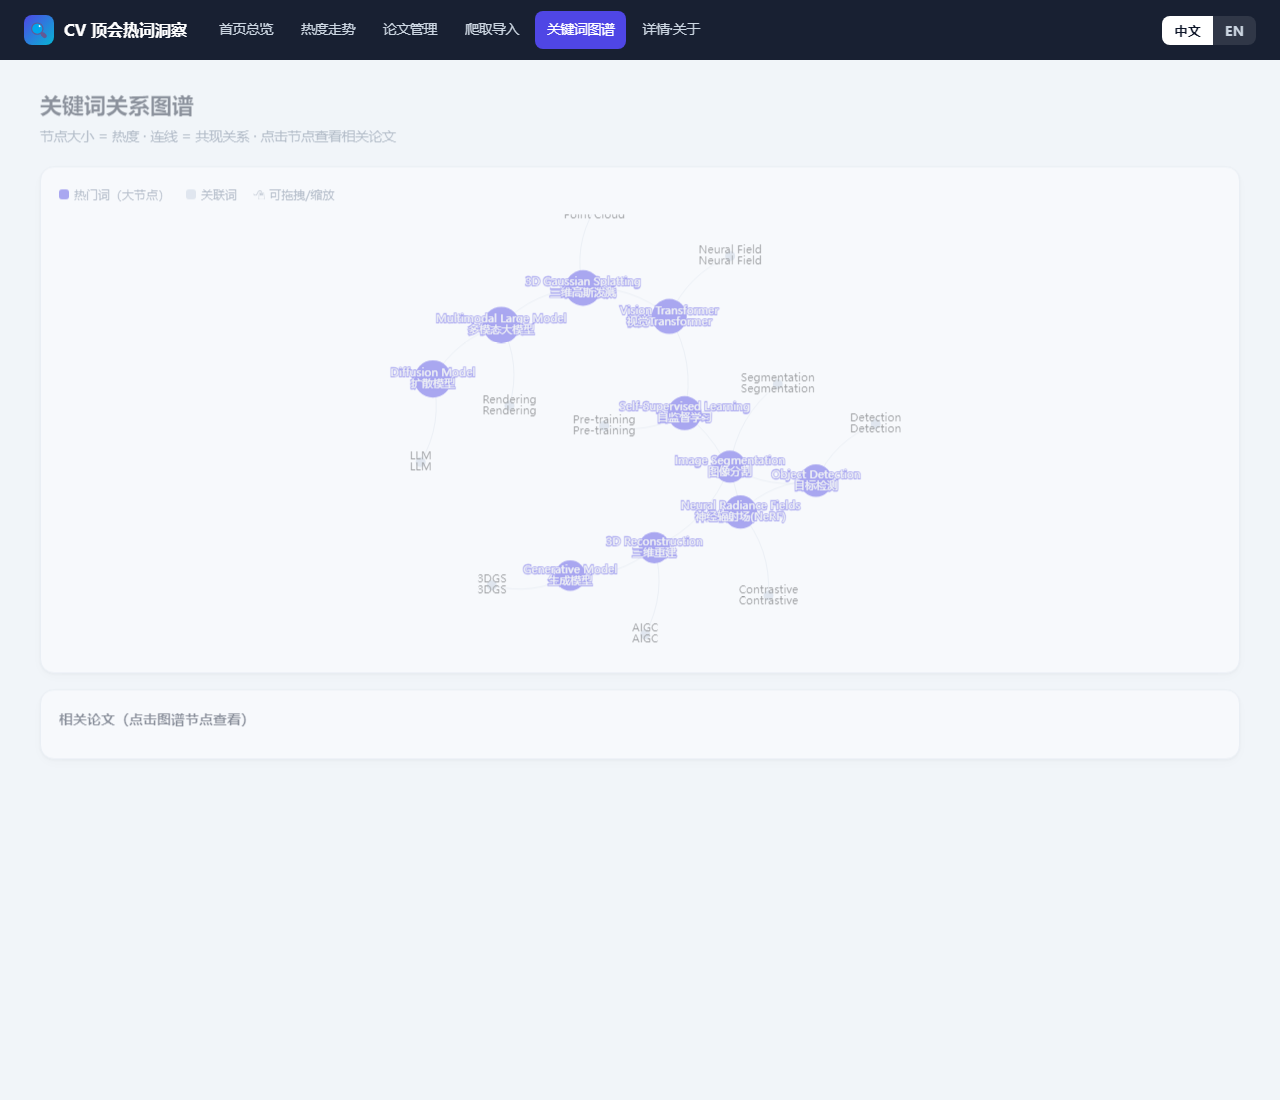
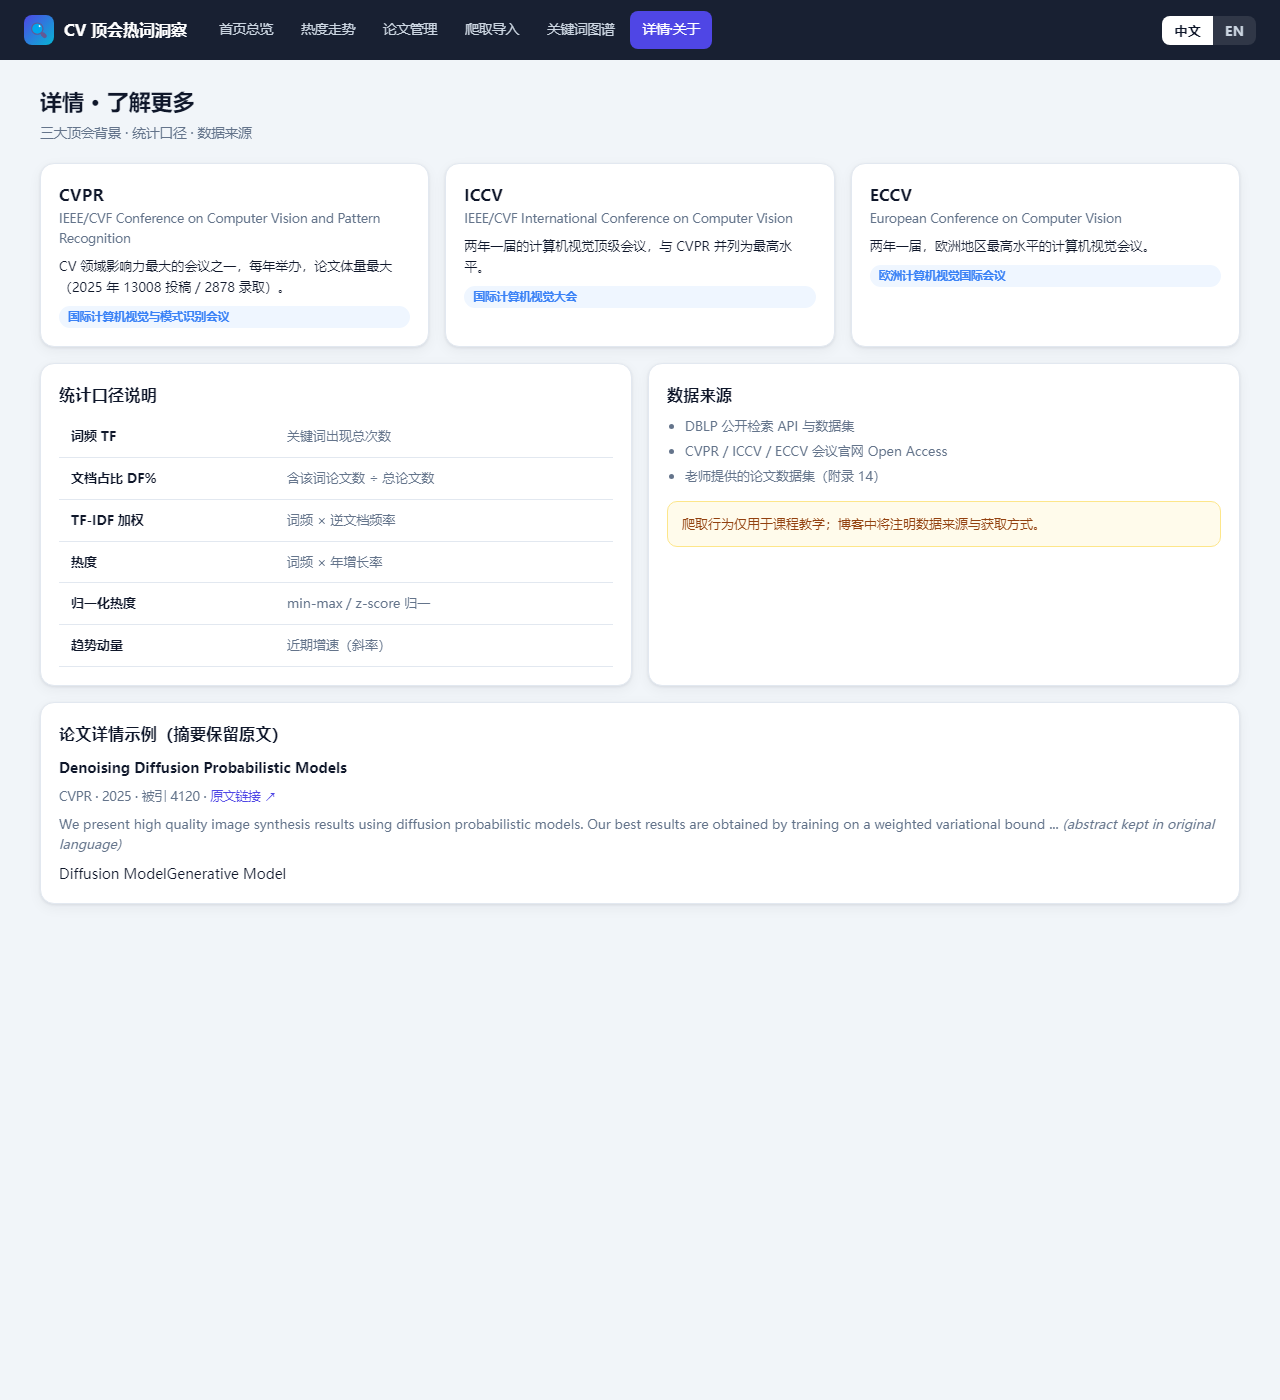
P1-首页总览 / P2-热度走势 / P3-论文列表 / P4-爬取导入 / P5-关键词图谱 / P6-详情关于。
原型设计/原型复刻说明.md。AI 先产出 HTML 交互参考稿;人工评审后确定 6 页面信息架构、配色(主色 #4F46E5、强调 #06B6D4)、组件与交互规则,再由人工在墨刀中复刻正式原型。
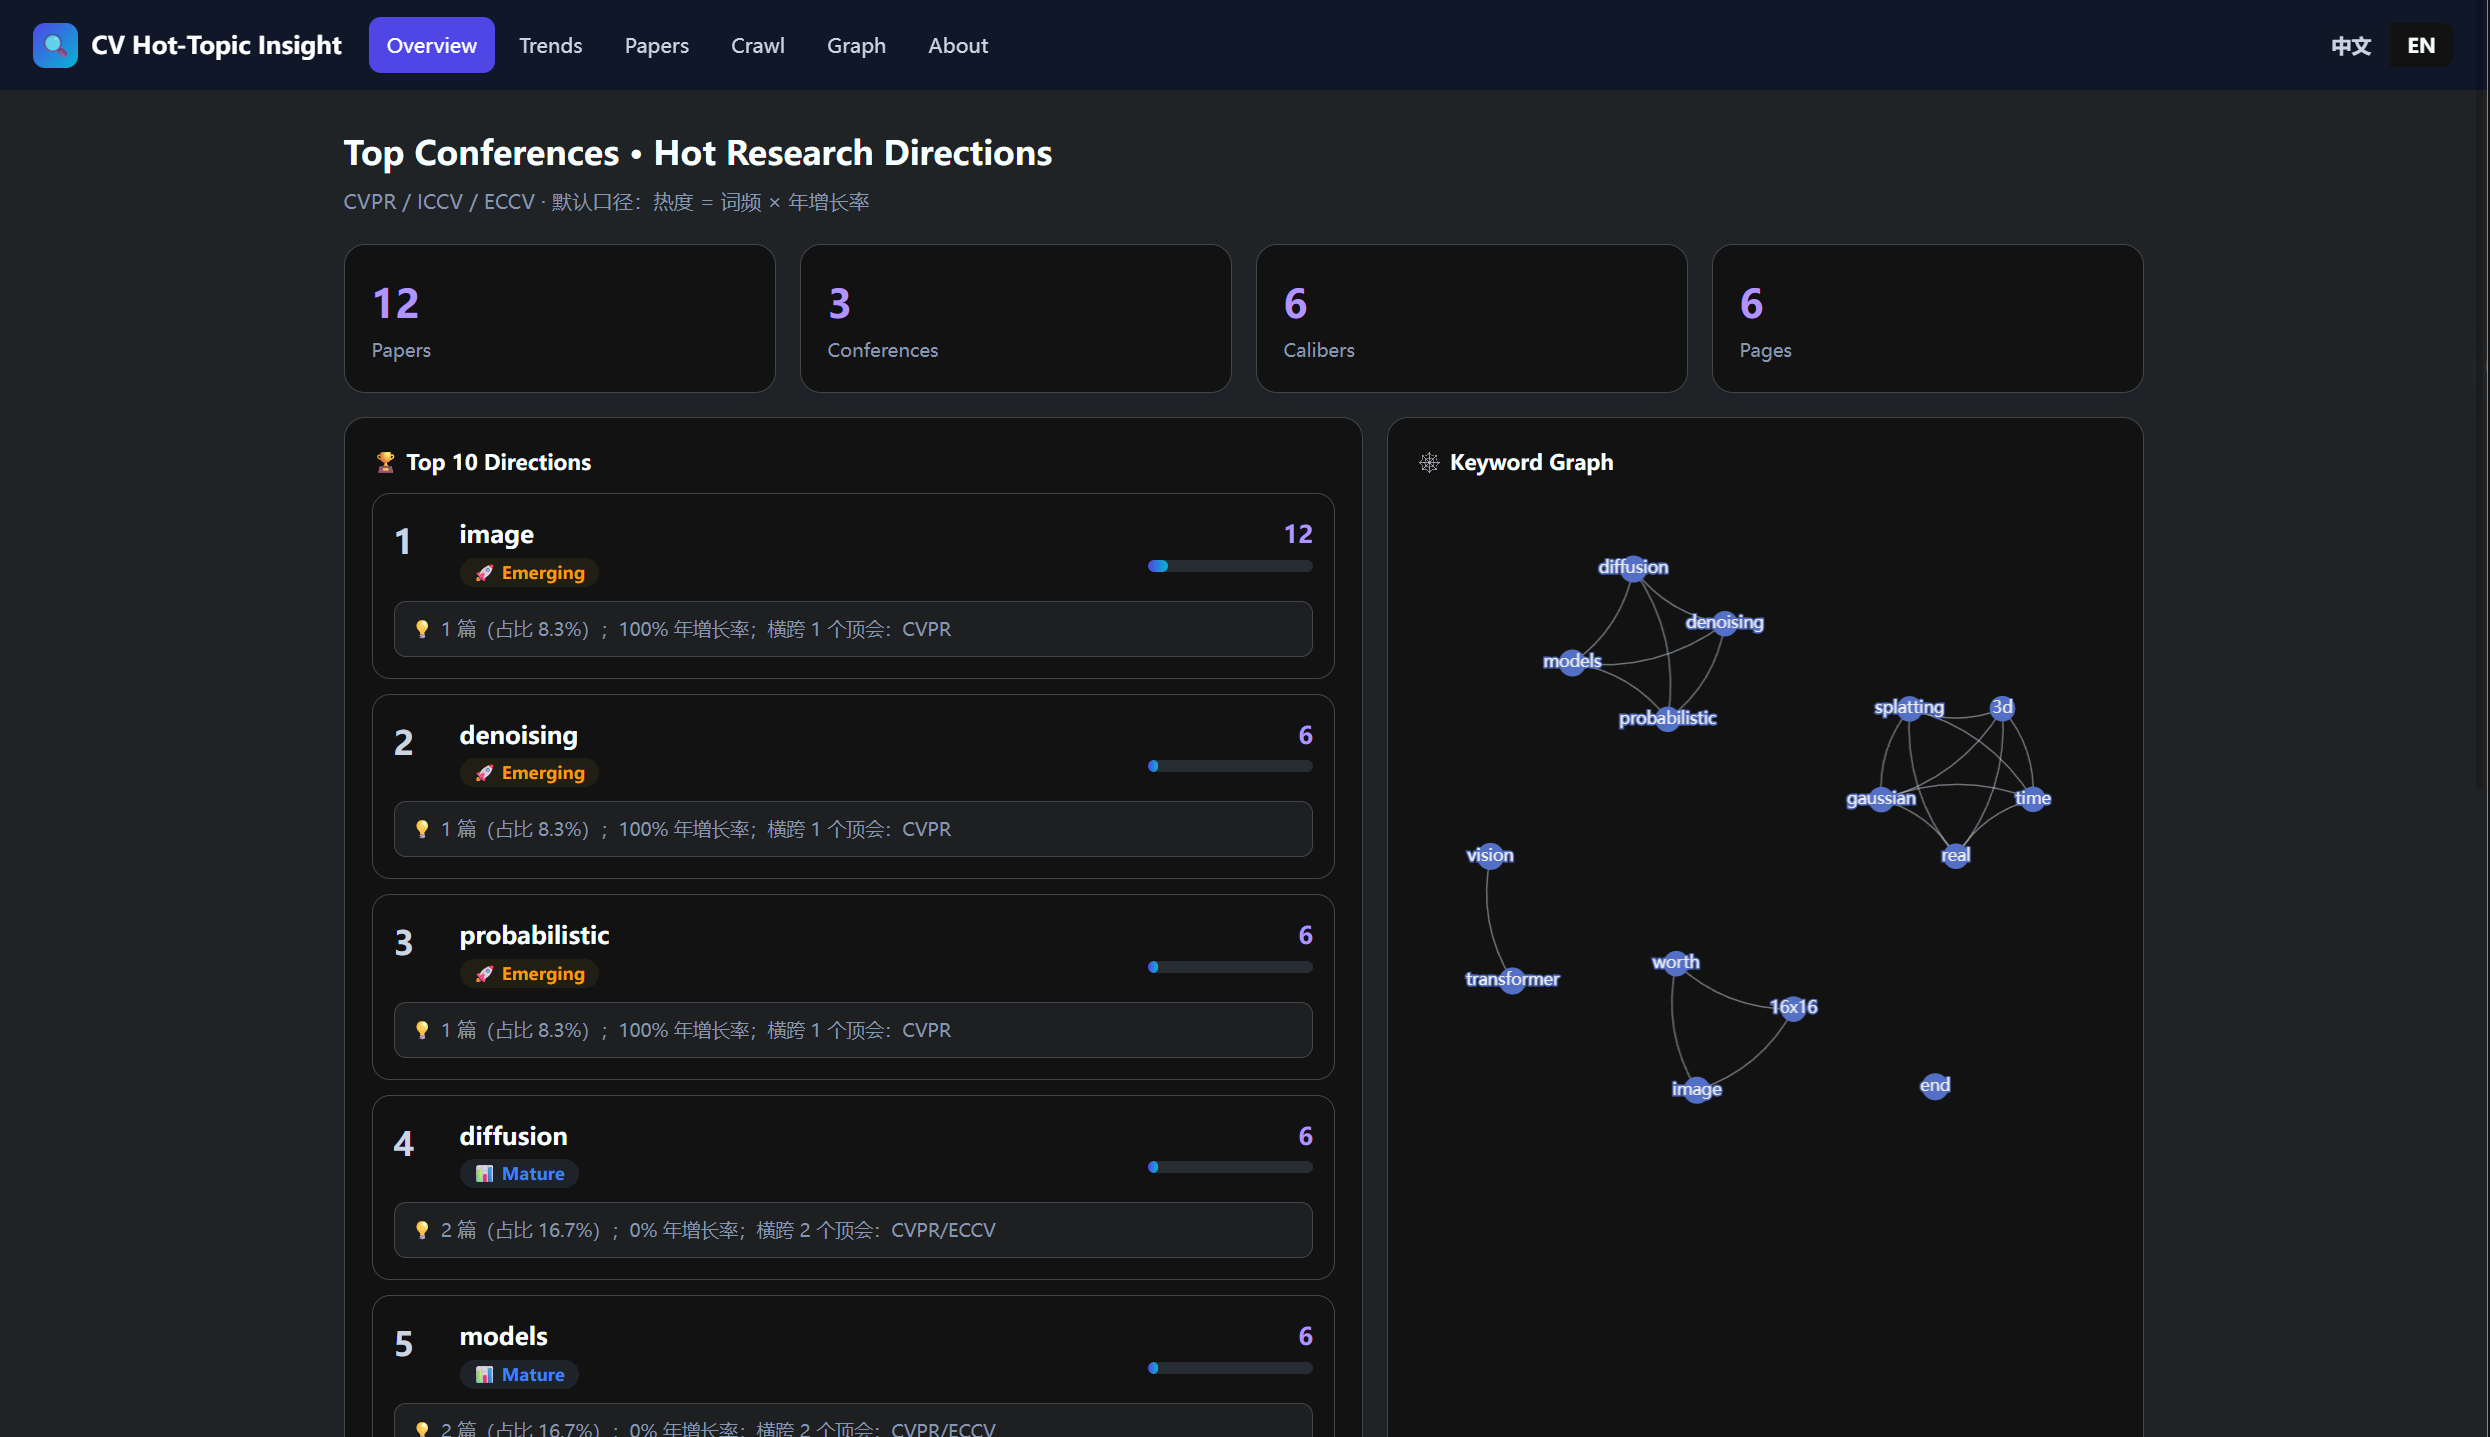
图 1:首页 / 热门方向总览(功能 3 + 4)
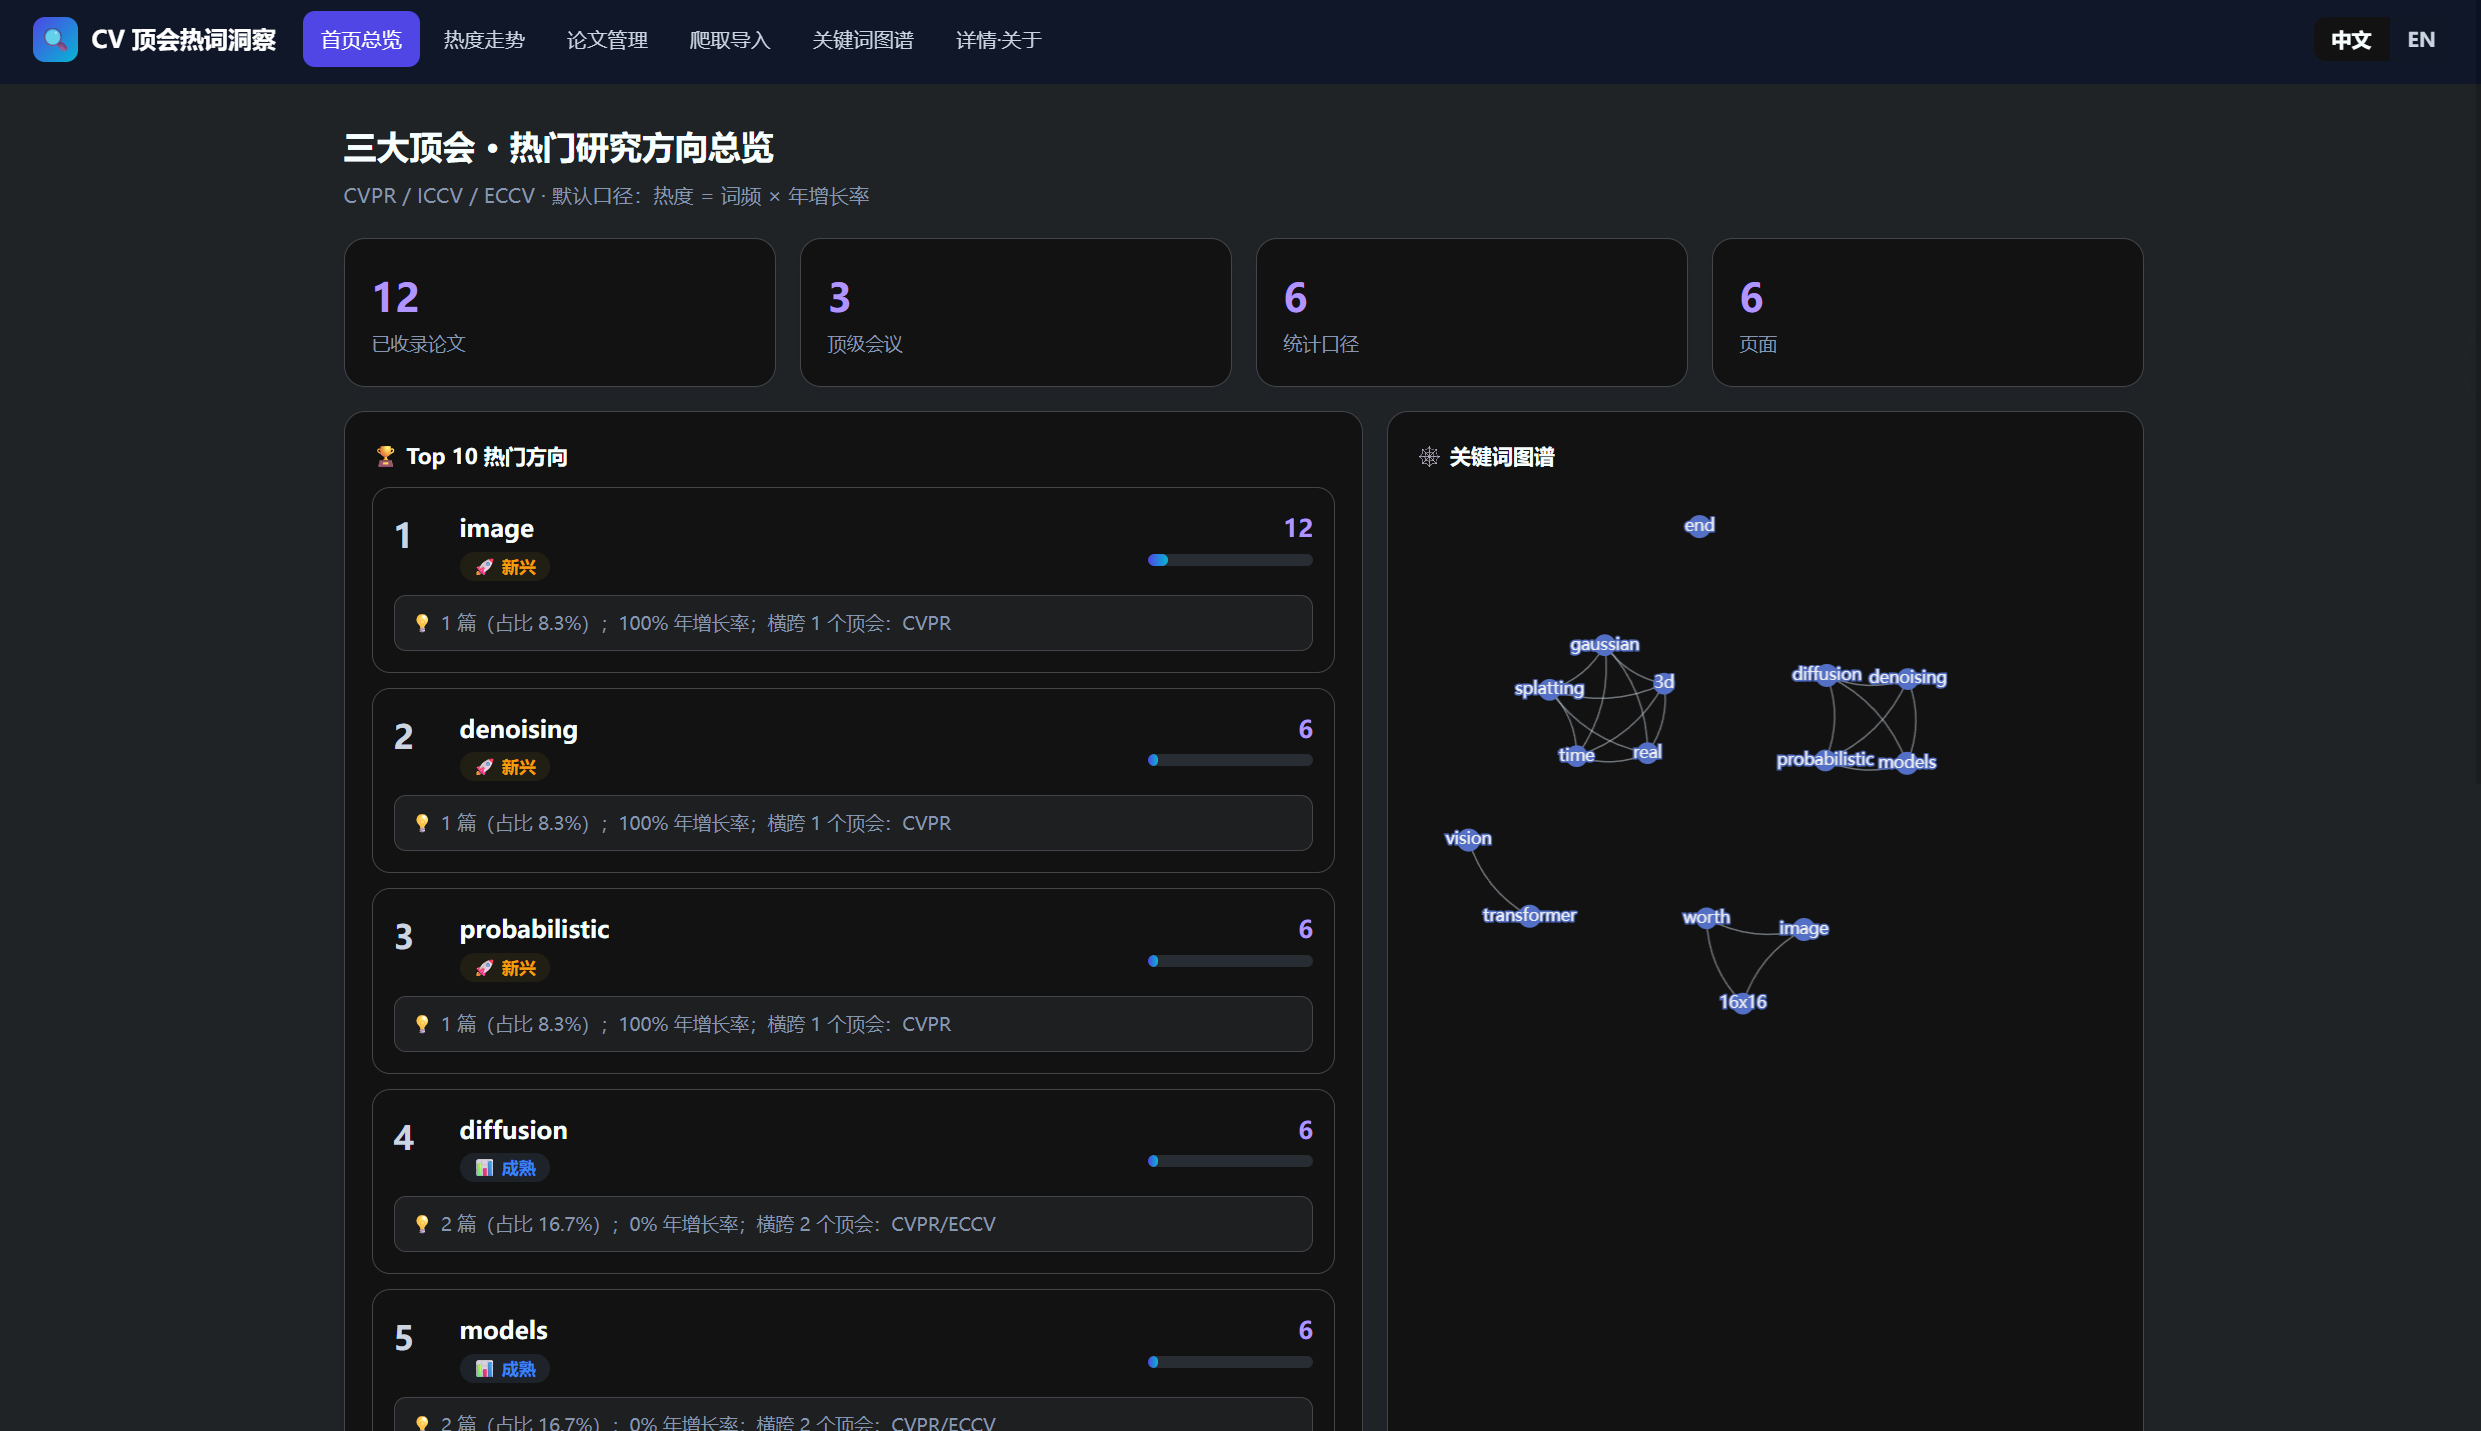
说明:首页展示统计概览、Top10 热门方向卡片(每张含热度值、热门原因、🚀新兴/📈上升/📊成熟/📉降温前景标签)与关键词图谱。
图 2:热度走势对比动图(功能 5)
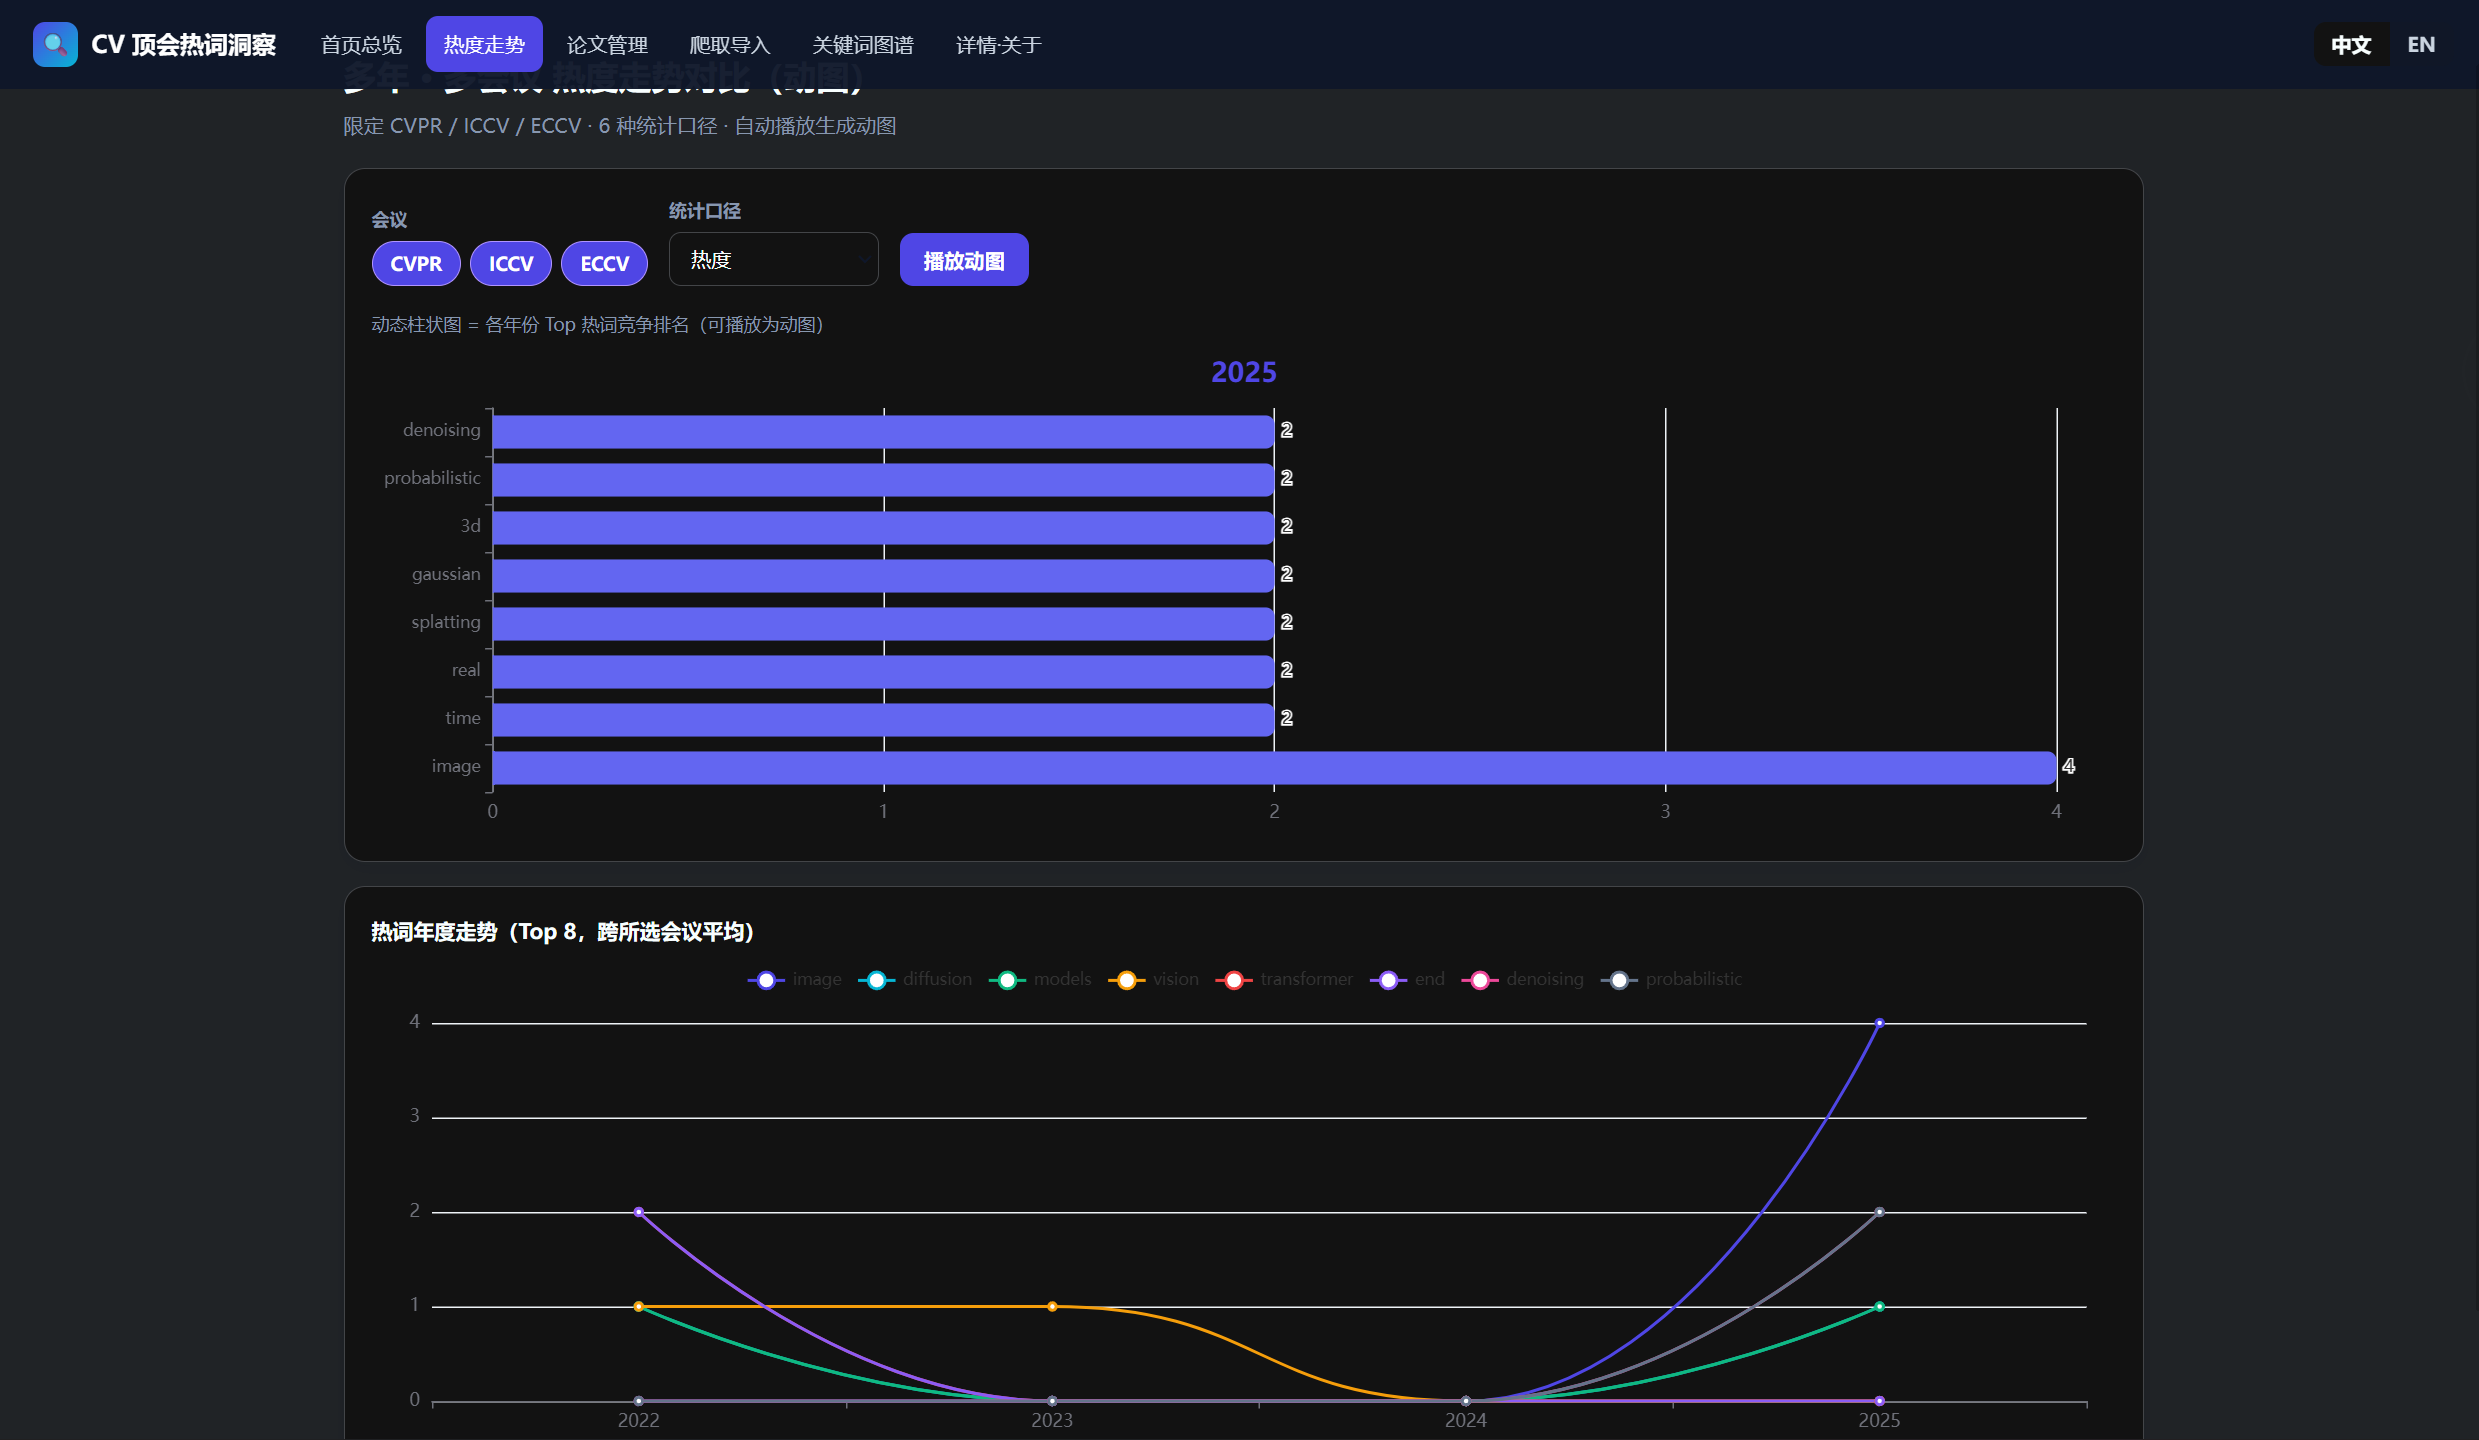
说明:多年 × 多会议热度对比,动态柱状图自动播放(可导出 GIF),支持会议多选、6 种统计口径切换、年份范围选择。
图 3:论文列表管理(功能 2)
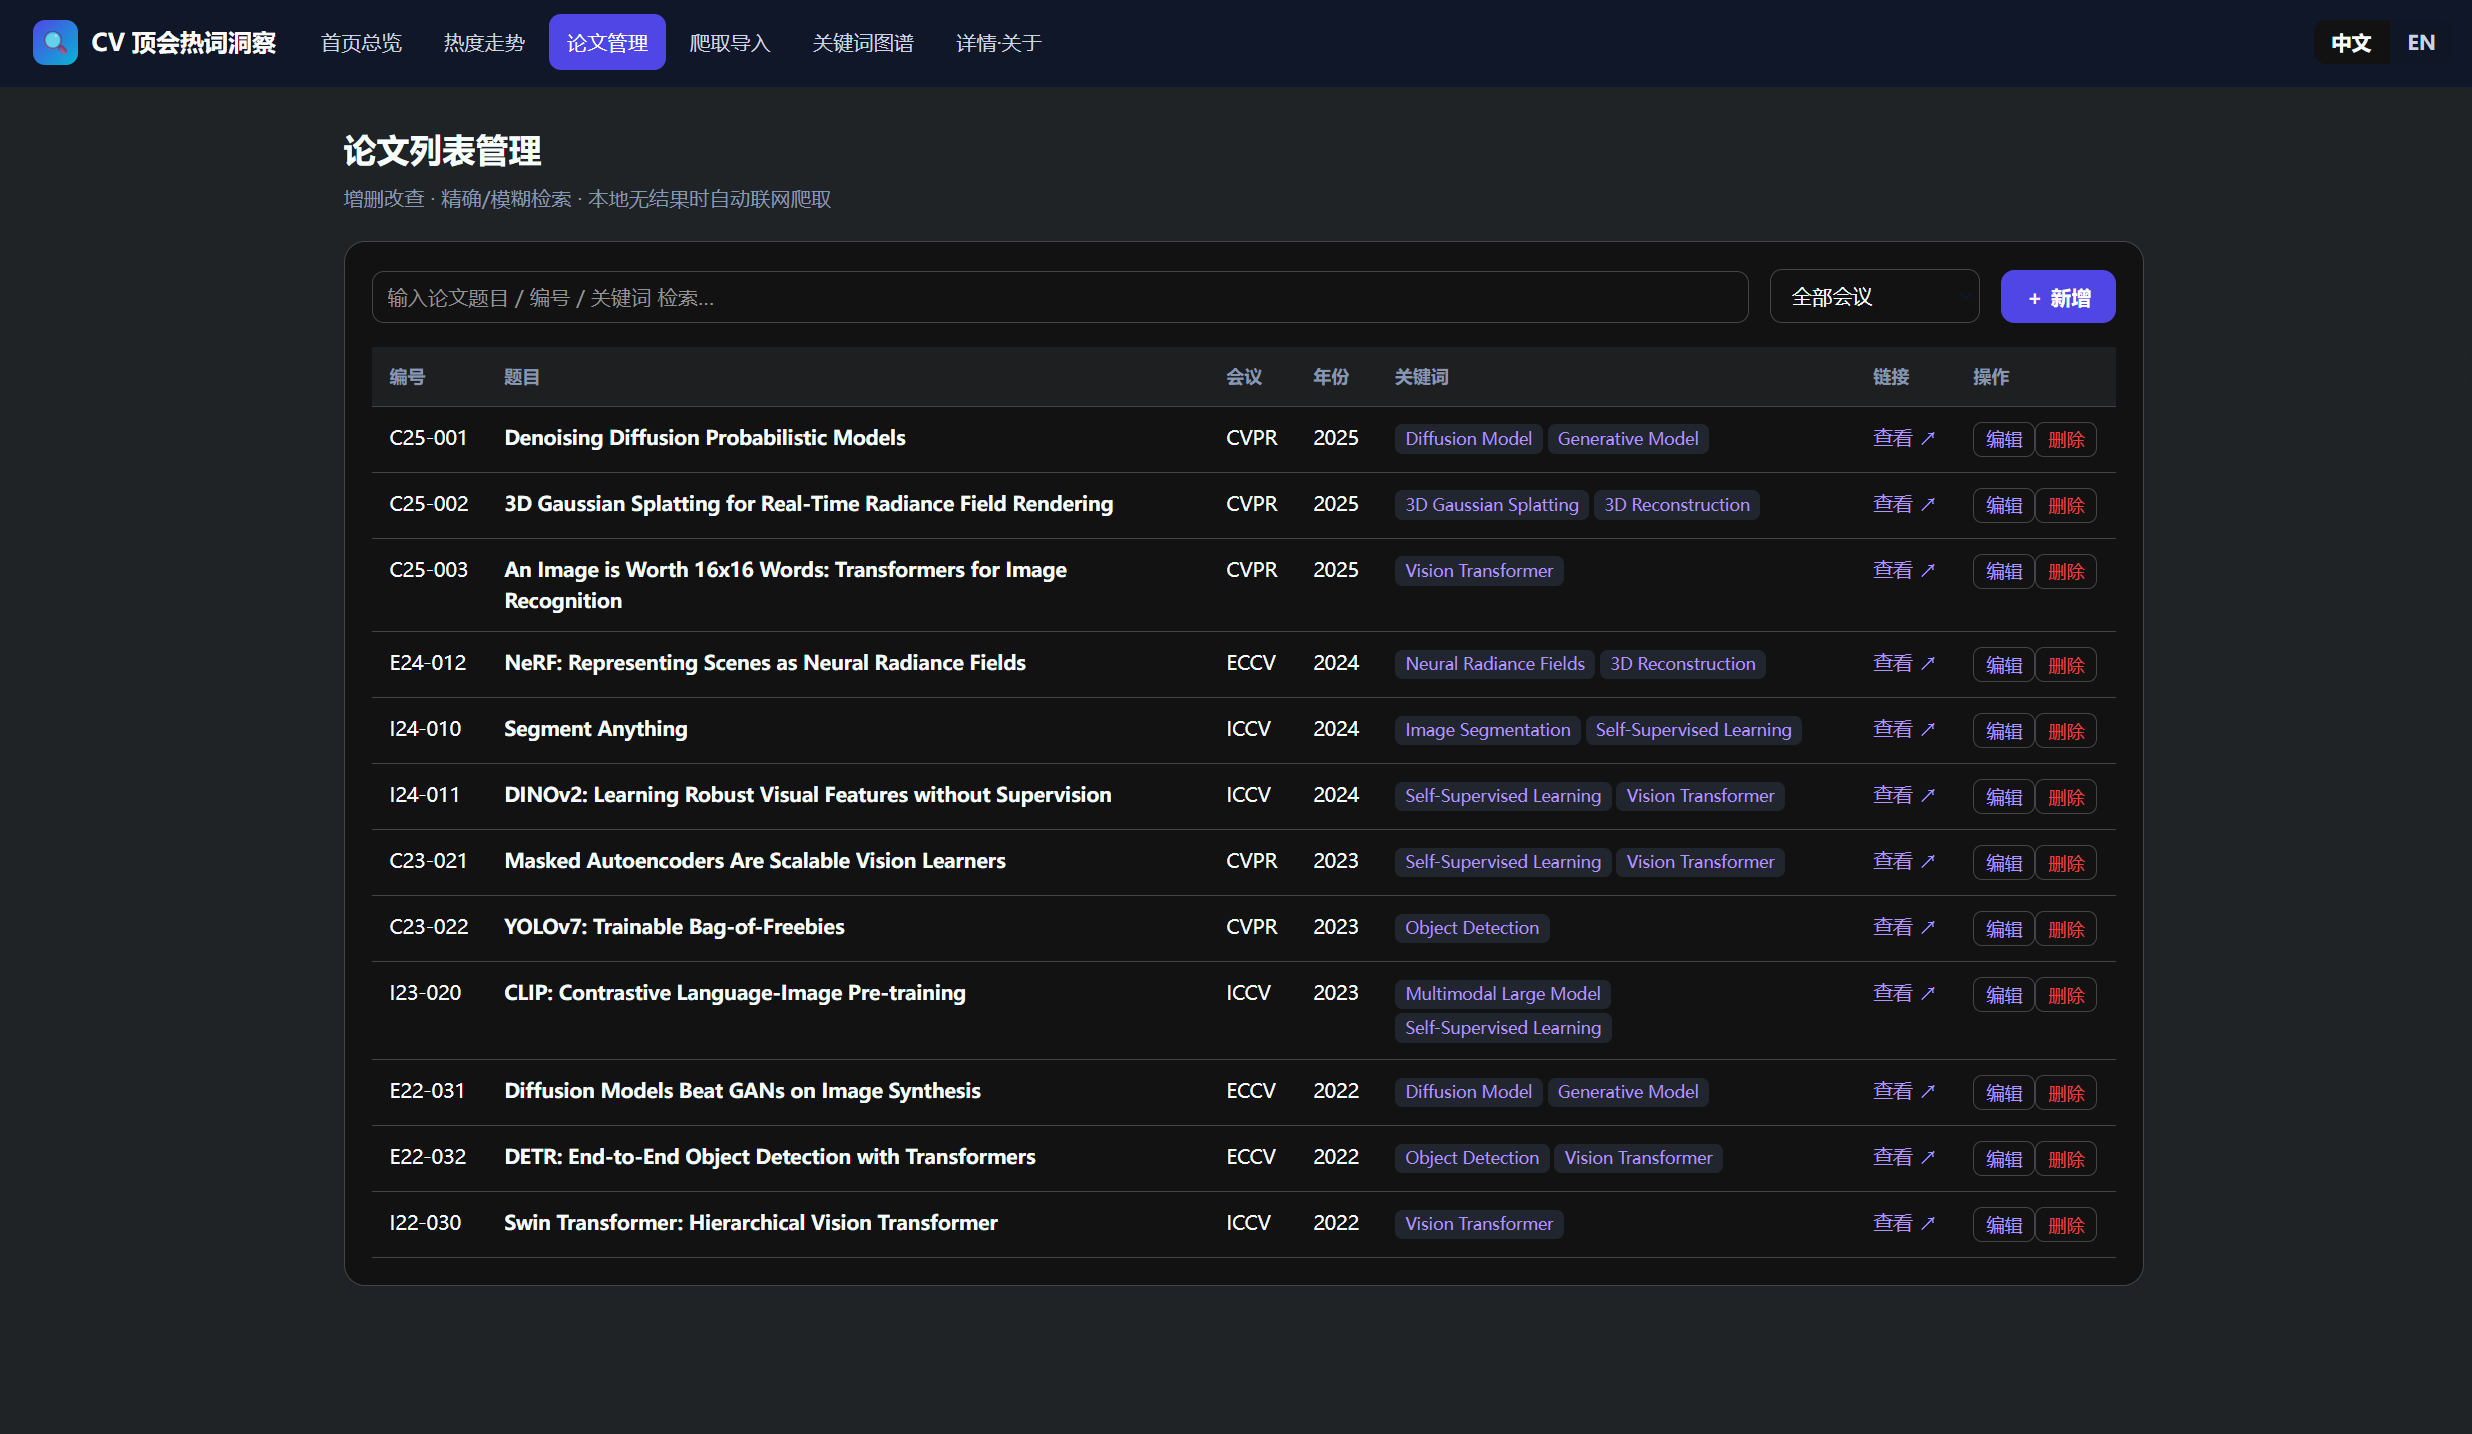
说明:论文列表以表格展示编号/题目/会议/年份/关键词/链接,支持分页。
图 4:论文新增 / 编辑,精确 / 模糊检索,本地无结果自动联网爬取(功能 2)
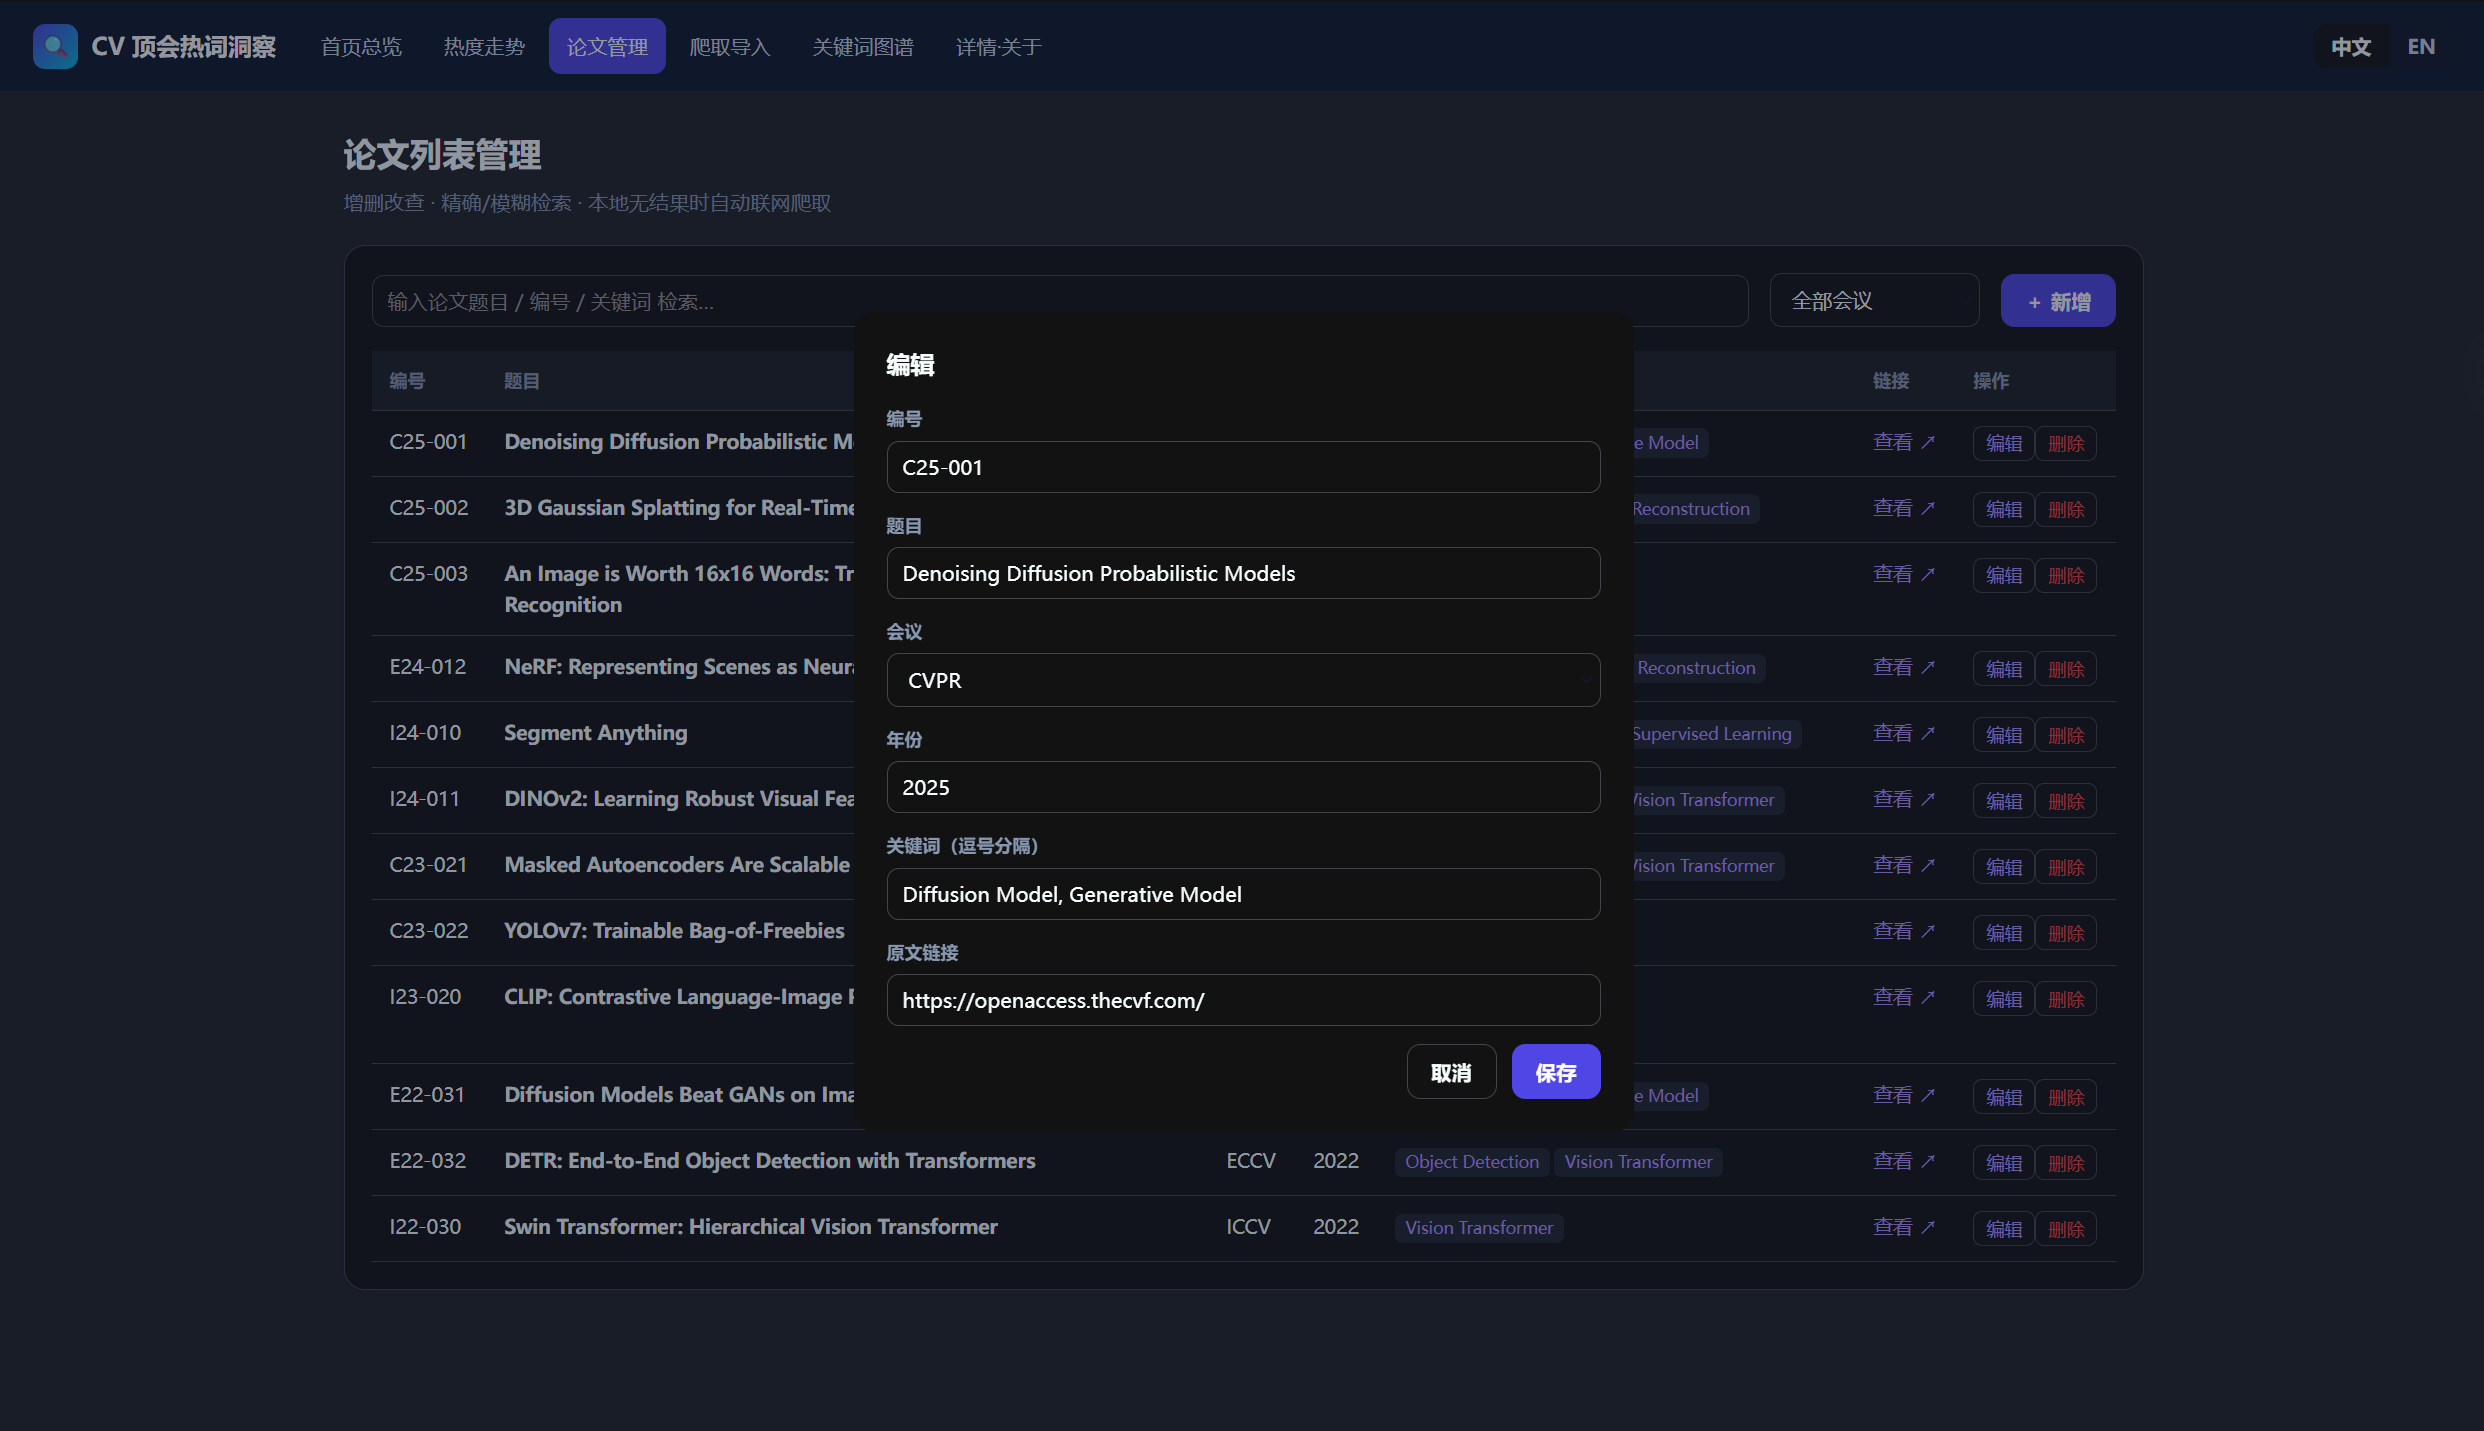
说明:点击"新增/编辑"弹出表单,可填写题目、会议、年份、关键词、原文链接,保存后列表即时刷新。输入论文编号、题目或关键词实时模糊检索,支持按会议筛选。检索的论文本地不存在时,自动联网爬取并入库返回,页面提示"本地无结果,已联网爬取并入库"。
图 5:关键词图谱(功能 4)
说明:点击
导航栏"中文/EN"切换界面语言,热词保留英文原文并显示中文对照。
DeepSeek(deepseek-v4-pro),用于需求分析、原型设计、后端编码,逐步迭代。
| 轮次 | 我的提示词(要点) | AI 输出 / 修改 | 采纳情况 |
|---|---|---|---|
| 1 | 完成 NABCD + 用户故事 + 页面清单 | 输出完整 NABCD | 采纳,但提出功能3要加"热门原因+前景"、功能5要"多口径" |
| 2 | 功能3加原因+前景、功能5加多口径 | 补热门原因归因(体量/趋势/扩散/权威)+ 前景评级 + 6 种口径 | 采纳 |
| 3 | C 对接小刚痛点 + 体验风险 + 行业趋势 | 以小刚痛点为主线重写 C,补体验风险表、行业趋势 | 采纳 |
| 4 | 加中英双语切换 | 增加 i18n 双语方案 | 采纳 |
| 5 | 加 AI 对话功能 | 设计 DeepSeek 对话助手 | 后觉太复杂,去掉 |
| 6 | A 补边界+性能、C 补自身短板 | 补功能边界/性能考量/自身短板/短板应对 | 采纳 |
| 7 | 技术栈定为 Node.js(Express)+Vue3+SQLite+ECharts | 更新技术选型 | 采纳 |
| 8 | 后端 Express+SQLite | 生成 db/crawler/routes/server/seed,语法校验通过 | 采纳 |
GraphView.vue 点击图谱节点看论文时报错——原代码 const chart = setOption({...}) 误把 setOption 的返回值当实例,而 setOption 实际不返回实例,导致 chart.value.on(...) 取不到实例。修正:从 useChart() 解构出 chart(shallowRef),mount 后用 chart.value.on('click', ...) 绑定点击事件。前端 Vue3 + Vite + ECharts;后端 Node.js + Express;数据库 SQLite(better-sqlite3);爬虫 axios + cheerio。
浏览器(Vue3 + ECharts) ──HTTP──▶ Express API ──▶ SQLite
                                     │
                                     └──▶ 爬虫(DBLP API / Semantic Scholar)
| 文件 | 职责 |
|---|---|
db.js | SQLite 建库建表(papers 表,keywords 存 JSON) |
crawler.js | DBLP API 抓元数据 + Semantic Scholar 补摘要 + 会议归一化 |
routes/papers.js | 论文 CRUD + 检索(未命中联网爬取)+ 单篇/批量爬取 |
server.js | Express 入口 + 健康检查 |
seed.js | 12 条示例数据 |
analyze.js | 关键词抽取(TF-IDF)+ 聚合统计(Top10/趋势/共现/前景评级) |
routes/stats.js | 统计 API:Top10 / 热度走势(多口径)/ 图谱 / 摘要 |
顶会热词统计平台
├── 功能1 论文爬取/导入(单篇 + 批量)
├── 功能2 论文列表管理(增删改查 + 精确/模糊检索 + 未命中联网爬取)
├── 功能3 Top10 热门方向分析(前后端已实现:TF-IDF)
├── 功能4 关键词图谱(前后端已实现:共现关系)
└── 功能5 热度走势动图(前后端已实现:多年多会多口径)
normalizeVenue 归一化到 CVPR/ICCV/ECCV;GraphView 点击节点报错 → setOption 不返回实例,改为解构 chart 实例绑定 click 事件(详见案例 C)。| 方法 | 路径 | 说明 |
|---|---|---|
| GET | /api/stats/top10 | Top10 热门方向(热度 + 热门原因 + 前景评级) |
| GET | /api/stats/trend?caliber= | 热度走势(6 种口径:tf / df / tfidf / heat / norm / mom) |
| GET | /api/stats/graph | 关键词图谱(节点 + 共现边) |
| GET | /api/stats/summary | 论文总数 + 口径/会议列表 |
| 文件 | 职责 |
|---|---|
src/main.js / App.vue | 应用入口与整体布局 |
src/router.js | 路由(6 页面,hash 模式) |
src/api.js | axios 封装后端 API |
src/i18n.js | 中英双语(响应式 lang) |
src/composables/useChart.js | ECharts 复用封装 |
src/components/NavBar.vue | 顶部导航 + 语言切换 |
src/views/HomeView.vue | 首页总览(Top10 + 图谱) |
src/views/TrendView.vue | 热度走势(动图 + 折线) |
src/views/PapersView.vue | 论文列表(增删改查 + 检索) |
src/views/CrawlView.vue | 爬取导入 |
src/views/GraphView.vue | 关键词图谱(点击看论文) |
src/views/AboutView.vue | 详情/关于 |
本地运行:frontend/ 下 npm install && npm run dev(开发环境自动代理 /api → localhost:3000)。
node server.js 正常启动,示例数据 12 篇;/api/health、/api/stats/summary、/api/stats/top10、/api/stats/trend、/api/stats/graph、/api/papers、/api/search?q=diffusion 全部返回正确;vite build 构建成功(646 模块,dist 生成),校验通过;better-sqlite3 预编译二进制可用;npm 11 默认拦截 install 脚本,需用 npm.cmd(Windows)绕过 PowerShell 执行策略。server.js 生产环境自动托管 frontend/dist(前端用 hash 路由,无需 history 回退),前后端合成单进程可部署;docs/部署说明.md(华为云 ECS + pm2/nohup + 安全组);git init(main 分支)+ 建 dev 分支,待提交;.gitignore 排除 node_modules / dist / *.db;项目分前后端两部分,后端提供 REST API + 统计分析,前端 Vue3 + ECharts 可视化。下面按模块解释关键代码的设计思路(完整代码见 CodeArts 仓库)。
crawler.js设计思路:优先用 DBLP 公开 API 抓元数据(标题/年份/会议/链接),摘要用 Semantic Scholar 尽力补,关键词留空交给统计模块统一生成。会议名归一化到 CVPR/ICCV/ECCV。
async function crawlPaper(title) {
  const hits = await searchDBLP(title);      // DBLP API 检索
  const best = pickBest(hits, title);        // 选最匹配结果
  if (!best) return null;
  const conf = normalizeVenue(best.venue);   // 归一化会议名
  const abstract = await fetchAbstract(best.title);  // Semantic Scholar 补摘要
  return { id: genId(conf, year), title: best.title, conference: conf,
           year, abstract, keywords: [], link: best.ee || dblpUrl };
}
analyze.js设计思路:英文分词 + 停用词过滤 → 标题加权 3x、摘要 1x 算词频 → 计算 DF/IDF → 每篇取 TF-IDF top5 作为关键词 → 聚合出 Top10、趋势矩阵、共现图。
// 标题词权重更高,避免摘要噪声主导
tokenize(p.title).forEach(w => tf.set(w, (tf.get(w)||0) + 3));
tokenize(p.abstract).forEach(w => tf.set(w, (tf.get(w)||0) + 1));
// TF-IDF 打分,取 top5
const scored = [...tf.entries()].map(([w, tf]) => [w, tf * idf.get(w)]);
stats.js设计思路:原始矩阵存词频,按请求的 caliber 参数做口径换算(tf/df/tfidf/heat/norm/mom),让同一份数据支持 6 种统计角度。
if (caliber === 'heat') val = Math.round(v * (1 + Math.max(0, growth)));
else if (caliber === 'norm') val = Math.round((v - min) / (max - min) * 100);
else if (caliber === 'mom') val = prev === null ? 0 : v - prev;
设计思路:useChart 封装 ECharts 的挂载/设值/清理;点击节点时用 chart.value.on('click') 绑定回调,按节点名查询相关论文。原代码误把 setOption 返回值当实例导致报错,修正为直接解构 chart 实例(详见案例 C)。
博客正文这里贴出约 300 行关键代码(crawler.js、analyze.js、stats.js、GraphView.vue 各截取核心片段),并配上面的思路解释。
本次项目我完整走了一遍「需求分析 → 原型设计 → 后端 → 前端 → 联调 → 部署」。印象最深的有几点:
NABCD 不是一次成型的:一开始的 A 只写了"功能清单",在 AI 结对中反复被追问——"功能3除了 Top10 还要给什么?功能5 的热度口径是不是太单一?C 有没有分析自身短板?"这让我意识到,需求分析要主动补上边界、性能、自身短板这些容易被忽略的维度,而不是只罗列功能。
原型先行省了大量返工:先用 HTML 交互参考稿 + 可导入墨刀的页面图对齐交互,再动手编码,页面结构和数据流转都提前定好了,编码时很少纠结"这里该长什么样"。
**"看似写完"不等于"能跑"**:前端 6 个页面的代码都在,但联调时发现 GraphView 点击图谱节点会报错——setOption 不返回实例,却被当成实例用了 .value。这个 bug 是我让 AI 逐行审查时抓出来的,修正后还顺手成了博客的"案例 C"。
环境坑比想象多:Windows 下 npm 被 PowerShell 执行策略拦截(要改用 npm.cmd)、npm 11 默认拦截 install 脚本……这些都不是算法问题,却会实打实卡住部署。
| 维度 | 人人结对 | 人机结对(AI) |
|---|---|---|
| 响应速度 | 受对方时间限制 | 随时可用、秒回 |
| 情绪/疲劳 | 会累、有情绪 | 无情绪、始终稳定 |
| 领域直觉 | 有经验、会主动质疑 | 靠训练数据,会"幻觉"、有知识截止 |
| 责任 | 双方共同担责 | AI 不担责,最终要人来把关 |
| 审查 | 互相 review | 人必须主动审查 AI 输出 |
核心体会:AI 结对是"强执行、弱判断"的伙伴——它写代码、生成文档又快又全,但判断对错、验收质量、承担责任的是人。所以我的工作重心从"自己写"变成了"给清晰提示词 + 审查验证 AI 输出 + 修改迭代"。
GraphView 的 bug;GraphView 的 bug 就是隐患,不逐行审查根本发现不了;作为结对伙伴,DeepSeek 在"速度、广度、文档产出"上远超人类伙伴,但在"判断力、责任感、主动质疑"上是短板。它是放大器,不是替身——用得好能大幅提效,前提是人始终掌握主导权和验收标准。

