


88
社区成员
 发帖
 与我相关
 我的任务

 分享
| 项目 | 内容 |
|---|---|
| 这个作业属于哪个课程 | 2601_CS_SE_FZU |
| 这个作业要求在哪里 | 软件工程实践第二次作业——与AI结对编程(顶会热词统计) |
| 这个作业的目标 | 与 AI 结对完成需求分析、原型设计、编码实现、测试与云部署,并如实记录人机协作过程 |
| 其他参考文献 | 《构建之法》(NABCD 模型、两人合作);CVF Open Access;ECVA;OpenAlex API;DBLP API;Vue 3;ECharts 5;FastAPI;SQLite |
姓名:陈材臻 学号:022401402
博客撰写时间:2026-09-24
git ls-remote 仍成功返回全部引用)main;开发分支:dev1.0.0、2.0.0、2.0.1、2.1.0848f788 fix: hydrate all cached papers in paged batchesdev 与 main 当前指向同一个提交 848f788(即 dev 的全部工作已合并回 main)推送到 CodeArts 后,我做了独立 mirror clone 与匿名读取双重核对,不是只看本地:
| 引用 | 本地 SHA | 远端 SHA | 结论 |
|---|---|---|---|
main | 848f78893eb9 | 848f78893eb9 | MATCH |
dev | 848f78893eb9 | 848f78893eb9 | MATCH |
tag 1.0.0 | 8f041133f17f | 8f041133f17f | MATCH |
tag 2.0.0 | eaac788bbc3e | eaac788bbc3e | MATCH |
tag 2.0.1 | ee6577b6a67d | ee6577b6a67d | MATCH |
tag 2.1.0 | 47acf497473d | 47acf497473d | MATCH |
README.md blob | d1b5adca68fd | d1b5adca68fd | MATCH(字节级一致,不会乱码) |
远端 commit 统计与本地一致:rev-list --count main = 17,--no-merges = 14;远端 3 个 merge commit 为 078aa2f merge: release phase two data pipeline、95675ce merge: polish deployment assets、3452331 merge: stabilize test command。
没有 squash、没有 rebase、没有改写历史、没有伪造时间戳——所有远端 SHA 都能与本地逐一对应。
代码规范见 codestyle.md,来源已在文件顶部标注(主流官方/大厂推荐规范)。规范覆盖命名、提交信息格式、目录组织、错误处理与注释要求。该网页直链能否匿名打开取决于 CodeArts 仓库权限。
| 项目 | 内容 |
|---|---|
| 使用的 AI 工具 | Codex(OpenAI)/ ChatGPT |
| 主要用途 | 需求拆解与信息架构、多源数据适配方案设计、代码审查、Bug 定位、测试用例设计、交付文档整理 |
| 不做的事 | 不直接提交未读懂的 AI 代码;不伪造任何对话或提交历史 |
可解释性声明:AI 参与了方案初稿、样板代码与调试建议的生成;所有接口调用、数据结构、统计口径、边界处理、部署脚本与本文档的事实性内容,均由本人逐项审查、运行验证并确认。凡是 AI 给出而被我拒绝的方案,均在 第 8 节记录拒绝理由。
| PSP 阶段 | 任务 | 预估/min | 实际/min |
|---|---|---|---|
| Planning | 阅读作业要求、拆分为可验收清单 | 30 | 45 |
| Development / Analysis | NABCD 需求分析、技术选型、数据口径确定 | 60 | 75 |
| Development / Design Spec | 页面结构与交互设计(信息架构、原型) | 45 | 55 |
| Development / Coding | Vue 前端、论文管理、查询、图表、导入导出 | 180 | 210 |
| Development / Coding(阶段二) | 多源采集适配、SQLite 数据链、分析与部署资产 | 150 | 185 |
| Development / Code Review | 代码审查、边界与失败分支修正 | 45 | 50 |
| Development / Test | 后端测试、构建检查、浏览器功能验证 | 60 | 70 |
| Deployment | CodeArts 推送与核对、云服务器部署与公网验证 | 90 | 130 |
| Reporting | README、博客、验收清单 | 90 | 120 |
| 合计 | 750 | 940 |
偏差分析(如实):
sshd 实测 active/enabled/22 端口 LISTEN,但公网连接只能建立 TCP、读不到 SSH banner。最终定位为**安全组 sg-default-smb 的入方向规则缺少"IPv4 / TCP / 22 / 0.0.0.0/0"**(原有规则只有"组内互通")。这是一次典型的"分层排查"——把"能连上"和"能通信"分开看才找到根因。小刚是计算机视觉初学者,想了解 CVPR / ICCV / ECCV 的研究热点。但三大顶会论文量极大(以 CVPR 为例,2025 年投稿 13008 篇、录取 2878 篇),逐篇阅读总结几乎不可行。他需要的不是一个"更强的搜索引擎",而是把"热点发现"这件事自动化:能看到 Top 10 方向、能看到方向之间的关系、能看到热度随年份与会议的走势,并且能从热点一键下钻到具体论文。
核心判断:不做"单一检索工具",做"从热点发现到论文定位"的闭环。
title / authors / conference / year / abstract / keywords / doi / paper_url / pdf_url / source 十个字段。没有统一模型就不可能有可解释的统计。真实网络采集 → 多源适配 → 清洗去重 → SQLite 缓存 → 统计分析 → 可视化探索,六个环节都有实例数据。ON CONFLICT ... DO UPDATE 配合 CASE WHEN excluded.x <> '' / COALESCE),保证"第二次抓到更穷的记录不会把第一次的有效字段冲成空"。用户路径从"检索→逐篇读→自己总结"变成"看 Top 10 → 点关键词看关系 → 下钻到论文 → 看趋势判断方向升降"。对课程场景,它把"论文管理 + 统计分析 + 趋势对比"放到同一个可解释界面里,而不是分散在检索站与表格工具之间。
| 竞品 | 强在哪 | 本项目如何与之差异 |
|---|---|---|
| DBLP | 数据规模大、检索权威 | 不拼规模。本平台只聚焦 CVPR/ICCV/ECCV 三会,并且把"统计口径 + 数据来源"直接写在页面上 |
| Google Scholar | 覆盖面最广、引用数据强 | 不提供引用分析,换取向"热点聚合 + 关系图谱 + 年份走势"的可解释可视化 |
| OpenAlex 官网 | 开放 API、字段丰富 | 面向研究者的原始数据检索,非面向初学者的"热点结论" |
| Connected Papers | 关系图做得成熟 | 它以单篇论文为中心;本项目以会议 + 关键词 + 年份为轴心,服务"领域热点"而非"单篇引文" |
| 三会官方站点(CVF/ECVA) | 数据权威 | 只有会议论文列表,没有统计与可视化。本平台把它作为数据源,补上分析与呈现层 |
差异化优势:① 三会聚焦 + 口径透明;② 从"热点"到"论文"的可点击闭环;③ 数据来源字段可溯源(每篇论文都能看到来自 CVF / ECVA / OpenAlex / DBLP 的哪一处);④ 采集失败可解释,不制造"看起来有数据"的假象。
本地可运行项目、专用原型工具只读分享链接、CodeArts 仓库、云服务器公网地址、本博客。所有外部地址均为实测可访问的真实地址,未完成的项在 第 10 节明确标注为 PARTIAL/MISSING,不虚构。
五个一级页面 + 三条跨页联动:
主页(热门方向总览)
 ├─ 4 个统计卡片(论文总量 / 会议覆盖 / 年份范围 / 关键词数)
 ├─ Top 10 热门方向(柱状图)
 └─ 关键词图谱(力导向图)──点击关键词──▶ 相关论文列表

热度走势对比页
 └─ CVPR / ICCV / ECCV 多年份折线图 + 播放/暂停动画

年度热词演变页
 └─ 历年 Top 10 榜单演变

方向探索页
 └─ 可解释方向分组 → 代表论文

论文管理页
 ├─ 模糊查询 / 题目精确查询
 ├─ 论文表格(编号/题目/会议/年份/关键词/操作)
 ├─ 增 / 删 / 改 / 详情
 └─ 本地未命中 ──▶ 联网检索结果(可保存入库)

爬取 / 导入页
 ├─ 单篇题目联网检索
 └─ 批量文本导入(单次上限 10 行)

关于页
 └─ 数据来源、统计口径、数据流、技术栈
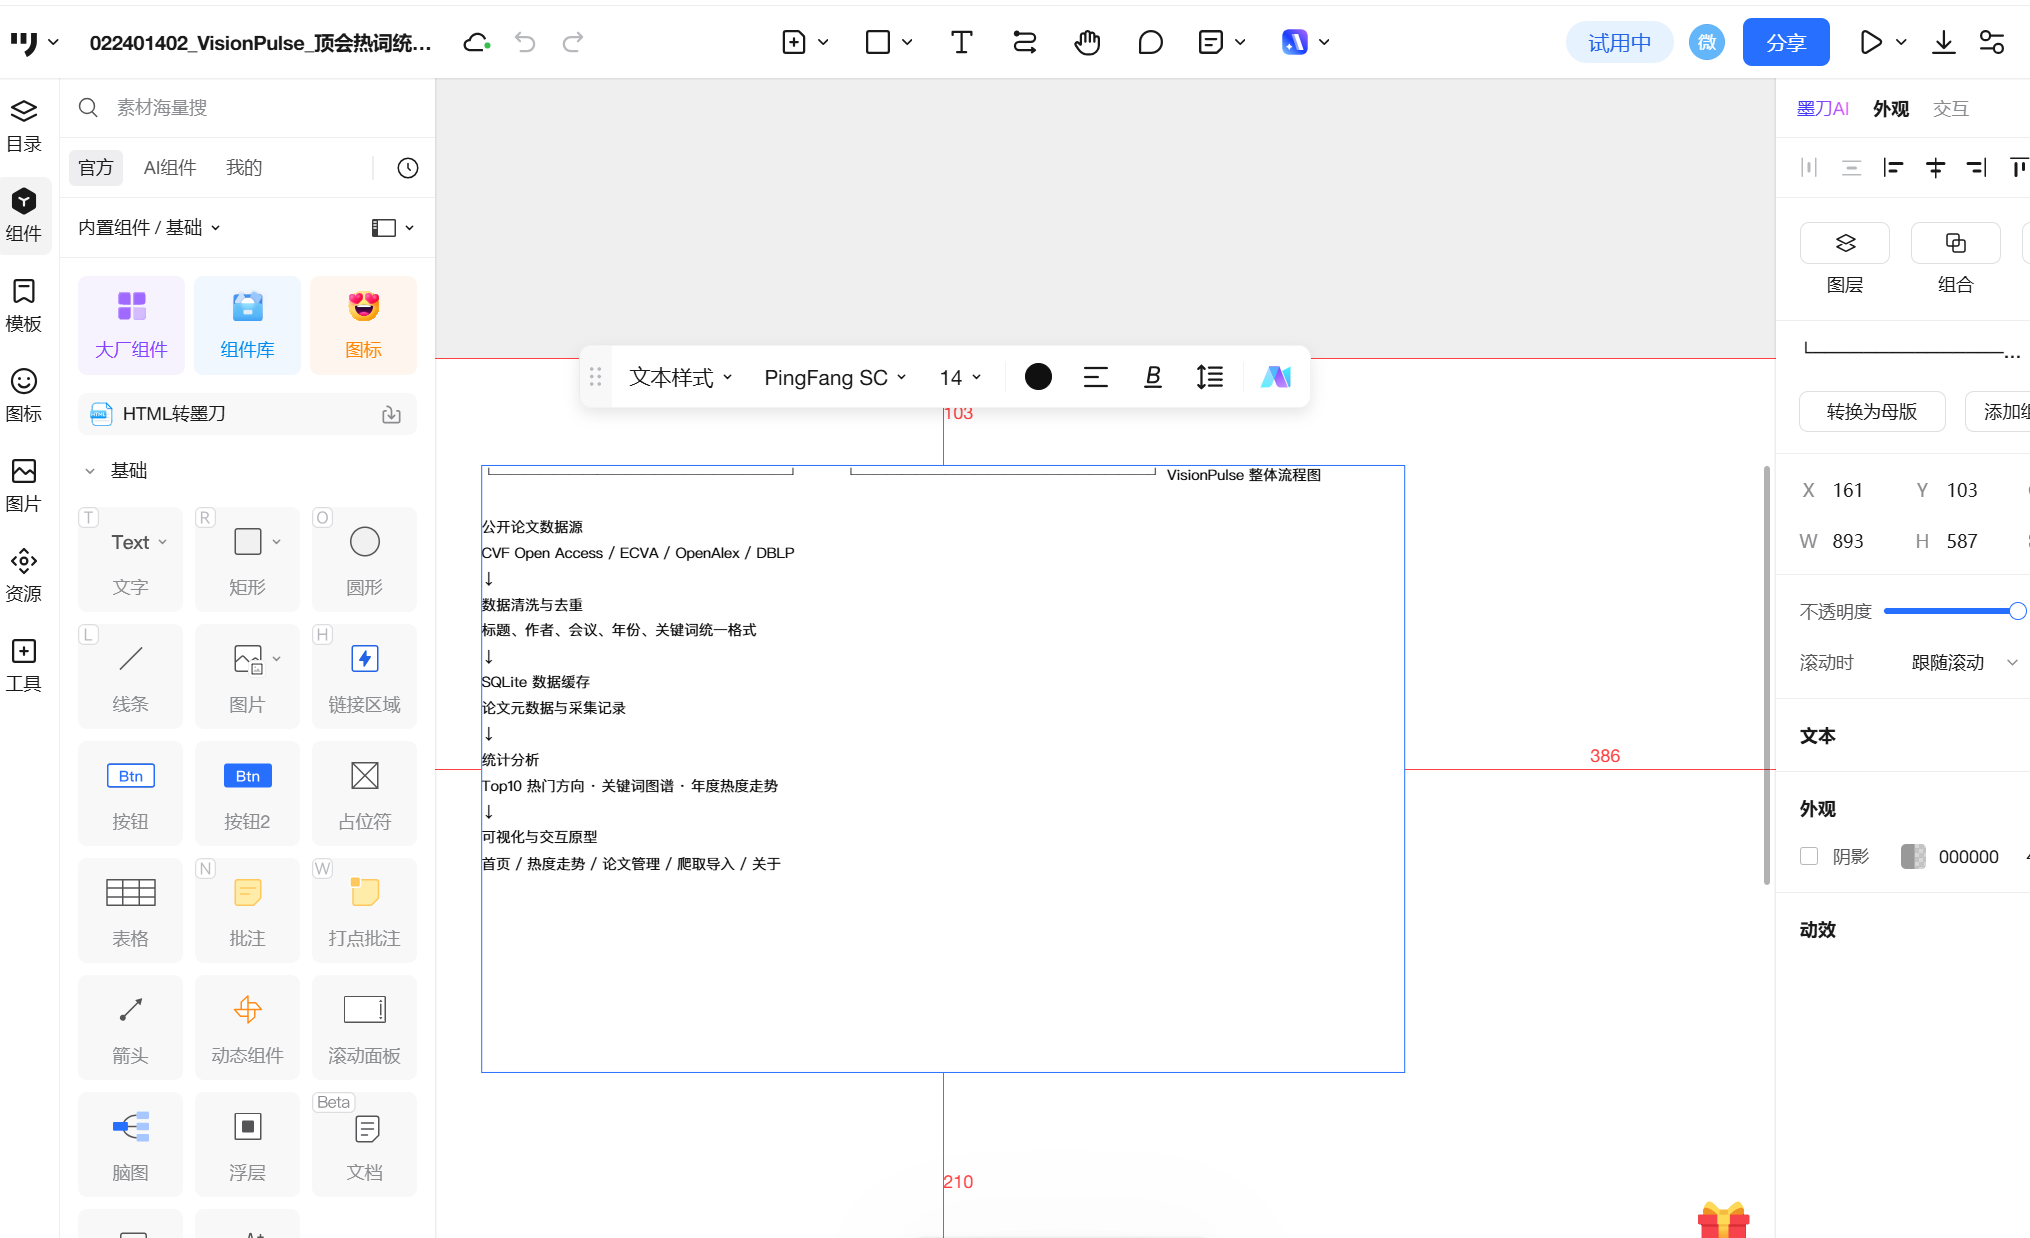
https://modao.cc/proto/design/pb2muforp4p9uwxm8?open_access_menu=
| 层 | 选型 | 依据 |
|---|---|---|
| 前端 | Vue 3 + ECharts 5(原生单页,无构建产物) | index.html / app.js / style.css |
| 后端 | FastAPI(Python 3.13)+ Pydantic 校验 | backend/main.py |
| 存储 | SQLite(单文件,零外部服务) | backend/db.py |
| 采集 | Python 标准库 urllib + 正则解析 | backend/sources.py |
| 分析 | 自实现关键词统计 / 方向分类 / 相似度 | backend/analysis.py |
| 部署 | systemd + nginx 反向代理(不依赖 Docker) | visionpulse.service / nginx-visionpulse.conf |
| 可访问性 | 高对比与 prefers-reduced-motion 支持 | accessibility.css |
为什么后端上 FastAPI + SQLite:单文件持久化、零外部服务、迁移即拷贝文件、本地与云上行为一致,把部署变量降到最低。为什么前端不用构建式框架:单页零构建,nginx 直接托管静态资源,减少云上部署环节。
代码级细节(模块 → 文件/函数映射、API 清单、数据库 DDL、ECharts 位置、约 300 行关键代码)见
submission/audit/code-audit.md与submission/audit/key-code.md,由基于真实文件的静态审计产出。
flowchart TD
  A[VisionPulse 平台] --> B[功能1 论文信息爬取]
  A --> C[功能2 论文列表管理]
  A --> D[功能3 Top10 热门方向]
  A --> E[功能4 关键词图谱]
  A --> F[功能5 热度走势对比]
  A --> G[扩展 年度热词演变]
  A --> H[扩展 方向探索]
  A --> I[扩展 相似论文推荐]

  B --> B1[单篇题目检索]
  B --> B2[批量导入 上限10行]
  B --> B3[来源适配 OpenAlex/CVF/ECVA/DBLP]

  C --> C1[增删改查]
  C --> C2[题目精确查询]
  C --> C3[模糊查询 编号/关键词]
  C --> C4[本地未命中转联网检索]
  C --> C5[CSV / JSON 导出]

  B3 --> S[(SQLite 缓存)]
  S --> D
  S --> E
  S --> F
  S --> G
  S --> H
  S --> I
flowchart LR
  CVF[CVF Open Access] --> ADP[多源适配层 sources.py]
  ECVA[ECVA] --> ADP
  OA[OpenAlex API] --> ADP
  DBLP[DBLP API fallback] --> ADP
  ADP --> CLEAN[清洗去重 db.py 标题规范化+DOI部分唯一索引+逐字段择优合并]
  CLEAN --> DB[(SQLite visionpulse.sqlite3)]
  DB --> ANA[统计分析 analysis.py]
  ANA --> VIZ[Vue3 + ECharts 可视化]
依据 data/visionpulse.sqlite3 实际查询结果:
| 维度 | 实测值 |
|---|---|
| 论文总数 | 320 |
| 会议分布 | CVPR 180 · ICCV 80 · ECCV 60 |
| 来源分布 | CVF Open Access 260 · ECVA 60 |
| 年份分布 | 2023 = 160 · 2024 = 160 |
| 数据库大小 | 245,760 B(约 240 KB) |
获取方式:通过公开可访问的会议官方页面与开放 API 采集元数据——CVF Open Access(CVPR / ICCV 论文列表页)、ECVA(ECCV 论文页,按年份注释分区解析)、OpenAlex Works API(检索与摘要倒排索引)、DBLP 检索 API(作为 fallback)。
仅用于课程教学。采集脚本限制单次数量、不做高并发抓取,以降低对公开站点的压力。
with / from / using / for / and / the / via / based / learning / image / images / visual),每篇最多取 8 个。| 项 | 实测值 |
|---|---|
| 云服务 | 华为云 Flexus 应用服务器 L 实例 |
| 区域 | 华北-北京四 |
| 公网地址 | http://119.3.251.115/ |
| 规格 | 2 vCPU / 2 GiB |
| 系统盘 | 40 GiB SSD |
| 操作系统 | Ubuntu 22.04 server 64bit |
| 公网能力 | 弹性公网 IP · 峰值带宽 2 Mbps · 流量包 200 GB/月 |
| 计费 | 包年 / 包月,1 个月,未开启自动续费 |
| 月费 | ¥41.62(无数据盘 / HSS / CBR 等额外付费服务) |
| 到期 | 2026-10-24 |
选型理由:作业要求"部署到华为云 CodeArts/云服务器"。对比后,纯 ECS 路线最低档 1C1G 为 ¥58.60/月且不含带宽;Flexus L 套餐档 ¥41.62/月即含 2C2G + 40GiB 盘 + 2Mbps + 200GB 流量,规格更高、总价更低。运行 Vue 静态页 + FastAPI + SQLite + 320 条数据、低访问量,2C2G 有明显富余。
上传 Git bundle → git clone 解包(校验 commit 与 tag)→ provision-ubuntu.sh 一键脚本:
apt 安装 python3-venv / python3-pip / nginx
→ 建 venv、装 backend/requirements.txt
→ 执行 scripts/seed_dataset.py 采集真实论文元数据入库
→ 安装 systemd 单元并 enable + restart
→ 安装 nginx 站点并配置反向代理
→ 应用内健康检查(校验 paperCount > 0)
127.0.0.1:8000,公网仅开放 nginx 的 80 端口/opt/visionpulse/data/visionpulse.sqlite3,重跑部署不会删除数据目录| 路径 | 状态 | 字节 | 耗时 |
|---|---|---|---|
/ | 200 | 18,231 | 268 ms |
/api/health | 200 | 87 | 94 ms |
/api/papers?page=1&page_size=5 | 200 | 3,292 | 177 ms |
/api/stats/overview | 200 | 124 | 181 ms |
/app.js | 200 | 28,173 | 340 ms |
/style.css | 200 | 7,350 | 189 ms |
/accessibility.css | 200 | 807 | 182 ms |
/favicon.svg | 200 | 178 | 202 ms |
/api/stats/top-directions | 200 | 534 | 196 ms |
/api/stats/keywords | 200 | 924 | 203 ms |
/api/stats/graph | 200 | 6,618 | 219 ms |
/api/stats/trend | 200 | 1,375 | 198 ms |
/api/stats/annual-hotwords | 200 | 1,529 | 166 ms |
/api/stats/directions | 200 | 48,554 | 1,970 ms |
/api/ingest/jobs | 200 | 646 | 543 ms |
关键返回:
/api/health         → {"status":"ok","database":"/opt/visionpulse/data/visionpulse.sqlite3","paperCount":320}
/api/stats/overview → {"papers":320,"keywords":1000,"conferences":["CVPR","ECCV","ICCV"],
                       "years":[2023,2024],"sources":["CVF Open Access","ECVA"]}
CVPR = 180 · ICCV = 80 · ECCV = 60
/api/papers 第一页 → count=320, pageSize=5, totalPages=64
| 项 | 结果 |
|---|---|
| 页面标题 | VisionPulse - 计算机视觉顶会热词分析平台 |
readyState | complete |
| 控制台消息 | [](零条) |
| 页面 JS 报错 | 0 条 |
| 是否白屏 | 否 —— 2 个 ECharts canvas 真实绘制(1102×495) |
| 主要区域 | Top 10 ✓ · 关键词图谱 ✓ · 热度走势 ✓ · 论文管理 ✓ |
| 首页文案 | 「当前论文 320」「会议覆盖 3 CVPR/ICCV/ECCV」 |
问题:云端服务器首次部署后,/api/health 正常、所有接口 200,但种子数据只有 200 篇(CVPR2024 100 篇 + ECCV2024 100 篇,ICCV2024 因 CVF 返回 404 被跳过)。原因是云服务器侧访问 CVF/ECVA 的网络路径不稳定。
解决:不重新联网抓取、不生成任何 mock 数据,而是把本地已完整验证过的真实数据库(320 篇)安全迁移到服务器:
cp -a 备份线上库(带时间戳)install -o www-data -g www-data -m 0640 安装,保持权限与部署脚本一致systemctl restart visionpulsepaperCount=320,CVPR/ICCV/ECCV = 180/80/60过程中出现一次脚本自身缺陷:远端 SHA256 由 Paramiko 以
bytes返回,与本地str比较导致误判不一致而安全中止(线上库未被覆盖)。修复方式是统一解码为str并校验 64 位小写 hex 格式,补了 9 个单元用例(含该 bytes 场景与 4 个非法输入拒绝用例),全部 PASS。这个缺陷被写进 第 8 节案例 C——**"校验机制正确地拦住了一次误覆盖"本身是正面结果**。
现象:服务器内部 systemctl status ssh = active (running)、is-enabled = enabled、0.0.0.0:22 与 [::]:22 均 LISTEN,但本机连不上。
分层取证:
| 测试 | 结果 |
|---|---|
| 原生 TCP 连接 22 | ✅ 能建立 |
| 裸 socket 读 banner | ❌ 0 字节(连续 3 次) |
ssh-keyscan -T 10 | ❌ Connection closed by remote host(多种密钥类型) |
ssh -vvv(BatchMode) | 本机发出 SSH-2.0-OpenSSH_for_Windows_9.5 → ❌ kex_exchange_identification: Connection closed by remote host |
根因:安全组 sg-default-smb 的入方向规则**只有"组内互通"(允许 IPv4 全部 / 源=sg-default-smb、允许 IPv6 全部 / 源=sg-default-smb 与一条拒绝 IPv6 全量的规则),没有任何"IPv4 / TCP / 22 / 0.0.0.0/0"**。所以云侧转发层接受 SYN、安全组却丢弃流量 → banner 永远读不到。
修复与验证:放通入方向 22(同时按需放通 80),随后本机实测:
banner bytes=42 text=[SSH-2.0-OpenSSH_8.9p1 Ubuntu-3ubuntu0.14]
kex: algorithm: curve25519-sha256
kex: host key algorithm: ssh-ed25519
Server host key: ssh-ed25519 SHA256:Hg9ci9ju57pxFcB9s9FY0yN/z1YXm8tBa725Hp+3hRA
Authentications that can continue: publickey,password
重要教训(我自己犯的错,写下来):我一开始根据"22/80/443 端口都能 TCP 握手"就下结论说"安全组已放行"——这是过度解读。当时 80/443 那台机器上根本没有服务在听,却同样"握手成功",说明华为云的公网 IP 前面有一层转发,无论后端是否有服务都会先接受 TCP。所以"TCP 能连上"既不证明安全组放行、也不证明服务在跑。必须读到应用层响应(SSH banner / HTTP 200)才能下结论。
以下 11 张均来自公网真实运行站点 http://119.3.251.115/ 的实际页面截图,
由本机 Puppeteer + Chrome 抓取(视口 1600×1000、deviceScaleFactor 2),
抓取过程中监听到的 console error / pageerror = 0。每张图后附其证明的功能。
图 1|首页首屏:统计卡片(当前论文 320、会议覆盖 3 CVPR/ICCV/ECCV、年份范围、关键词数)与主导航
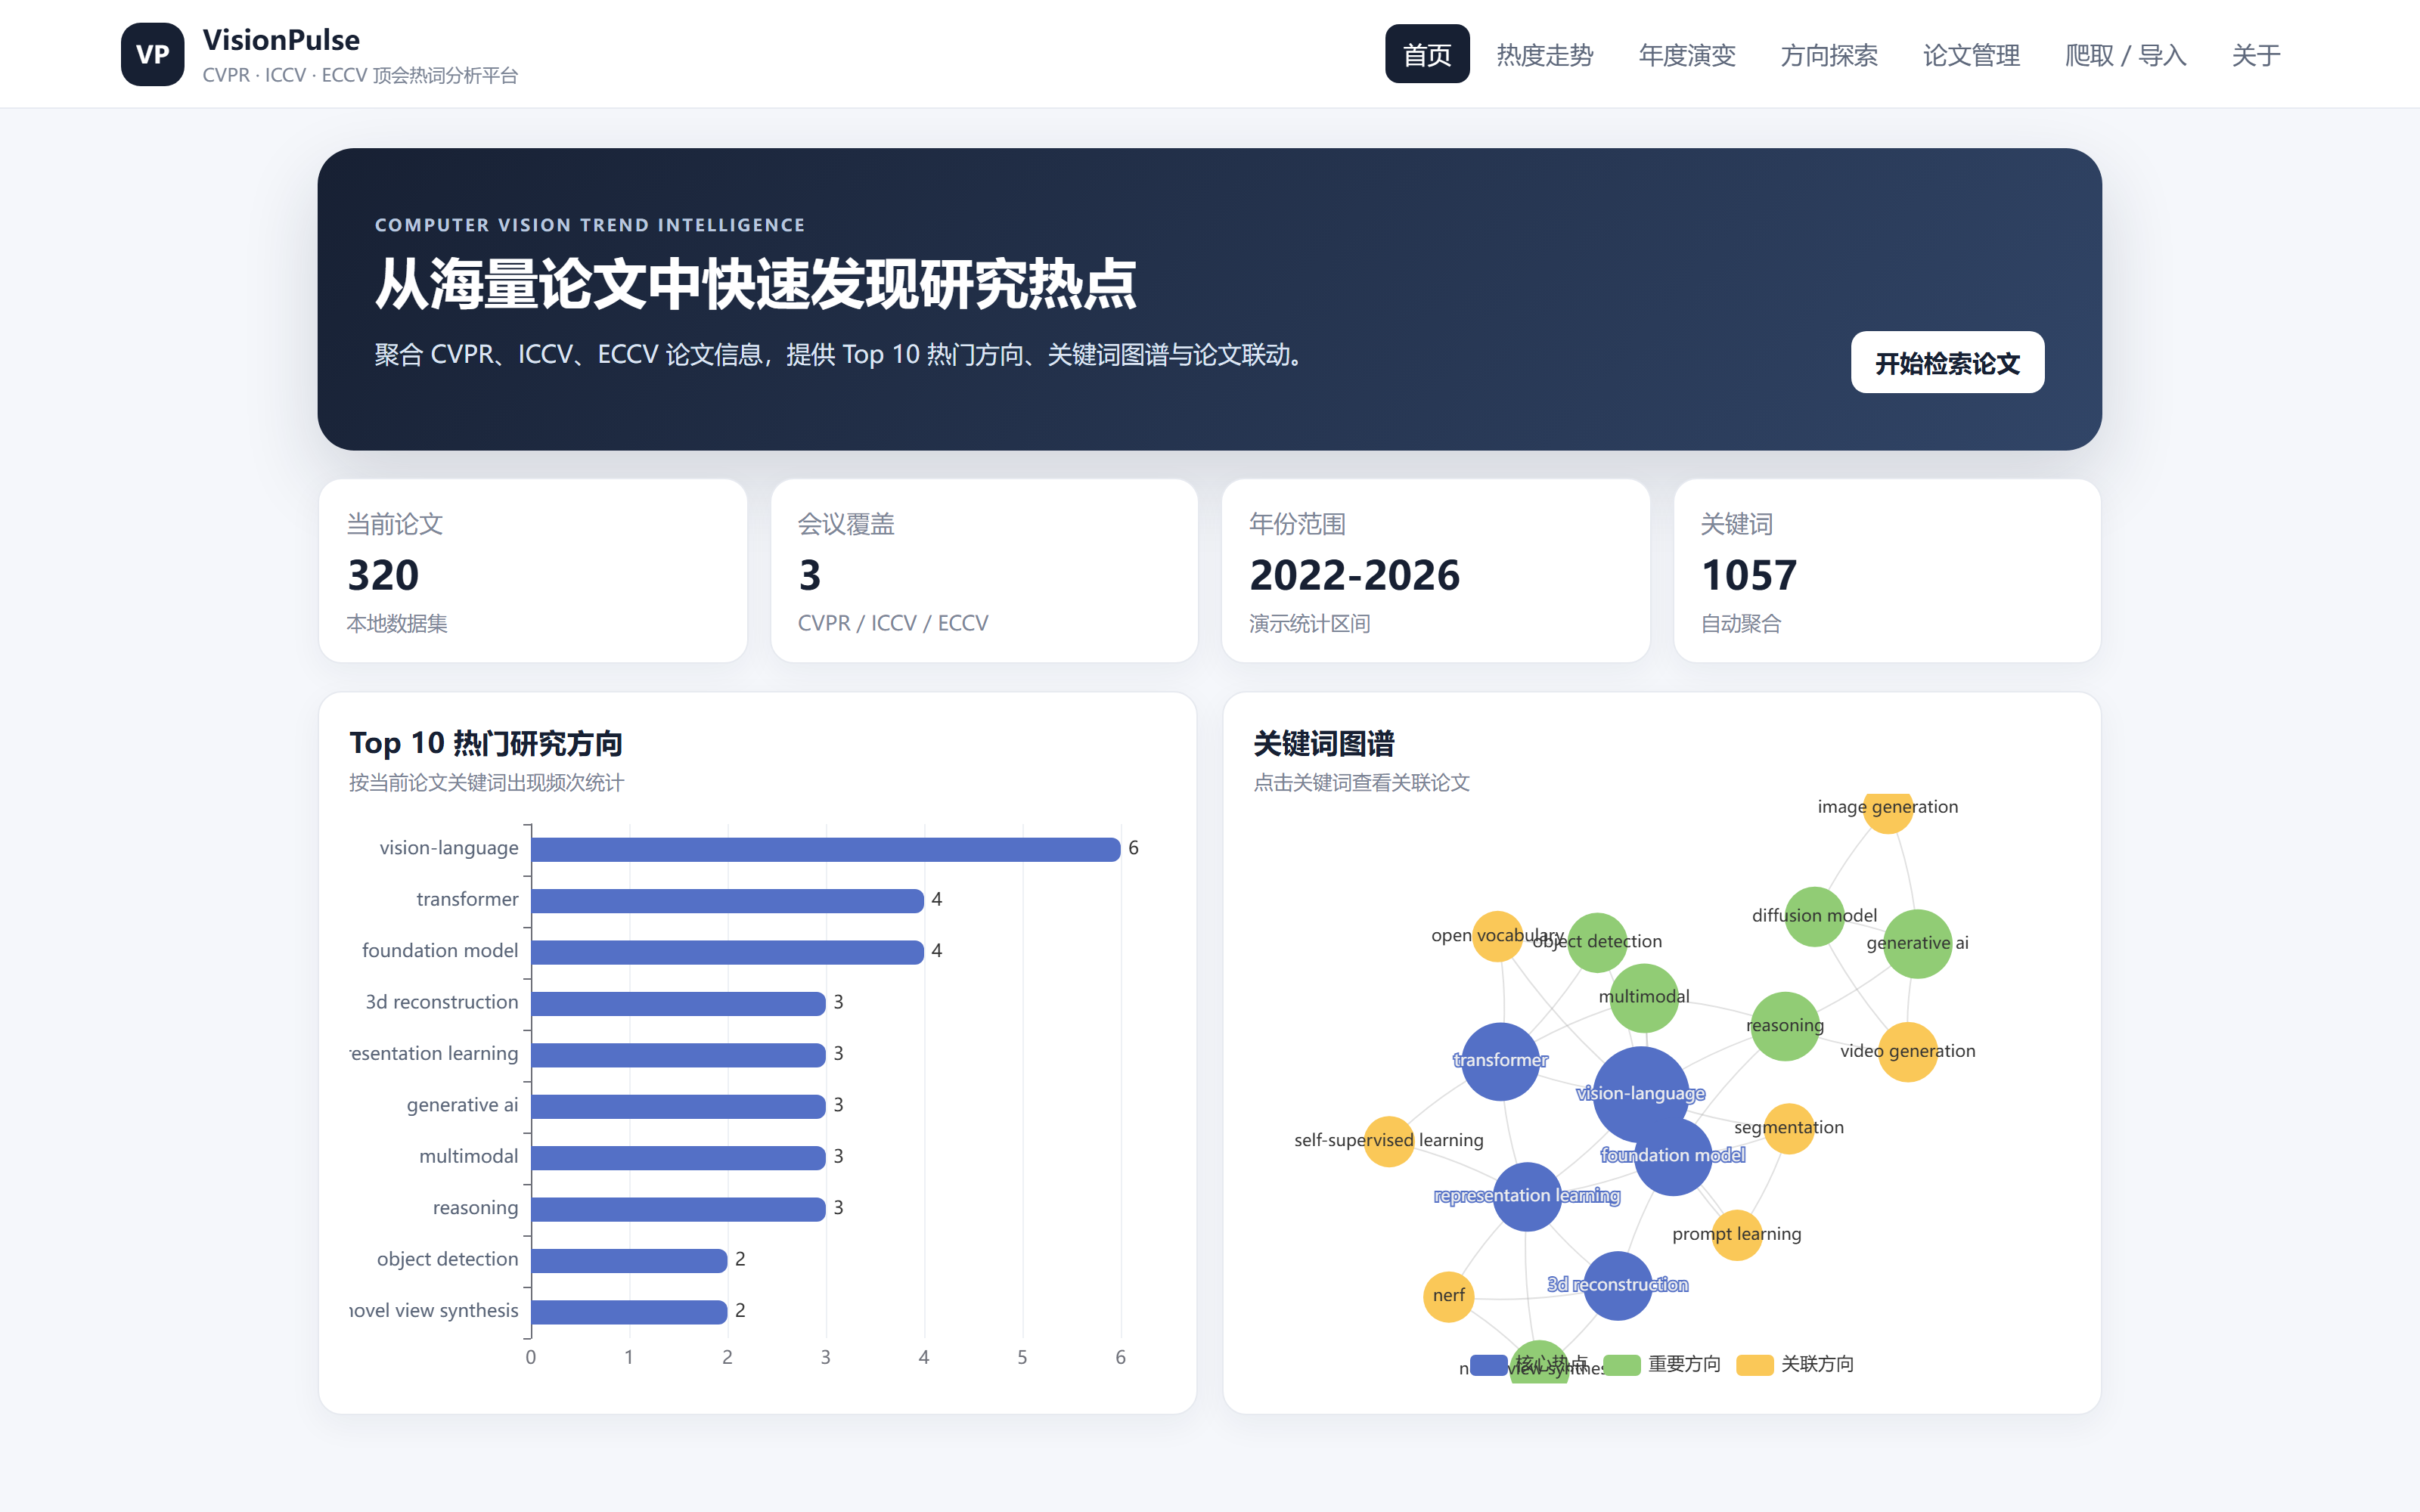
对应功能:平台整体与数据总览
图 2|首页下滚:Top 10 热门方向柱状图
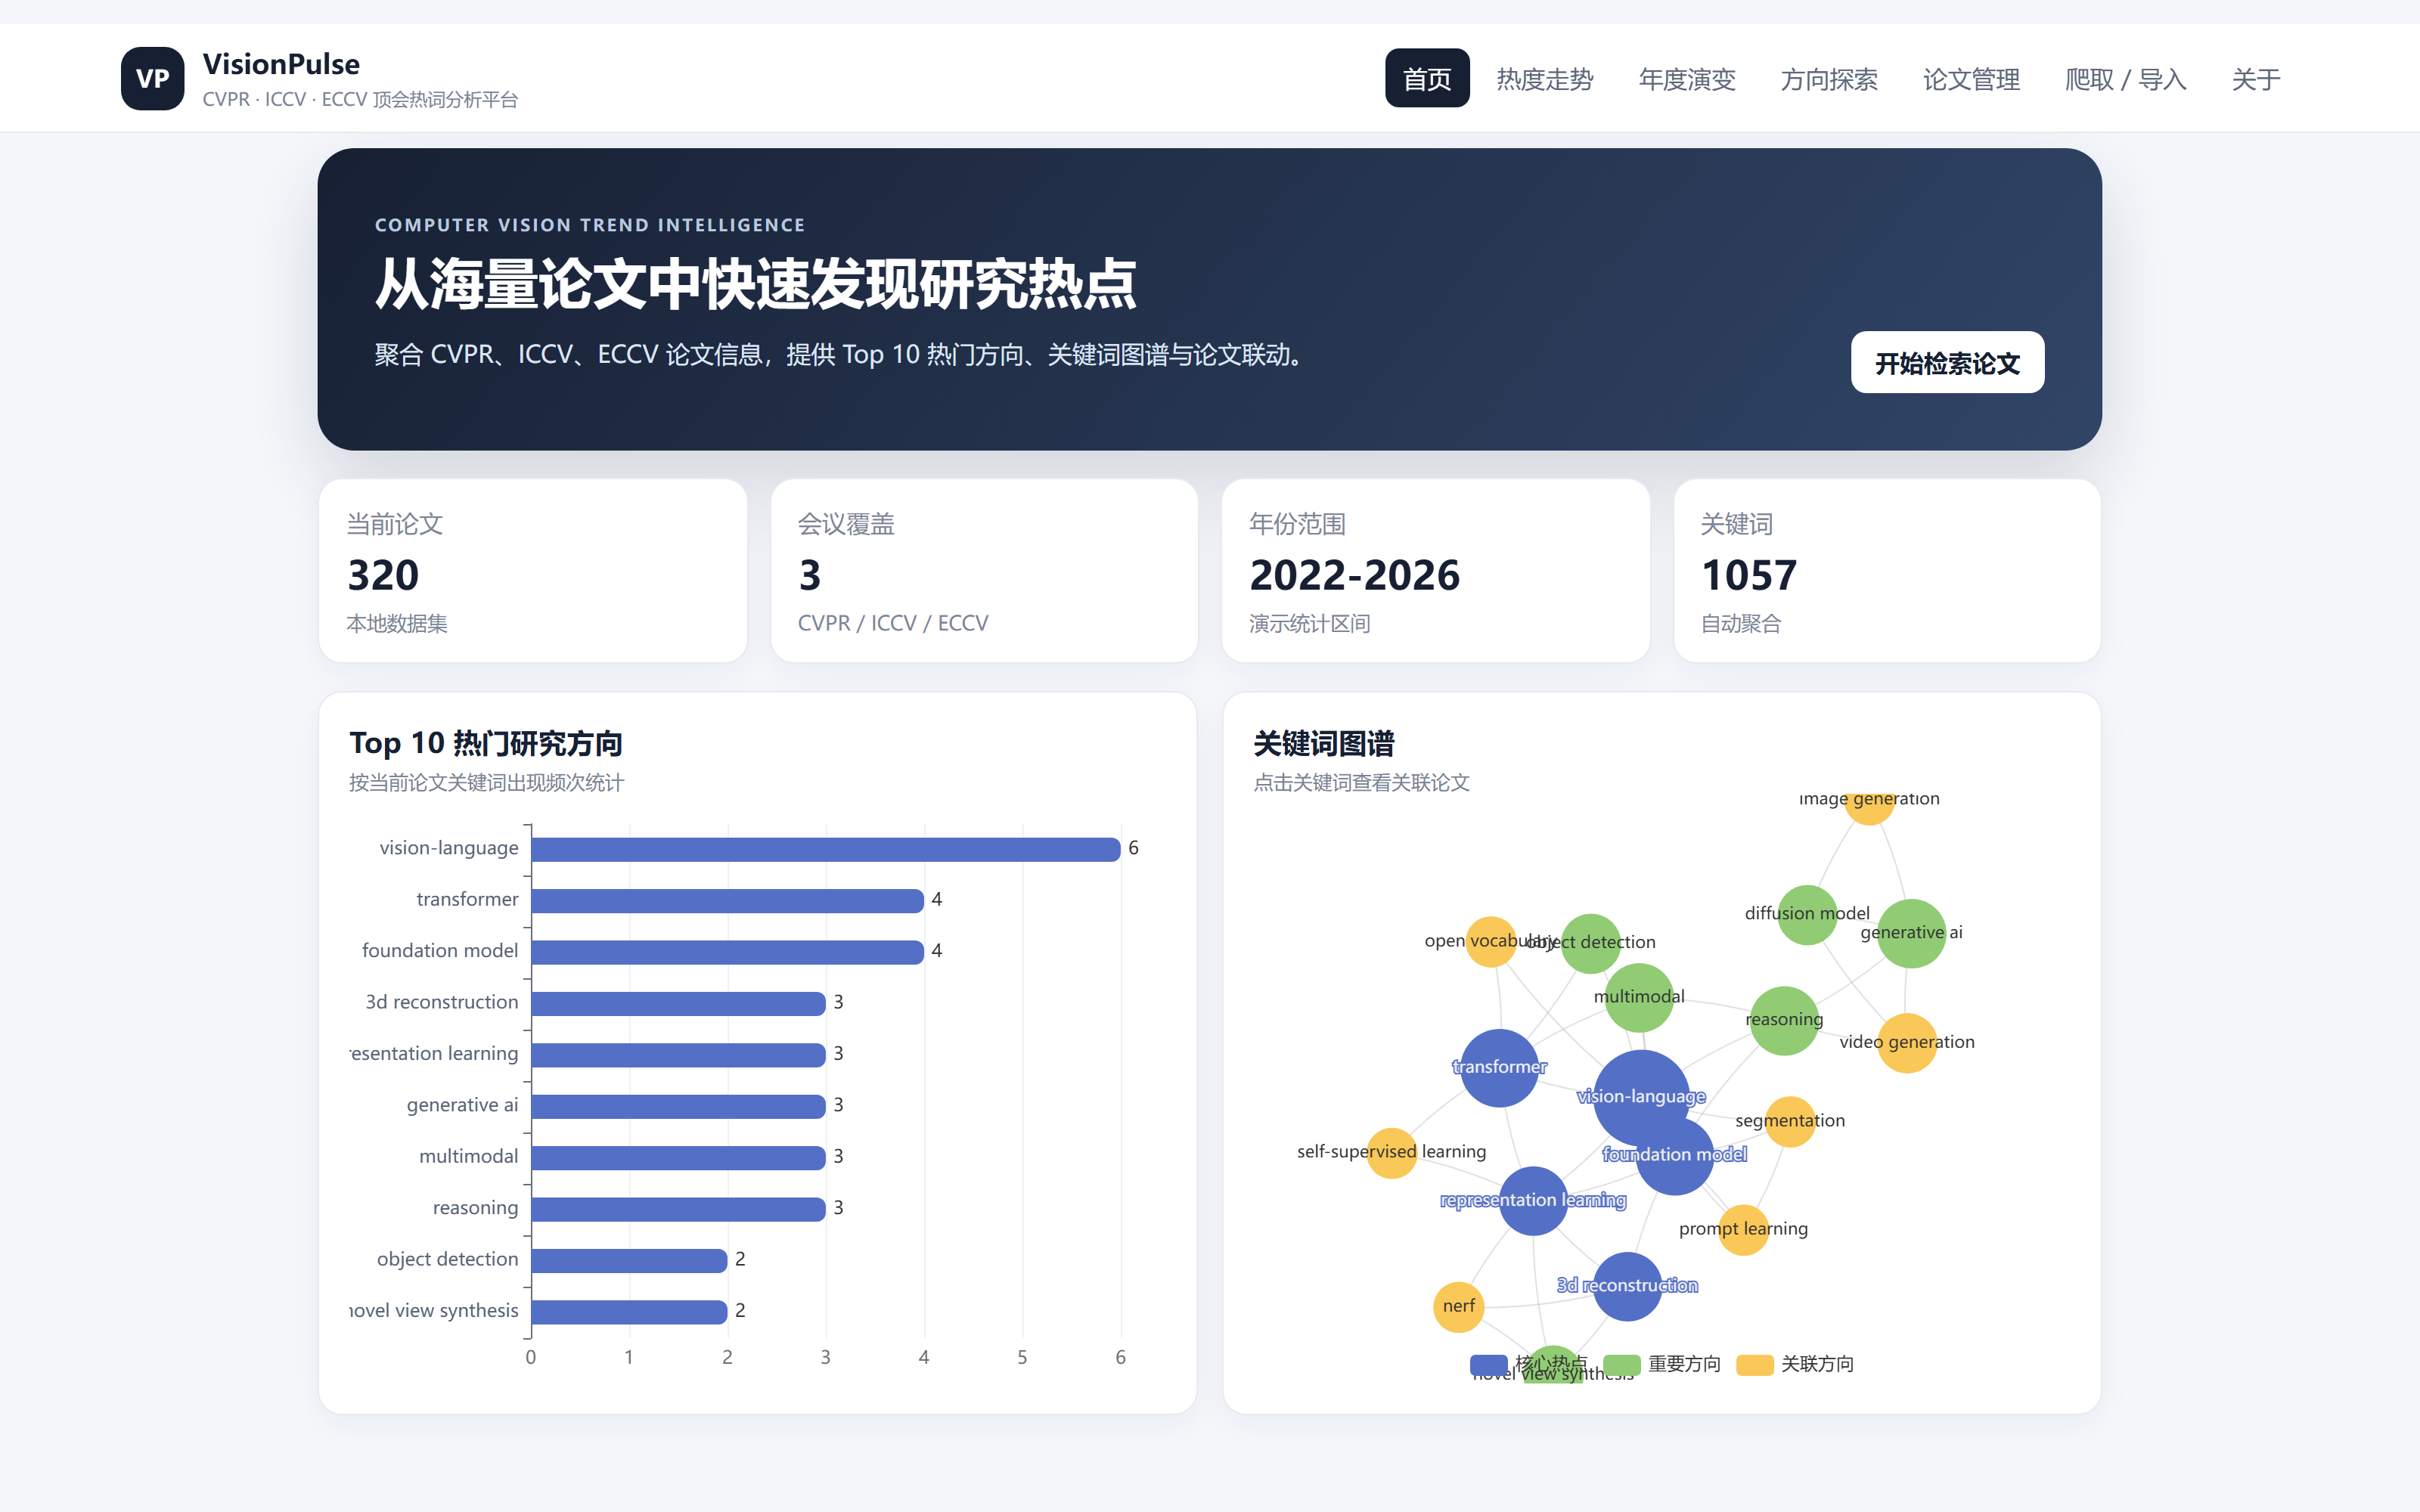
对应功能:功能 3 Top10 热门方向
图 3|首页继续下滚:关键词图谱(力导向共现关系图)
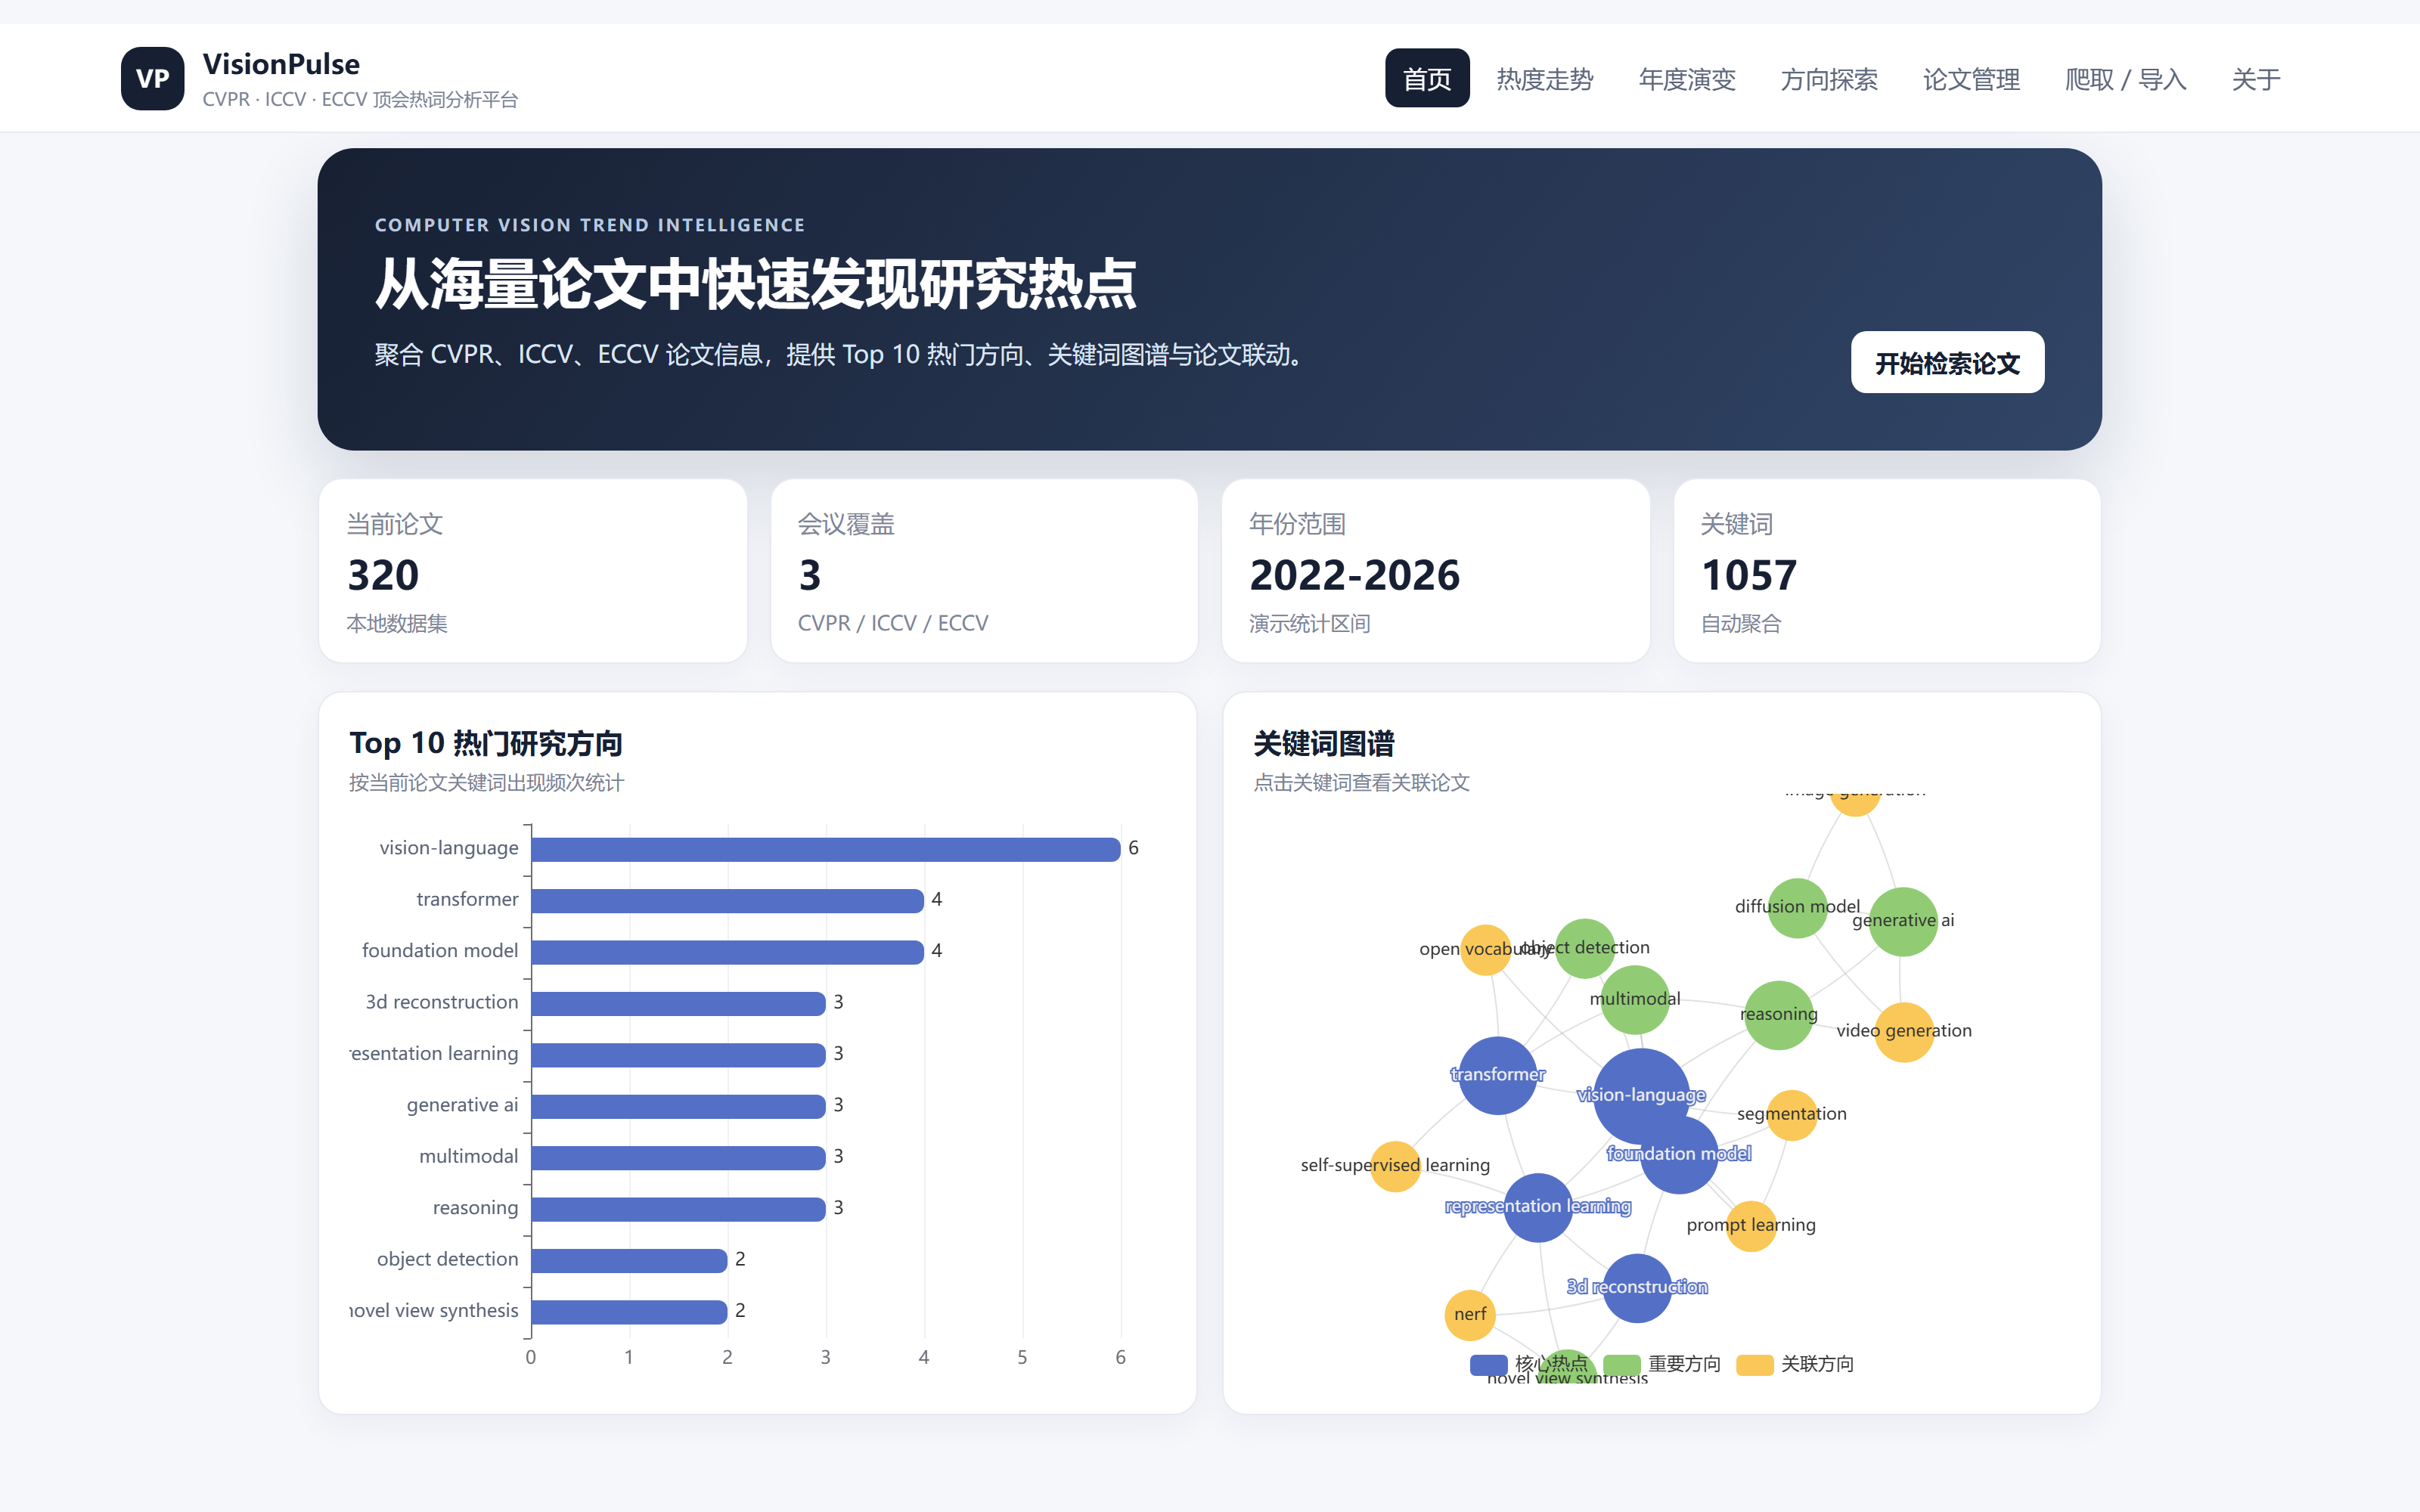
图 4|热度走势对比页:CVPR/ICCV/ECCV 多年份折线图 + 播放控制
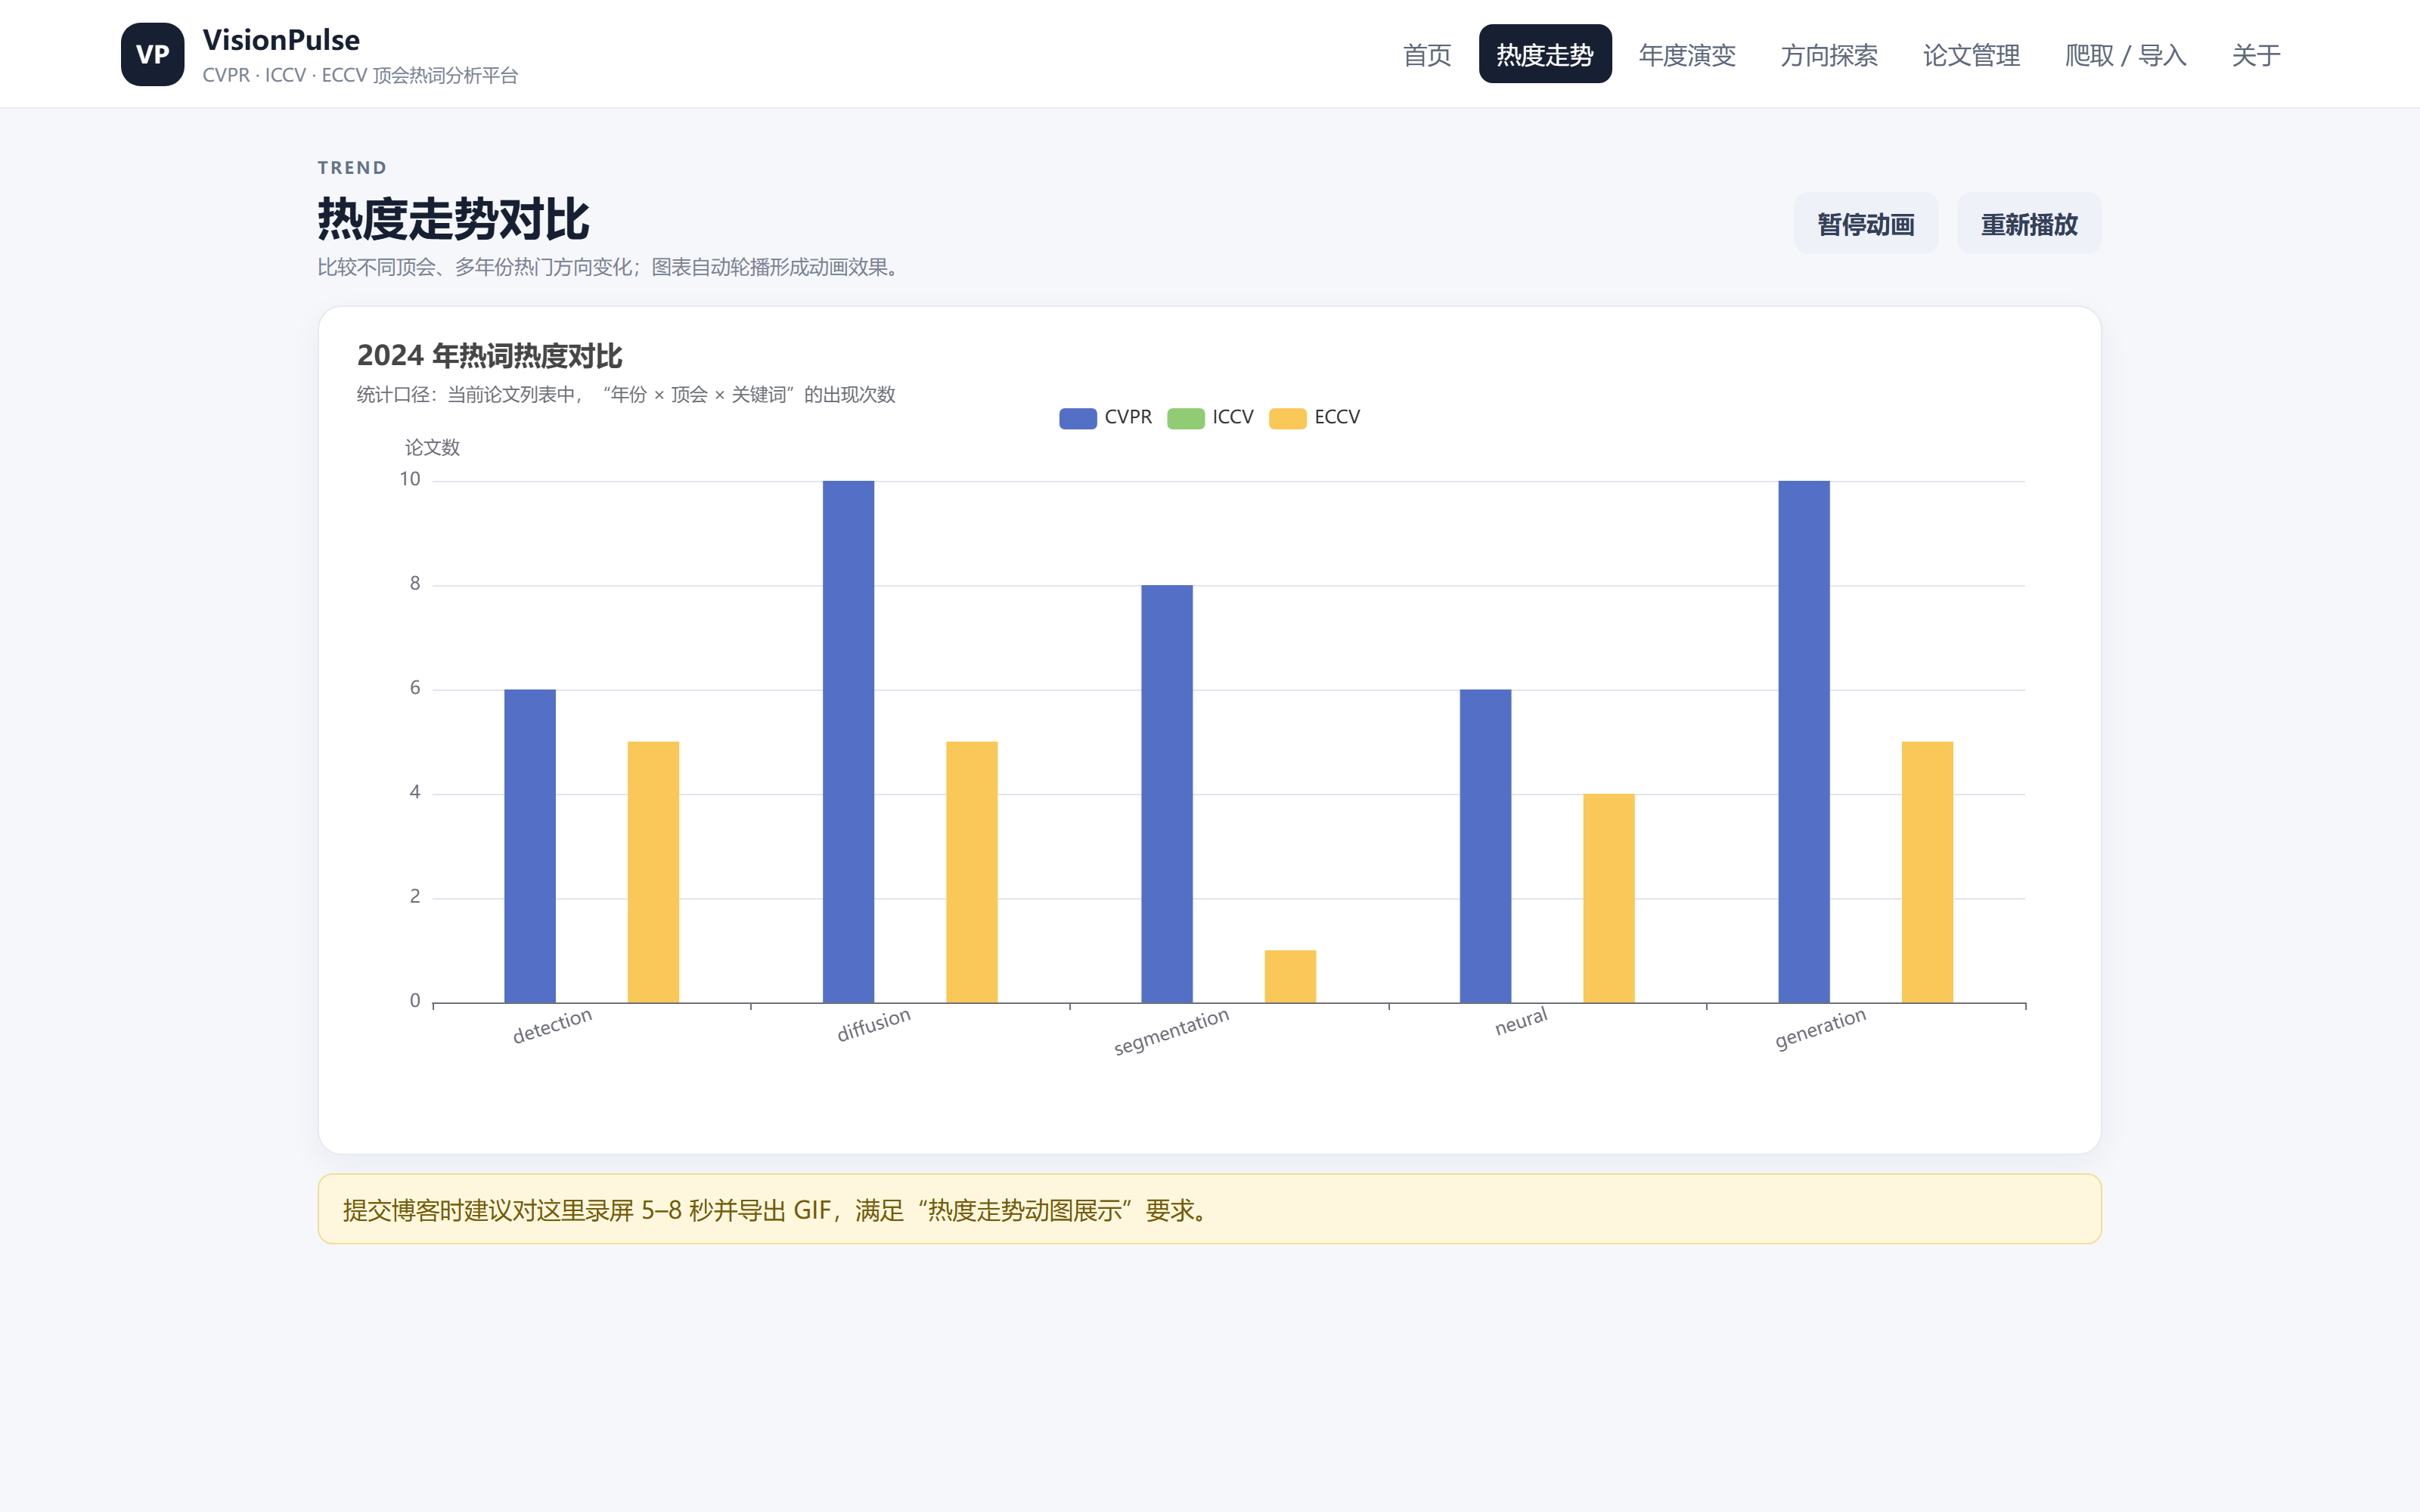
对应功能:功能 5 热度走势对比(动画)
图 5|年度热词演变页:按年独立计算 Top 10 并展示排名变化
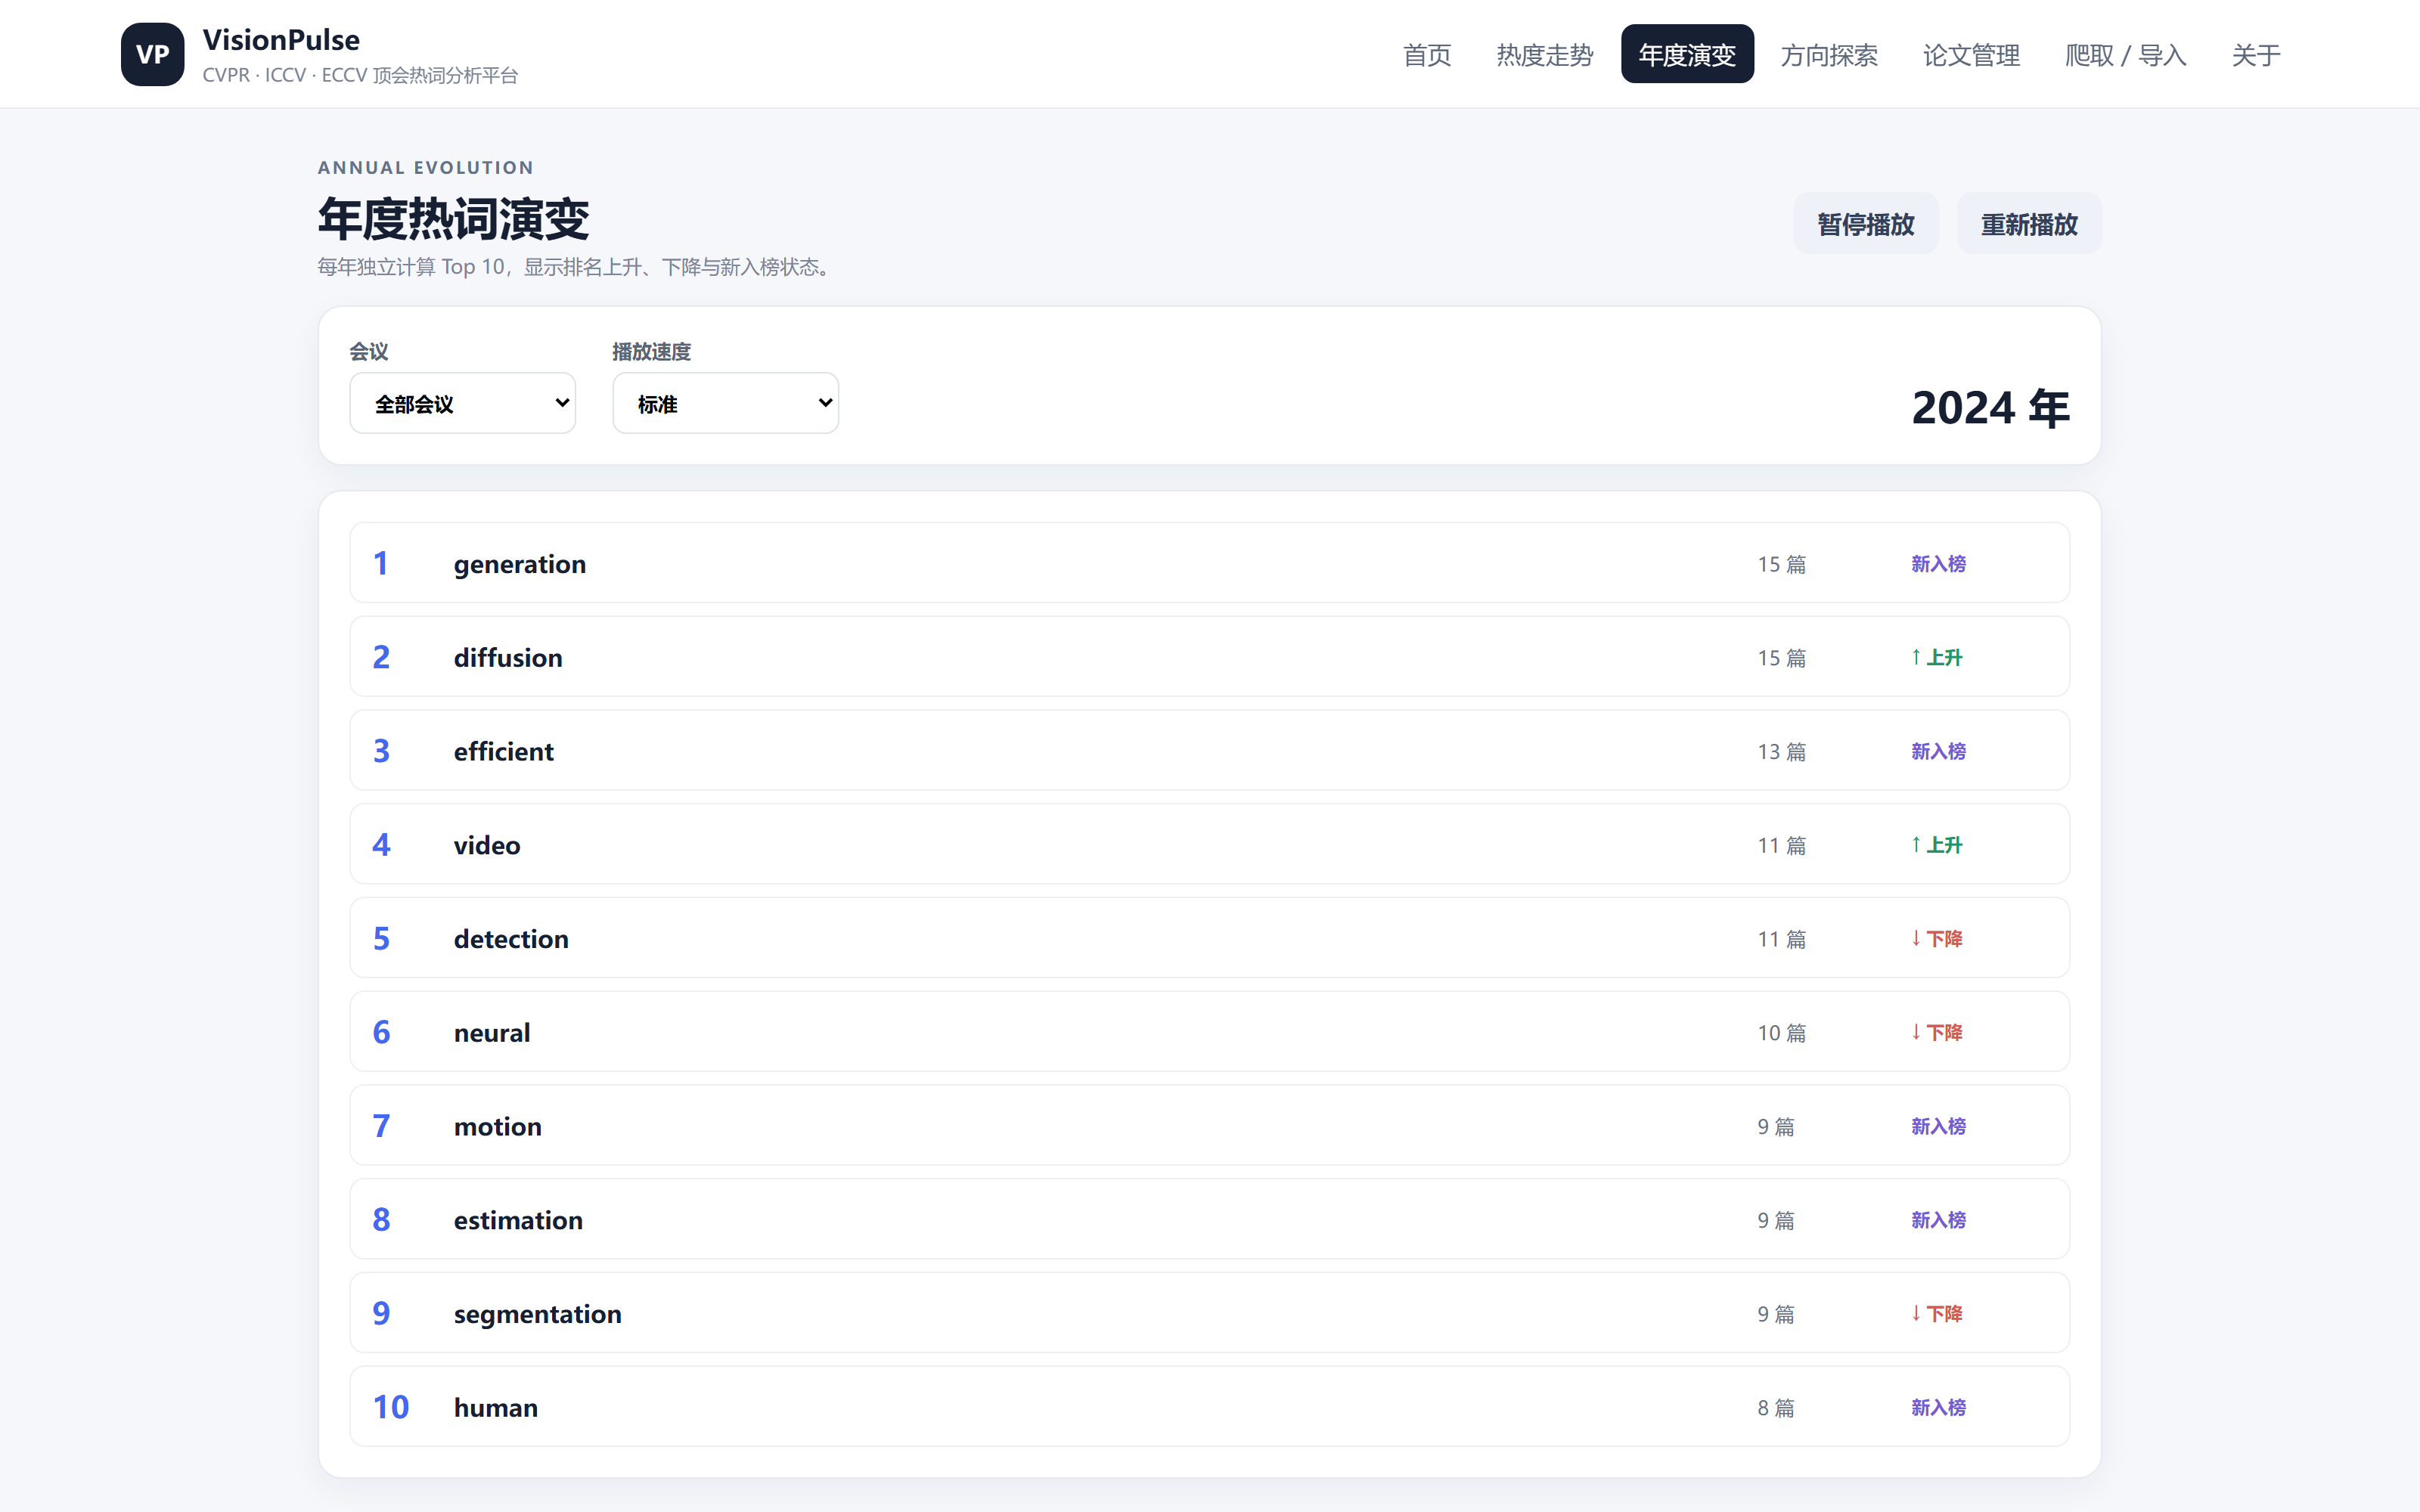
图 6|方向探索页:可解释方向分组与代表论文
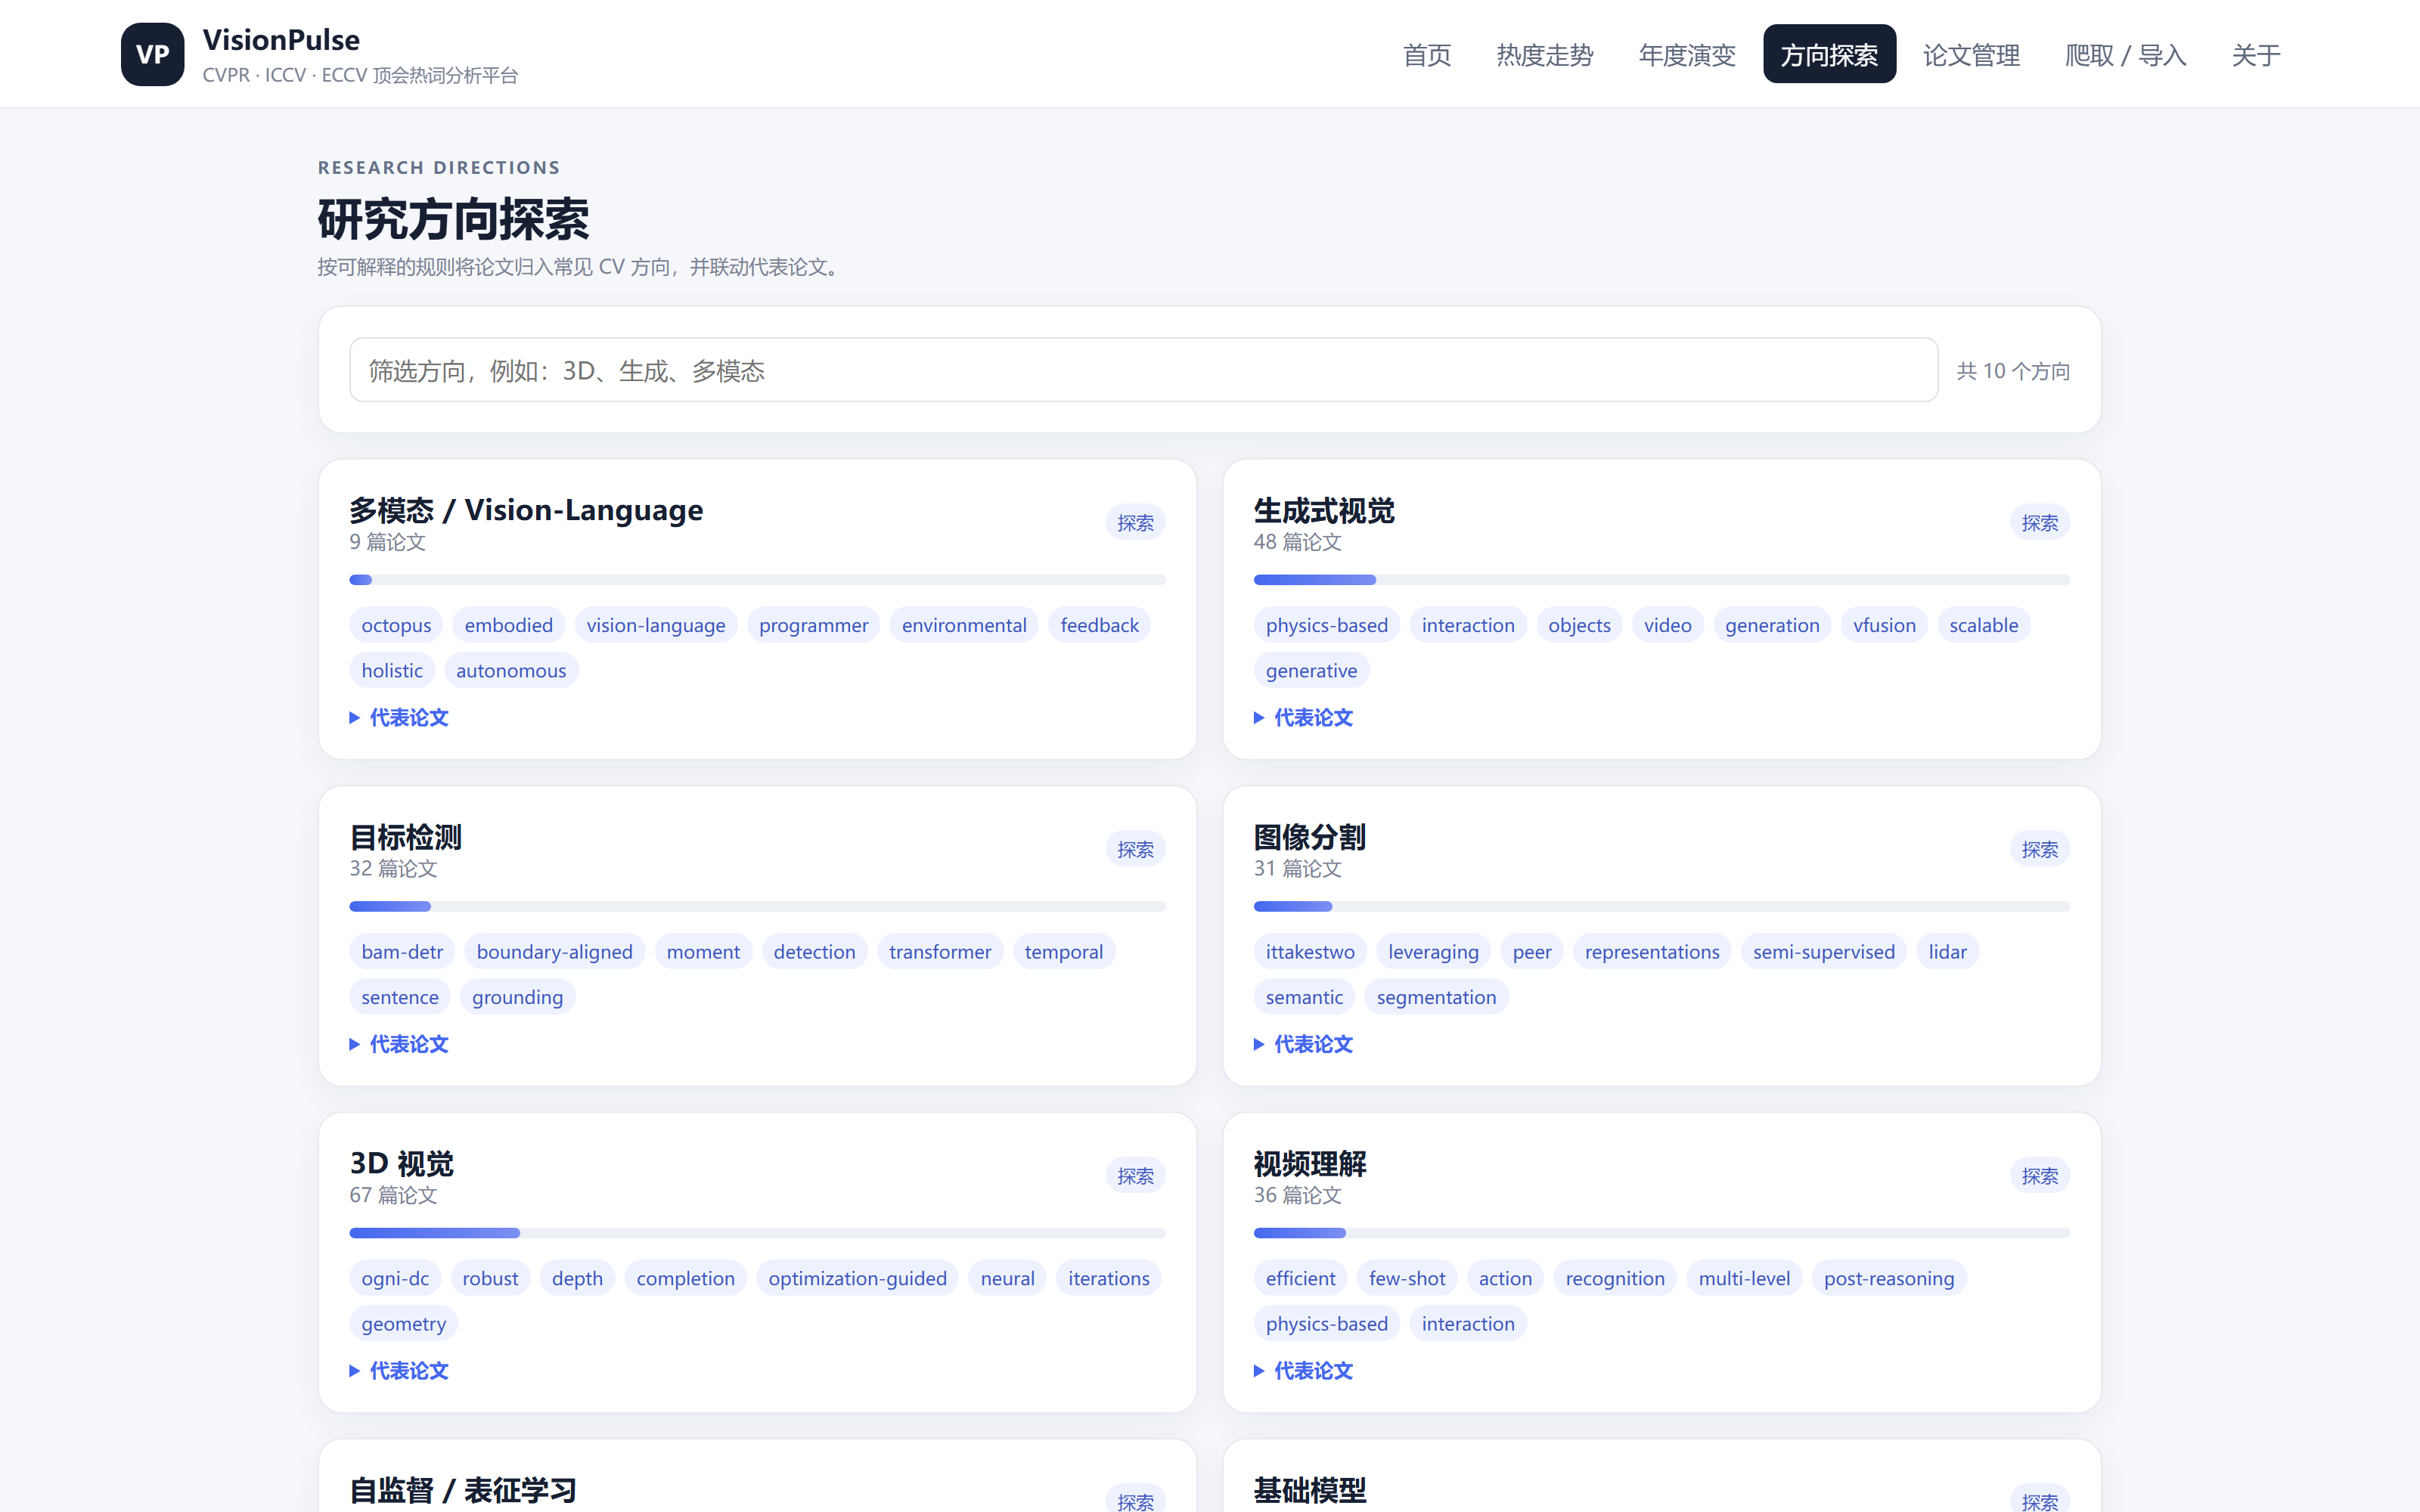
图 7|论文管理页:论文表格、查询区与导出入口
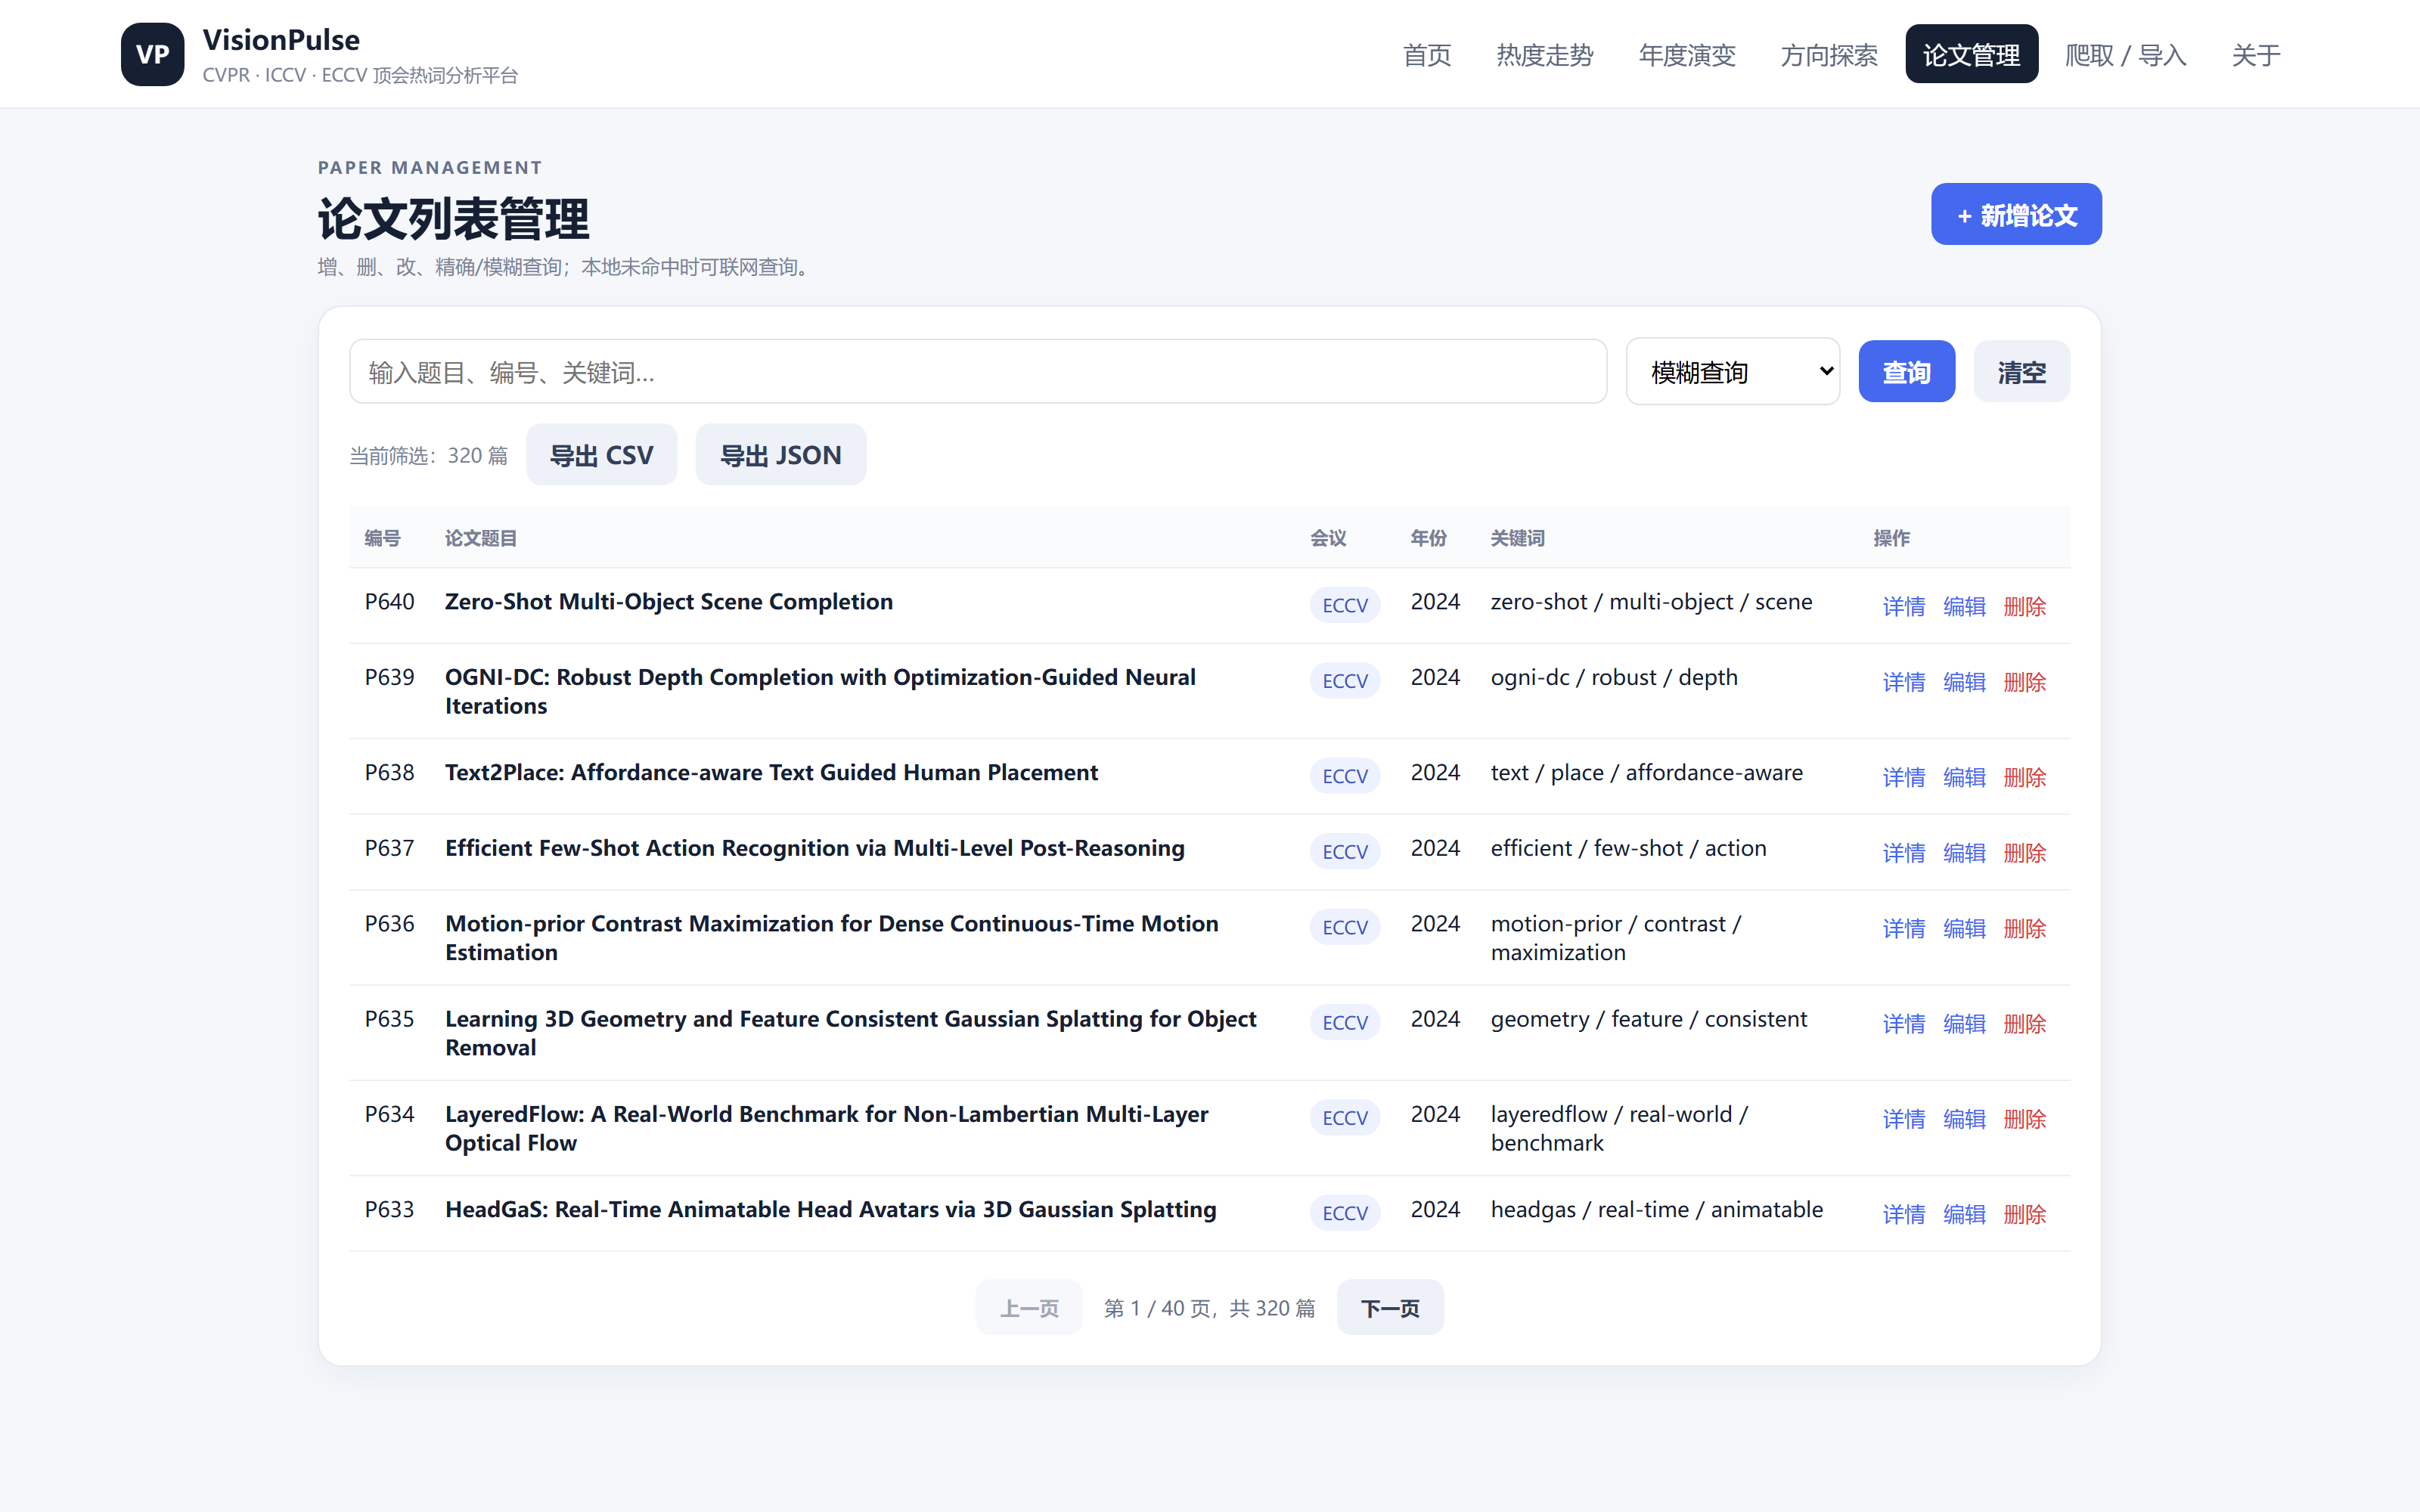
对应功能:功能 2 论文列表管理
图 8|在论文管理页输入关键词执行查询后的结果状态
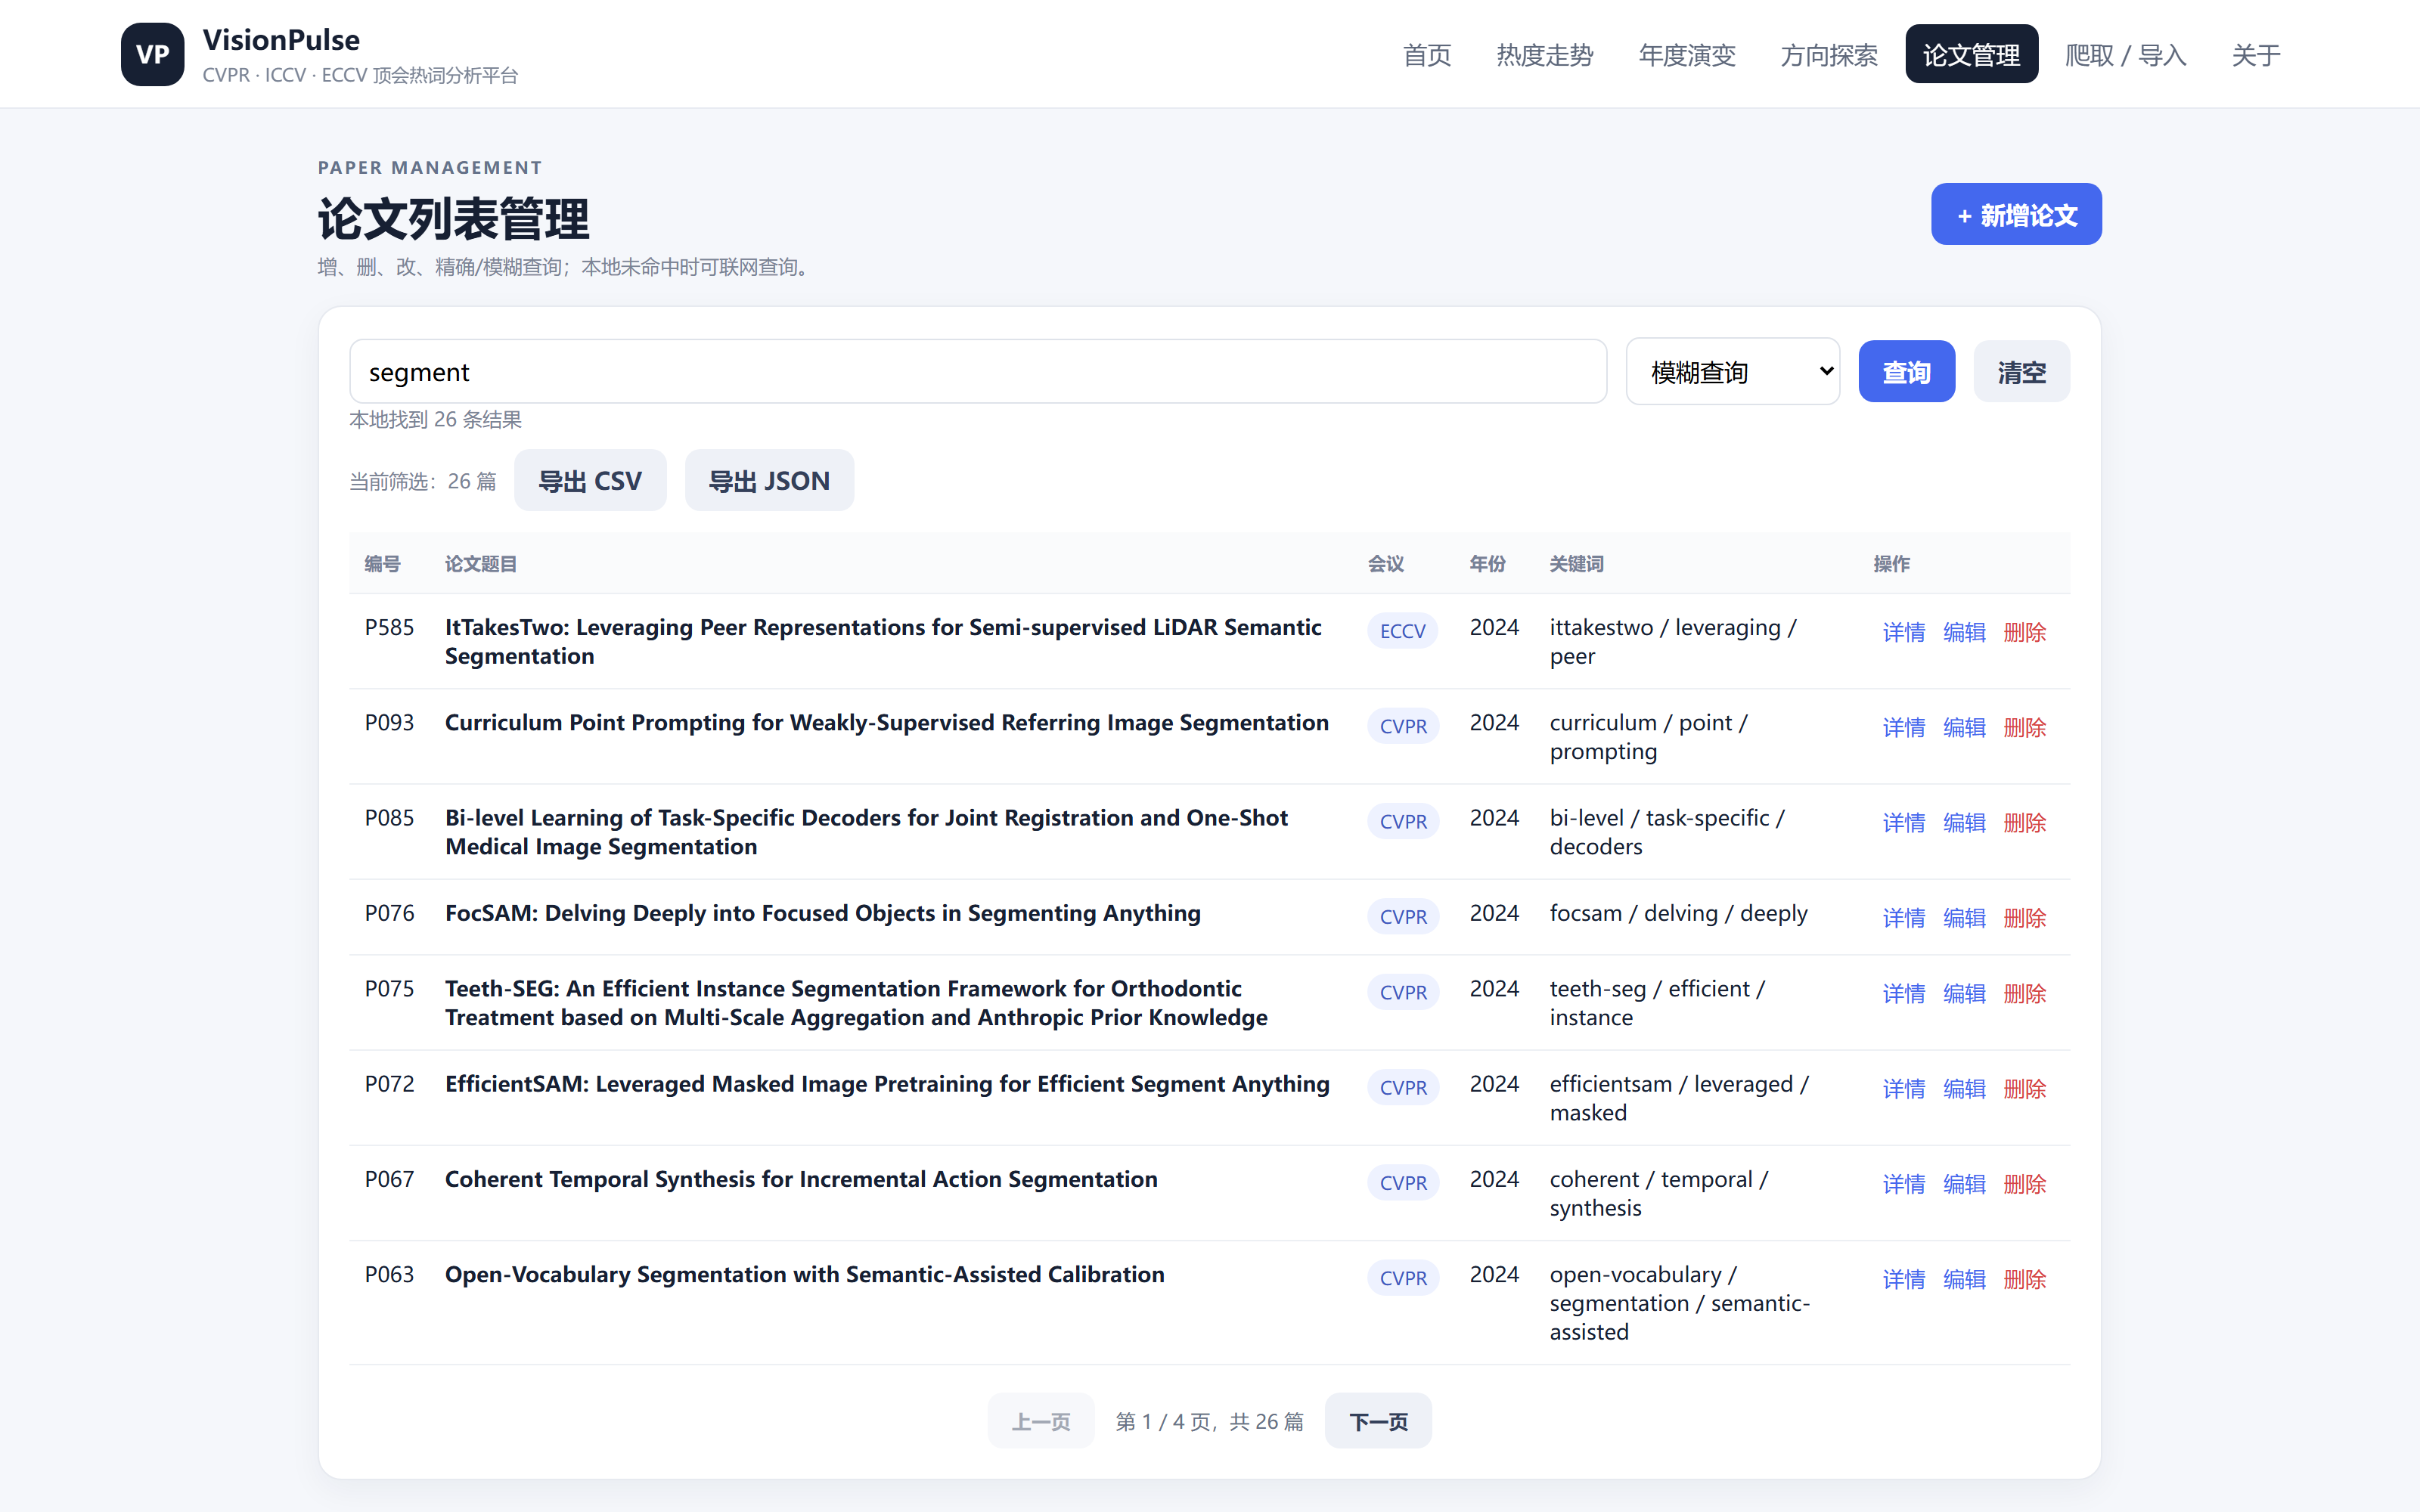
对应功能:功能 2 精确/模糊查询
图 9|论文详情弹窗:含来源、DOI、原文链接等溯源信息
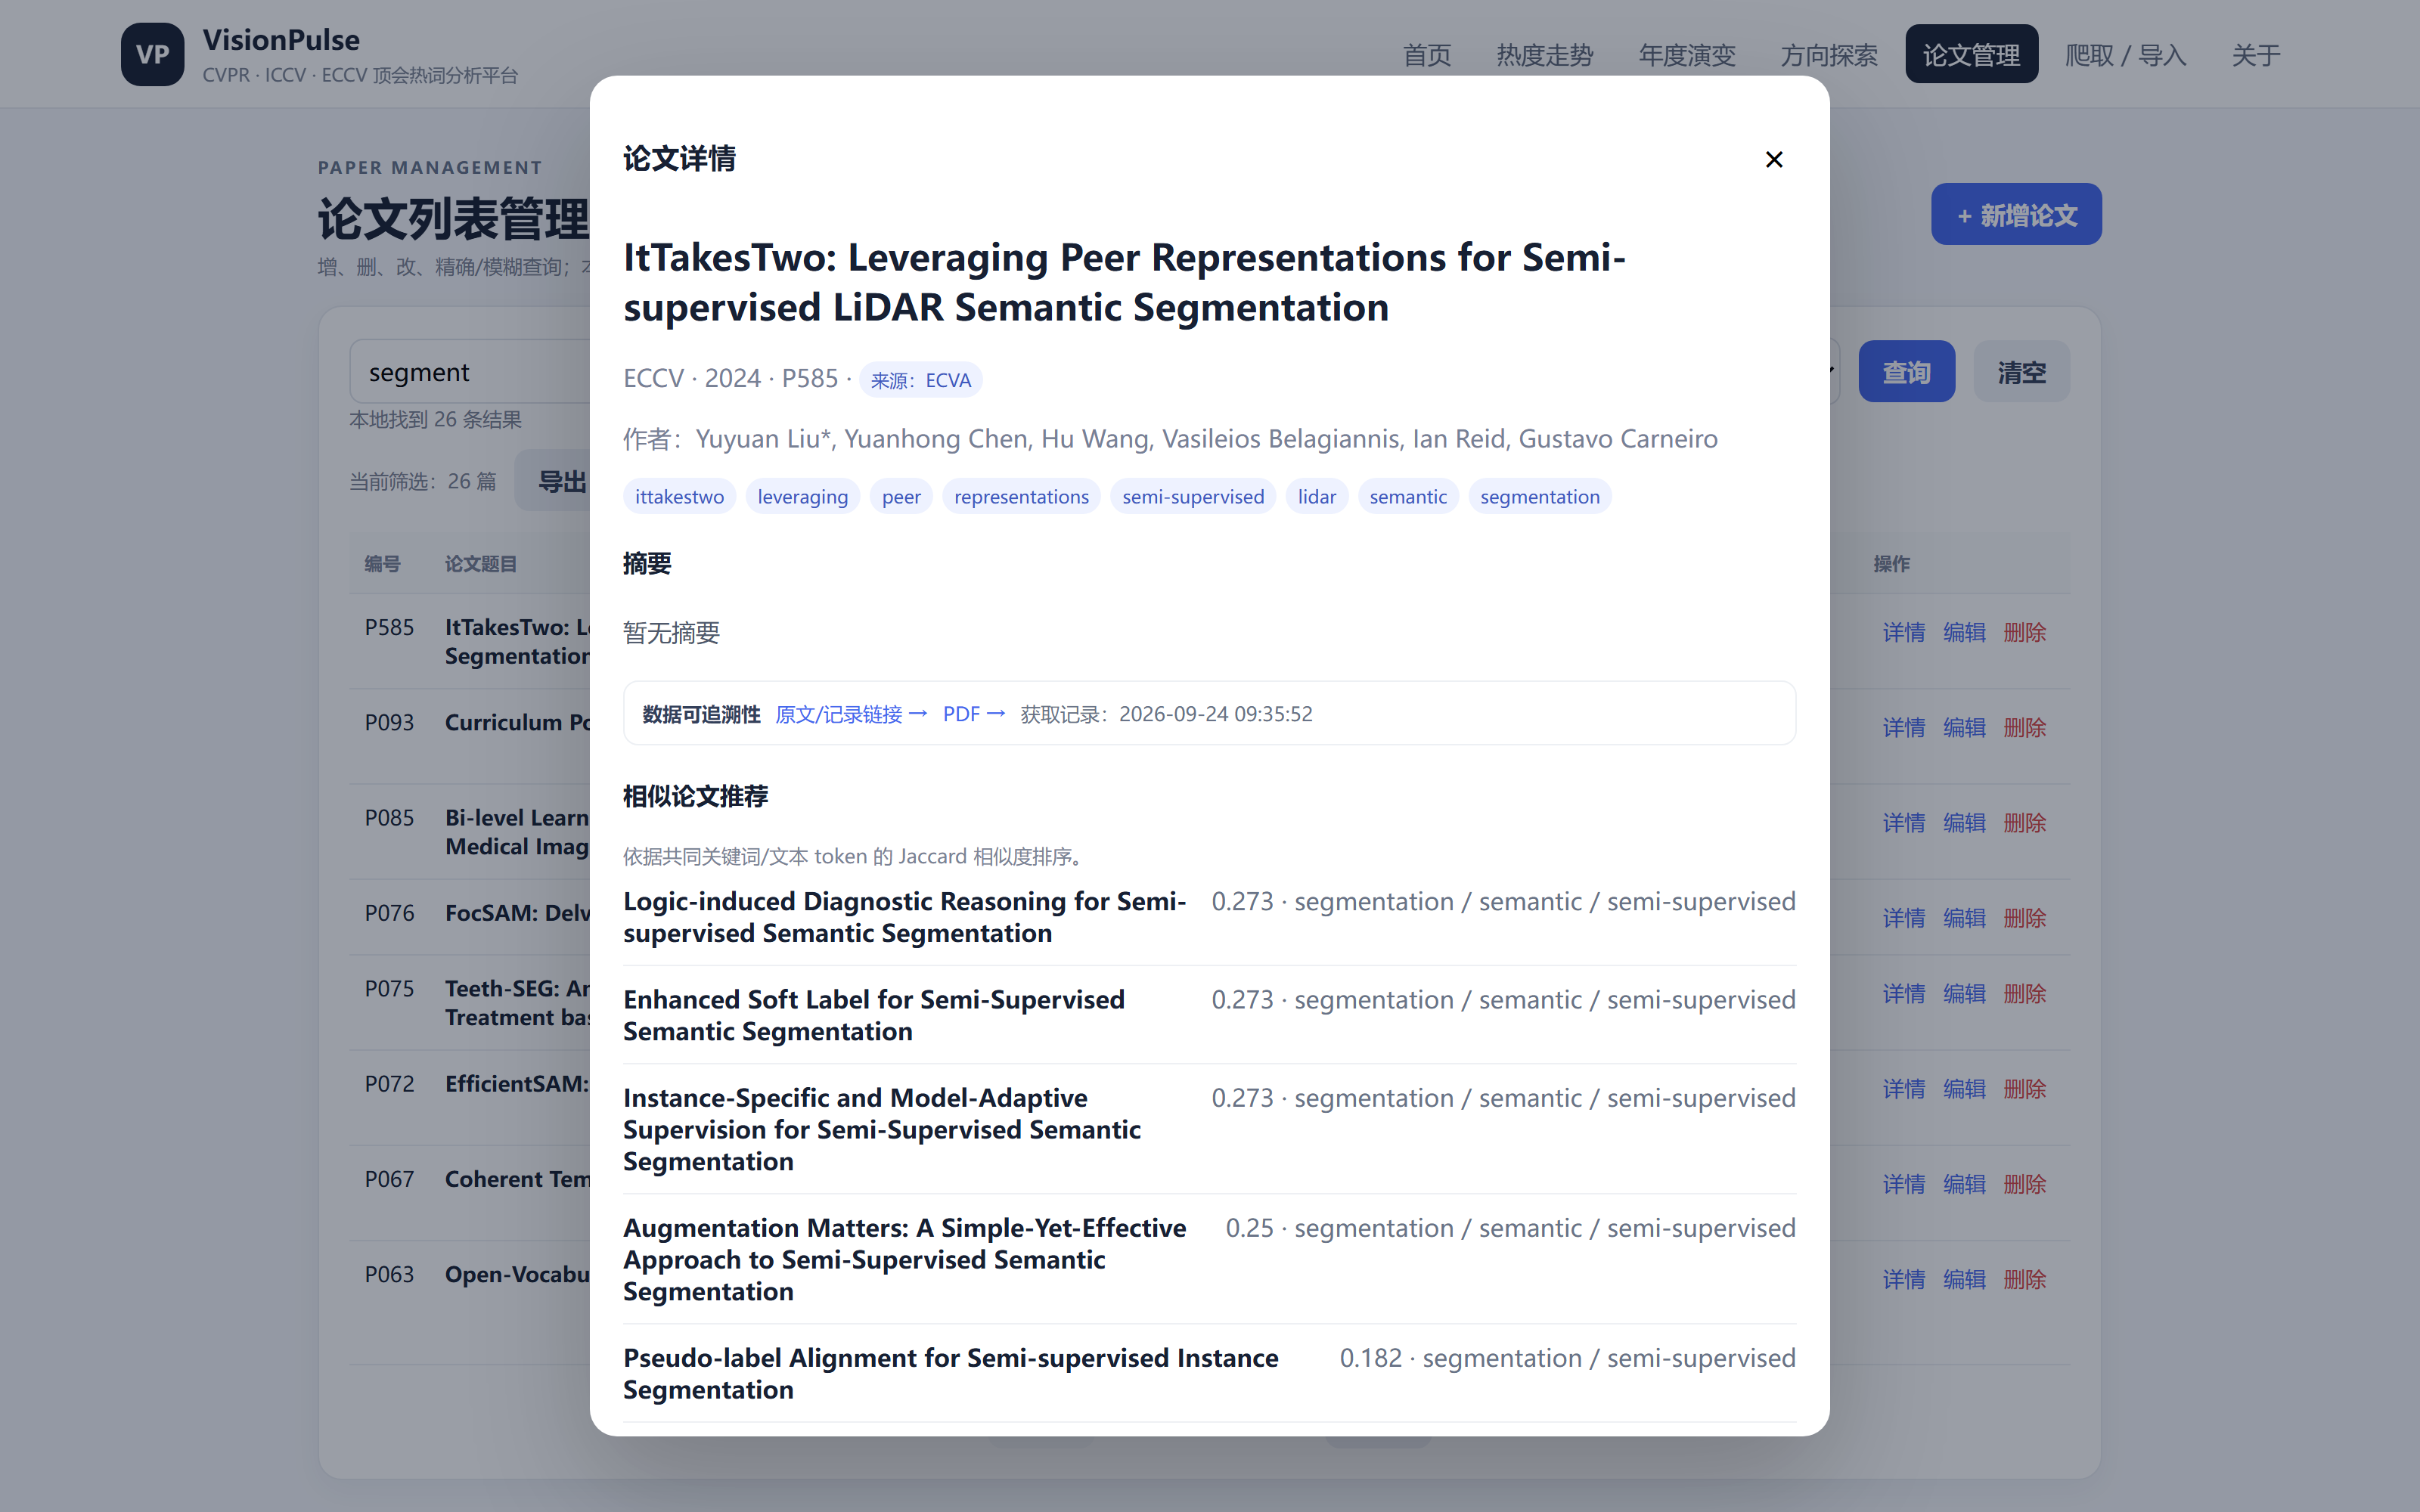
对应功能:功能 2 详情 + 数据可溯源
图 10|爬取 / 导入页:单篇题目检索与批量导入(单次上限 10 行)
图 11|关于页:数据来源、关键词统计口径、数据流与技术栈说明
对应功能:统计口径透明化
背景:基础功能已能跑(1.0.0,数据在 localStorage、只查 OpenAlex),但"数据从哪来"经不起追问——刷新换浏览器就丢数据、没有真实会议数据、没有来源溯源。
Prompt(摘要):请把作业要求拆成基础功能、原型页面、验收状态与博客材料,指出容易漏掉的硬性要求;并判断——要让五项功能变成"有真实数据来源"的系统,该补哪些数据源、用什么存储、后端要不要上?
AI 输出摘要:拆为五项基础功能 + NABCD + 专用原型 + 云部署 + 15 次提交 + dev 分支 + Release + PSP + 3 个协作案例;建议主数据源改为公开可获取的真实来源(CVF Open Access / ECVA / OpenAlex / DBLP),存储换 SQLite,后端上 FastAPI。
人工判断(关键取舍):
| AI 建议 | 我的决定 | 理由 |
|---|---|---|
| 用老师提供的数据集作主来源 | 不采纳 | 静态数据集无法体现"采集→清洗→入库"链路;公开源可追溯、可复算 |
| 多接几个数据源"显得强" | 裁剪到 4 个 | 其余要求账号或违反站点条款;数据源不是越多越好 |
| 上 PostgreSQL / Redis | 拒绝 | 与作业规模、云上运维成本不匹配,SQLite 足够 |
| 前端换成构建式框架 | 保留原生 + CDN | 单页零构建,云上只需 nginx 托管静态资源 |
| 扩展功能任意加 | 只加 3 个能解释的 | 必须能从现有字段算出,且能在页面讲清口径 |
| 直接用原型工具生成的代码 | 拒绝 | 作业明确"切勿用原型工具生成代码,一经发现直接 0 分" |
验证结果:实测缓存 320 条真实元数据(CVPR 180 / ICCV 80 / ECCV 60,2023–2024),/api/health 返回 paperCount=320。
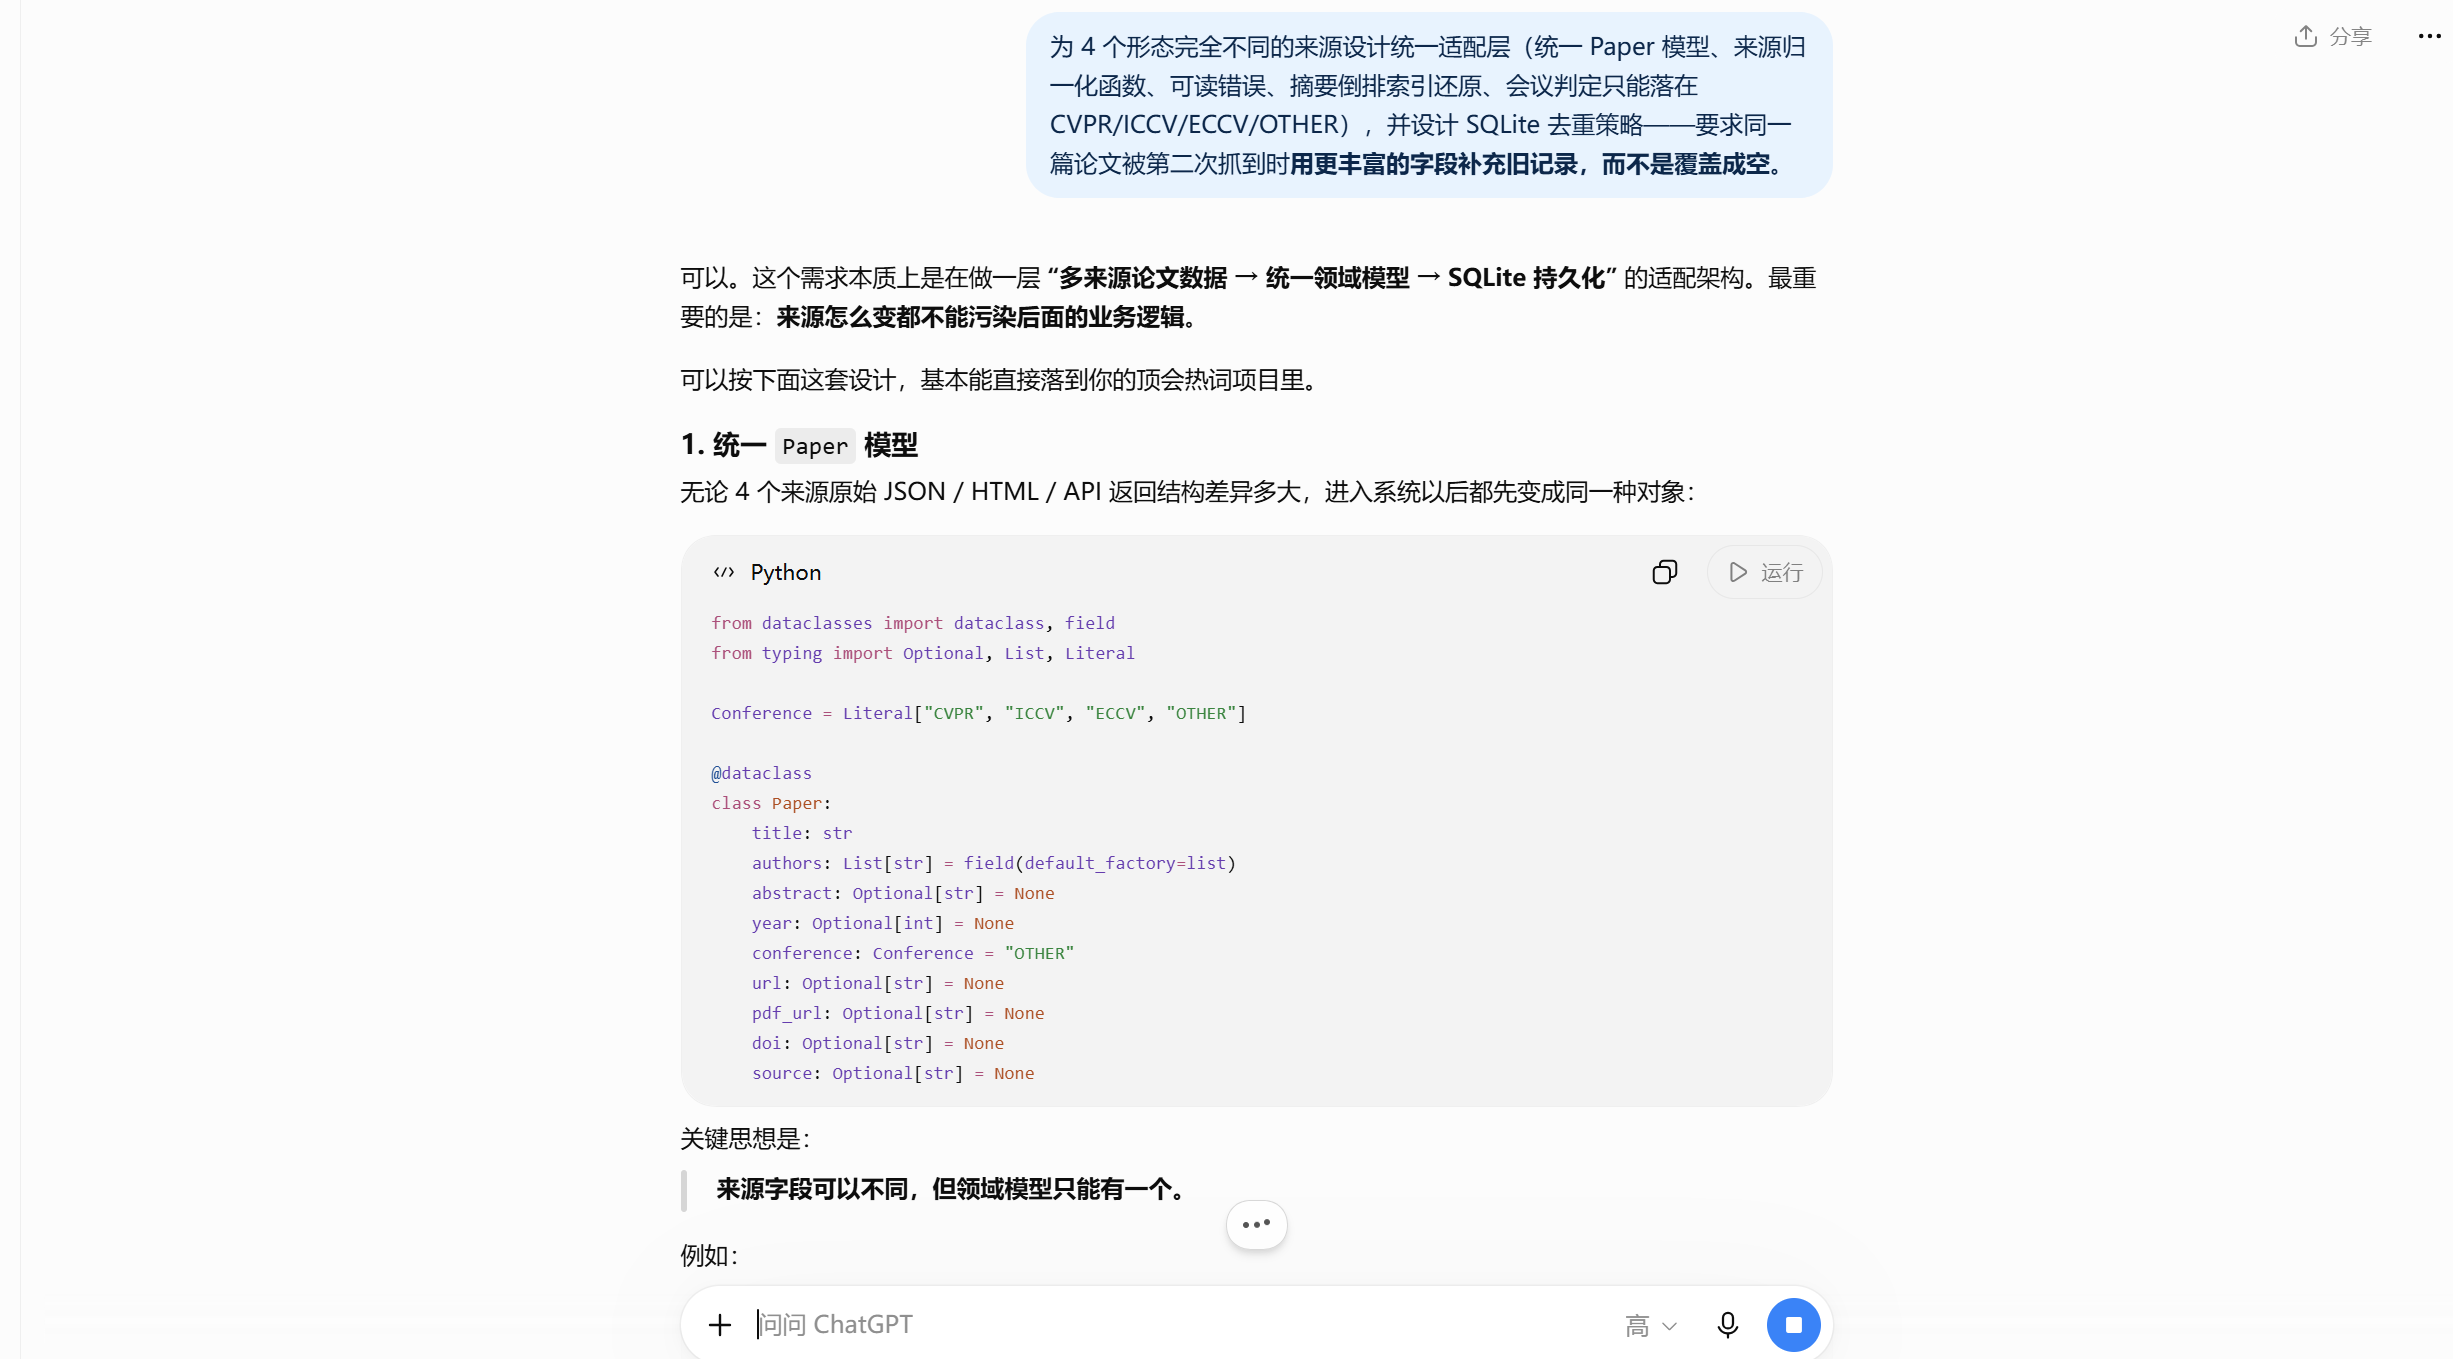
Prompt(摘要):为 4 个形态完全不同的来源设计统一适配层(统一 Paper 模型、来源归一化函数、可读错误、摘要倒排索引还原、会议判定只能落在 CVPR/ICCV/ECCV/OTHER),并设计 SQLite 去重策略——要求同一篇论文被第二次抓到时用更丰富的字段补充旧记录,而不是覆盖成空。
AI 输出摘要:给出 abstract_from_inverted() 位置排序还原摘要;infer_conference(source_name, title) 用来源名 + 标题双重判定;normalize_openalex() 合并 keywords/topics 与 landing_page/pdf 链接;正则解析 CVF/ECVA 列表页;异常统一包装为 SourceError;去重采用"标题规范化唯一键 + DOI 部分唯一索引 + ON CONFLICT DO UPDATE 逐字段择优"。
人工判断与修正:
conference 字段判定会议 → 人工改为**"来源名 + 标题"双重判定**,避免 CVF 列表页缺 venue 字段时全部落到 OTHER。UPDATE ... SET 直接覆盖 → 人工改为逐字段择优合并,否则第二次抓取的空字段会把第一次的有效字段冲掉。验证结果:后端测试 5 passed,其中与本案例直接相关——
test_upsert_deduplicates_titles:"A Vision Model" 与 "A Vision Model" 归一化后为同一条记录;同 DOI 不同标题亦为同一条记录test_source_normalization_and_fallback:infer_conference("unknown venue", "European Conference on Computer Vision paper") == "ECCV";摘要还原为 "models vision";monkeypatch 让 OpenAlex 抛 SourceError 后 /api/ingest/search 仍 200 且 source == "DBLP"python -m pytest -p no:cacheprovider backend/tests -q → 5 passed in 0.72s
现象:批量导入多行标题时,列表实际只新增 1~2 篇(重复标题被跳过),页面却提示"成功加入 5 篇"。
AI 定位结论:根因在函数没有返回值——saveRemote() 判断重名后 return(无返回值 = undefined),而批量循环里无条件 ok++,于是"跳过"对计数不可见:尝试次数被当成了成功次数。AI 同时指出:不应该在 batchImport 里再写一遍重名判断(会出现两处去重规则,后续易不一致)。
人工采纳与修改(最小改动):让 saveRemote 返回布尔值,并增加 silent 参数避免批量时每行弹一次 Toast;调用方只认返回值 if (rs[0] && saveRemote(rs[0], true)) ok++。
验证结果:同一标题导入 3 次 → 列表仅新增 1 篇、计数 = 1;5 行中 3 行重复 → 计数 = 2 且与列表新增一致;回归 npm run build 通过。
反思:这次修复的价值不在改动量(5 行),而在单一去重入口——去重规则只有一处,计数由它的返回值派生。任何"过滤/跳过"分支都必须显式返回结果,否则调用方的统计必然失真;这类 Bug 不会被类型系统发现,只能靠手工构造重复输入的用例暴露。
现象:数据库同步脚本在"上传后校验"这一步安全中止,报 SHA256 不一致——但打印出的两串摘要内容完全一致。
AI 定位结论:远端摘要由 Paramiko 以 bytes 返回(打印成 b'90fe…'),脚本却拿它和 hashlib 产生的 str 比较;Python 中 bytes != str 恒为真,所以内容一致也判不一致。校验机制本身按设计工作了(中止、未覆盖线上库),错的是喂给它的比对输入类型。
人工采纳与修正:① read() 内部统一解码为 str;② 新增 normalize_sha(),两侧统一成 64 位小写 hex 再比较,并校验长度与字符集(非法即报错中止);③ 顺带修掉同一 read() 被用于生成备份时间戳所导致的畸形备份文件名问题。
验证结果:修复后 py_compile exit=0、AST OK,并新增 9 个单元用例——bytes 输入(本次真凶)、str、带尾部文件名、大写规范化、空白换行 全部 PASS;长度不足、含非 hex、空字符串、非法 bytes 四个非法输入全部被正确拒绝。即"该通过的通过、该拒绝的拒绝"两边都验了,不是只测 happy path。
反思:一次"误报的不一致"比一次"漏报的一致"危险得多——如果当时为了赶进度直接跳过校验,就会失去唯一能防止"传错文件覆盖线上库"的保护。宁可误停,不可漏放。
现象:Codex / ChatGPT Work 突然报 unexpected status 502 Bad Gateway,请求地址指向本机 http://127.0.0.1:3456/v1/responses。
根因:本机另一个路由类工具(Claude Code Router)在启动时执行了 global profile takeover,把全局 ~/.codex/config.toml 改写——顶部注入 model_provider = "claude-code-router" 与 model catalog,底部注入 [model_providers.claude-code-router](base_url = http://127.0.0.1:3456/v1)。**User / Machine 两级环境变量完全没有 OPENAI_* / ANTHROPIC_***——只看环境变量会得出"配置没问题"的错误结论,真正的注入写在配置文件里。
修复与验证:备份后外科式移除注入的 provider/base_url/model catalog 段(不做整文件回滚,避免丢近期设置),并从源头停用针对该工具的 takeover profile(保留代理服务、密钥与其他工具配置不变)。验证:codex doctor 显示 default model provider: openai、config parse ok,codex exec 实测返回 PONG;启动注入源服务后确认未再次注入(耐久性验证)。
顺带的坑:用 PowerShell 把 JSON 直接传给 curl.exe/Invoke-WebRequest 会被 shell 改写,导致本地 API 返回 502 {"error":{"message":"Expected property name or '}' in JSON at position 1"}}——那是测试脚手架自己坏了,不是服务故障。正确做法是把 body 写进文件再用 --data-binary "@file"。这条经验后来直接救了上面的部署脚本(也是"先怀疑自己的输入,再怀疑系统")。
为什么单列:这属于工具链环境排查,不是项目功能开发,因此不占用三个核心案例的名额。
下面的代码均从仓库原文件按标注行号摘录,未改写、未用无意义代码凑行数。共约 334 行,覆盖 SQLite 去重合并、多源数据适配、关键词分析、FastAPI 路由、前端数据规范化、批量导入、Top 10、关键词图谱与热度走势动画。
共摘录约 330 行。所有代码块均从审计时仓库原文按标示行号切片,未改写;中文文字是审计解释,不属于源码。
backend/db.py:52-81设计思路:以规范化题名 title_key 作为主冲突键,并在写入前用 DOI 查回已有题名键,把“同 DOI、题名略有差异”的记录归并到同一行。冲突时不是整行覆盖,而是只让有信息量的新值替代旧值。
为什么这么写:不同学术来源的字段完整度不一致;OpenAlex 可能有摘要/DOI,CVF 可能有更直接的页面链接。逐字段择优可在多次采集时渐进补全,避免空串、OTHER 或 null 冲掉已有数据。
边界处理:空标题直接抛错;字符串关键词按中英文逗号/分号切分;关键词缺失时从英文题名生成最多 8 个候选;DOI 为空时不走 DOI 合并。代码未更新冲突行的 title 字段,且纯中文题名规范化可能为空,这是可见边界。
def upsert_paper(paper: dict[str, Any]) -> dict[str, Any]:
    title = str(paper.get("title", "")).strip()
    if not title: raise ValueError("论文题目不能为空")
    title_key = normalize_title(title); keywords = paper.get("keywords") or []
    if isinstance(keywords, str): keywords = [x.strip() for x in re.split(r"[,,;;]", keywords) if x.strip()]
    if not keywords:
        stopwords = {"with", "from", "using", "for", "and", "the", "via", "based", "learning", "image", "images", "visual"}
        keywords = list(dict.fromkeys(word.lower() for word in re.findall(r"[A-Za-z][A-Za-z-]{3,}", title) if word.lower() not in stopwords))[:8]
    with connection() as conn:
        doi = str(paper.get("doi", "")).strip()
        if doi:
            same_doi = conn.execute("SELECT title_key FROM papers WHERE doi = ?", (doi,)).fetchone()
            if same_doi:
                title_key = same_doi["title_key"]
        conn.execute("""
          INSERT INTO papers(title,title_key,authors,conference,year,abstract,keywords,doi,paper_url,pdf_url,source,updated_at)
          VALUES(?,?,?,?,?,?,?,?,?,?,?,CURRENT_TIMESTAMP)
          ON CONFLICT(title_key) DO UPDATE SET
            authors=CASE WHEN excluded.authors<>'' THEN excluded.authors ELSE papers.authors END,
            conference=CASE WHEN excluded.conference<>'OTHER' THEN excluded.conference ELSE papers.conference END,
            year=COALESCE(excluded.year,papers.year),
            abstract=CASE WHEN excluded.abstract<>'' THEN excluded.abstract ELSE papers.abstract END,
            keywords=CASE WHEN excluded.keywords<>'[]' THEN excluded.keywords ELSE papers.keywords END,
            doi=CASE WHEN excluded.doi<>'' THEN excluded.doi ELSE papers.doi END,
            paper_url=CASE WHEN excluded.paper_url<>'' THEN excluded.paper_url ELSE papers.paper_url END,
            pdf_url=CASE WHEN excluded.pdf_url<>'' THEN excluded.pdf_url ELSE papers.pdf_url END,
            source=CASE WHEN excluded.source<>'' THEN excluded.source ELSE papers.source END,
            updated_at=CURRENT_TIMESTAMP
        """, (title,title_key,paper.get("authors",""),paper.get("conference","OTHER"),paper.get("year"),paper.get("abstract",""),json.dumps(list(dict.fromkeys(keywords)),ensure_ascii=False),doi,paper.get("paper_url",paper.get("url","")),paper.get("pdf_url",""),paper.get("source","manual")))
        return row_to_dict(conn.execute("SELECT * FROM papers WHERE title_key=?", (title_key,)).fetchone())
backend/sources.py:5-33设计思路:fetch_json 集中设置 User-Agent、超时和异常包装;OpenAlex 的倒排摘要、来源会议名、作者、关键词/主题、链接统一整理成项目字段;DBLP 作为更轻量的书目 fallback。
为什么这么写:上层 main.py 只处理统一论文结构和 SourceError,无需感知每个来源的响应层级。
边界处理:空倒排索引返回空摘要;会议识别不到时为 OTHER;OpenAlex per-page 被钳制到 25;缺失数组和嵌套对象均使用空值回退。DBLP 返回的作者形态没有进一步统一,代码能否覆盖所有 DBLP 响应形态无法从静态代码证实。
class SourceError(RuntimeError): pass

def fetch_json(url,timeout=15):
    req=urllib.request.Request(url,headers={"User-Agent":"VisionPulse/1.0 academic-course-project"})
    try:
        with urllib.request.urlopen(req,timeout=timeout) as response: return json.loads(response.read().decode("utf-8"))
    except Exception as exc: raise SourceError(f"请求失败:{urllib.parse.urlparse(url).netloc},{exc}") from exc

def abstract_from_inverted(index):
    return " ".join(word for _,word in sorted((pos,word) for word,positions in (index or {}).items() for pos in positions))

def infer_conference(source_name,title=""):
    text=f"{source_name} {title}".lower()
    if "cvpr" in text or "computer vision and pattern recognition" in text: return "CVPR"
    if "iccv" in text or "international conference on computer vision" in text: return "ICCV"
    if "eccv" in text or "european conference on computer vision" in text: return "ECCV"
    return "OTHER"

def normalize_openalex(work):
    location=work.get("primary_location") or {}; source=location.get("source") or {}; keywords=[x.get("display_name") or x.get("keyword") for x in work.get("keywords") or []]; topics=[x.get("display_name") for x in work.get("topics") or []]
    return {"title":work.get("display_name") or work.get("title") or "Untitled","authors":", ".join((x.get("author") or {}).get("display_name","") for x in work.get("authorships") or [] if (x.get("author") or {}).get("display_name")),"conference":infer_conference(source.get("display_name", ""),work.get("display_name", "")),"year":work.get("publication_year"),"abstract":abstract_from_inverted(work.get("abstract_inverted_index")),"keywords":list(dict.fromkeys([x for x in keywords+topics if x]))[:12],"doi":work.get("doi") or "","paper_url":location.get("landing_page_url") or work.get("doi") or work.get("id", ""),"pdf_url":location.get("pdf_url") or "","source":"OpenAlex"}

def openalex_search(query,count=10):
    params=urllib.parse.urlencode({"search":query,"per-page":min(count,25),"select":"id,doi,display_name,publication_year,abstract_inverted_index,keywords,topics,primary_location,authorships"})
    return [normalize_openalex(x) for x in fetch_json(f"https://api.openalex.org/works?{params}").get("results",[])]

def dblp_search(query,count=5):
    params=urllib.parse.urlencode({"q":query,"h":count,"format":"json"}); hits=fetch_json(f"https://dblp.org/search/publ/api?{params}").get("result",{}).get("hits",{}).get("hit",[])
    return [{"title":x.get("info",{}).get("title",""),"year":x.get("info",{}).get("year"),"authors":x.get("info",{}).get("authors",{}).get("author",""),"conference":infer_conference(x.get("info",{}).get("venue","")),"paper_url":x.get("info",{}).get("ee",""),"source":"DBLP","keywords":[]} for x in hits]
backend/sources.py:35-43设计思路:CVPR/ICCV 会议页使用 CVF Open Access HTML 适配器,正则提取标题与详情链接,再补齐会议、年份、来源字段。
边界处理:网络错误包装为带会议年份的 SourceError;页面可访问但结构变化导致零匹配时也显式失败,不把空结果误当成功;按 limit 截断。
def cvf_list(conference,year,limit=100):
    url=f"https://openaccess.thecvf.com/{conference}{year}?day=all"; req=urllib.request.Request(url,headers={"User-Agent":"VisionPulse/1.0 academic-course-project"})
    try:
        with urllib.request.urlopen(req,timeout=25) as response: html=response.read().decode("utf-8","ignore")
    except Exception as exc: raise SourceError(f"CVF {conference}{year} 获取失败:{exc}") from exc
    pattern=re.compile(r'<dt class="ptitle">\s*<br\s*/?>\s*<a href="([^"]+)">\s*(.*?)\s*</a>',re.I|re.S); papers=[]
    for href,raw in pattern.findall(html)[:limit]:
        title=re.sub(r"<[^>]+>","",raw); papers.append({"title":re.sub(r"\s+"," ",title).strip(),"conference":conference,"year":year,"paper_url":urllib.parse.urljoin(url,href),"source":"CVF Open Access","keywords":[]})
    if not papers: raise SourceError(f"CVF {conference}{year} 页面可访问,但未匹配到论文条目")
backend/sources.py:46-59设计思路:ECCV 单独适配 ECVA 页面,先锁定年份注释分区,再解析题名、作者、详情和 PDF。
边界处理:年份分区不存在、网络失败、正则零命中分别给出清晰错误;相对 URL 用 urljoin 转为绝对地址。
def ecva_list(year,limit=100):
    url="https://www.ecva.net/papers.php"; req=urllib.request.Request(url,headers={"User-Agent":"VisionPulse/1.0 academic-course-project"})
    try:
        with urllib.request.urlopen(req,timeout=25) as response: html=response.read().decode("utf-8","ignore")
    except Exception as exc: raise SourceError(f"ECVA papers 页面获取失败:{exc}") from exc
    block=re.search(rf"<!--\s*ECCV\s+{year}\s*-->(.*?)(?=<!--\s*ECCV\s+\d+\s*-->|\Z)",html,re.I|re.S)
    if not block: raise SourceError(f"ECVA 页面未找到 ECCV {year} 分区")
    pattern=re.compile(r'<dt class="ptitle">\s*<br\s*>\s*<a href=([^ >]+)>\s*(.*?)\s*</a>\s*</dt>\s*<dd>\s*(.*?)\s*</dd>\s*<dd>.*?<a href=[\'\"]([^\'\"]+\.pdf)',re.I|re.S)
    papers=[]
    for href,raw_title,authors,pdf in pattern.findall(block.group(1))[:limit]:
        title=re.sub(r"\s+"," ",re.sub(r"<[^>]+>","",raw_title)).strip()
        papers.append({"title":title,"authors":re.sub(r"\s+"," ",authors).strip(),"conference":"ECCV","year":year,"paper_url":urllib.parse.urljoin(url,href),"pdf_url":urllib.parse.urljoin(url,pdf),"source":"ECVA","keywords":[]})
    if not papers: raise SourceError(f"ECVA ECCV {year} 页面可访问,但未匹配到论文条目")
    return papers
backend/analysis.py:19-42设计思路:单篇论文先把来源关键词和题名/摘要 token 合并、过滤停用词并去重;因此 keyword_stats 统计的是“包含该词的论文数”。方向分类使用可解释规则词表;图谱只在 Top 关键词集合内创建同篇共现边。
为什么这么写:单篇去重可避免一个词在摘要中重复出现导致论文被过度加权;显式规则便于课程展示与解释;Top N 和最多 100 条边限制前端图复杂度。
边界处理:无论文时方向占比分母至少为 1;图节点大小有上限增量;子串匹配可能产生语义误判,代码没有词形还原或短语边界模型。
def tokens(paper):
    values=[str(v).strip().lower() for v in (paper.get("keywords") or []) if str(v).strip()]
    words=re.findall(r"[a-z][a-z0-9-]{2,}",f"{paper.get('title','')} {paper.get('abstract','')}".lower())
    return list(dict.fromkeys(values+[w for w in words if w not in STOPWORDS]))

def keyword_stats(papers,limit=30):
    counts=Counter(); [counts.update(tokens(p)) for p in papers]
    return [{"name":n,"value":v} for n,v in counts.most_common(limit)]

def directions_for(paper):
    text=f"{paper.get('title','')} {paper.get('abstract','')} {' '.join(paper.get('keywords') or [])}".lower()
    return [name for name,rules in DIRECTIONS.items() if any(rule in text for rule in rules)]

def top_directions(papers,limit=10):
    counts=Counter(); [counts.update(directions_for(p)) for p in papers]; total=max(len(papers),1)
    return [{"name":n,"value":v,"share":round(v/total,4)} for n,v in counts.most_common(limit)]

def graph(papers,limit=30):
    stats=keyword_stats(papers,limit); names={x["name"] for x in stats}; edges=Counter()
    for p in papers:
        keys=sorted(set(tokens(p))&names)
        for i,left in enumerate(keys):
            for right in keys[i+1:]: edges[(left,right)]+=1
    return {"nodes":[{"name":x["name"],"value":x["value"],"symbolSize":20+min(x["value"],20)*2} for x in stats],"links":[{"source":a,"target":b,"value":v} for (a,b),v in edges.most_common(100)]}
backend/analysis.py:60-66设计思路:相似论文采用 token 集合的 Jaccard 相似度,并把共同 token 作为可解释理由返回。
边界处理:跳过目标自身;并集为空时分母至少为 1;只保留正相似度;理由最多 8 个,结果按分数降序截断。
def similar_papers(target,papers,limit=5):
    target_keys=set(tokens(target)); scored=[]
    for p in papers:
        if p.get("id")==target.get("id"): continue
        common=sorted(target_keys&set(tokens(p))); score=len(common)/max(len(target_keys|set(tokens(p))),1)
        if score: scored.append({**p,"similarity":round(score,3),"reasons":common[:8]})
    return sorted(scored,key=lambda x:x["similarity"],reverse=True)[:limit]
backend/main.py:19-37设计思路:Pydantic 模型统一约束写入字段;查询路由用 FastAPI Query 限制长度、枚举正则、年份和分页范围,再把过滤与分页下推到数据库层。
边界处理:会议和来源还做显式白名单验证并返回 400;总页数即使零记录也返回至少 1。模型中的 keywords:list[str]=[] 是字面默认值,Pydantic 如何复制该默认值依赖其模型实现。
class PaperInput(BaseModel):
    title:str=Field(min_length=1,max_length=500); authors:str=""; conference:str="OTHER"; year:int|None=Field(default=None,ge=1900,le=2100); abstract:str=""; keywords:list[str]=[]; doi:str=""; paper_url:str=""; pdf_url:str=""; source:str="manual"

    @model_validator(mode="after")
    def validate_values(self):
        values=self.model_dump()
        if values.get("conference") not in CONFERENCES: raise ValueError("conference 必须是 CVPR、ICCV、ECCV 或 OTHER")
        if values.get("source") not in SOURCES: raise ValueError("source 不是受支持的数据来源")
        return self

def all_papers(): return db.list_papers()
@app.get("/api/health")
def health(): return {"status":"ok","database":str(db.DB_PATH),"paperCount":len(all_papers())}
@app.get("/api/papers")
def papers(q: str = Query("", max_length=200), mode: str = Query("fuzzy", pattern="^(fuzzy|exact)$"), conference: str = Query(""), year: int|None = Query(None, ge=1900, le=2100), source: str = Query(""), page: int = Query(1, ge=1), page_size: int = Query(20, ge=1, le=100)):
    if conference and conference not in CONFERENCES: raise HTTPException(400,"conference 必须是 CVPR、ICCV、ECCV 或 OTHER")
    if source and source not in SOURCES: raise HTTPException(400,"source 不是受支持的数据来源")
    total=db.count_papers(q,mode,conference,year,source); rows=db.list_papers(q,mode,conference,year,source,page,page_size)
    return {"count":total,"page":page,"pageSize":page_size,"totalPages":max(1,(total+page_size-1)//page_size),"items":rows}
backend/main.py:57-70设计思路:创建和更新复用同一 upsert;删除与相似推荐均先处理不存在资源;相似度计算留在分析层。
边界处理:更新前检查路径 ID 是否存在,但写入时 upsert_paper 仍按正文题名/DOI 决定目标,路径 ID 本身没有传给 upsert;因此“路径 ID 对应行一定被更新”无法从代码证实。
@app.post("/api/papers")
def create_paper(paper:PaperInput): return db.upsert_paper(paper.model_dump())
@app.put("/api/papers/{paper_id}")
def update_paper(paper_id:int,paper:PaperInput):
    if not db.get_paper(paper_id): raise HTTPException(404,"论文不存在")
    return db.upsert_paper(paper.model_dump())
@app.delete("/api/papers/{paper_id}")
def delete_paper(paper_id:int):
    if not db.delete_paper(paper_id): raise HTTPException(404,"论文不存在")
    return {"deleted":True}
@app.get("/api/papers/{paper_id}/similar")
def similar(paper_id:int,limit:int=Query(5,ge=1,le=10)):
    target=db.get_paper(paper_id)
    if not target: raise HTTPException(404,"论文不存在")
backend/main.py:91-108设计思路:单篇搜索按 OpenAlex → DBLP 顺序 fallback;会议采集按会议路由到 CVF 或 ECVA。成功数据立即 upsert 到 SQLite,会议采集同时写 ingest job。
边界处理:搜索 query 最短 2、limit 1..10;会议白名单和 limit 1..300;来源错误累计后以 502 返回。会议 year 未设置范围约束。单篇搜索只在所有来源失败时记录失败 job,成功搜索没有创建 job。
@app.post("/api/ingest/search")
def ingest_search(query:str=Query(min_length=2),limit:int=Query(5,ge=1,le=10)):
    attempts=[]
    for name,fetch in (("OpenAlex",lambda:sources.openalex_search(query,limit)),("DBLP",lambda:sources.dblp_search(query,limit))):
        try:
            items=fetch(); stored=[db.upsert_paper(x) for x in items]; return {"source":name,"items":stored,"notice":f"已通过 {name} 获取并缓存 {len(stored)} 条"}
        except sources.SourceError as exc: attempts.append(str(exc))
    db.create_job("search",query,"OpenAlex → DBLP","failed",message=";".join(attempts)); raise HTTPException(502,"所有数据源均失败:"+";".join(attempts))
@app.post("/api/ingest/conference")
def ingest_conference(conference:str,year:int,limit:int=Query(100,ge=1,le=300)):
    if conference not in {"CVPR","ICCV","ECCV"}: raise HTTPException(400,"会议采集适配器支持 CVPR / ICCV / ECCV")
    try:
        source_name="ECVA" if conference=="ECCV" else "CVF Open Access"
        items=sources.ecva_list(year,limit) if conference=="ECCV" else sources.cvf_list(conference,year,limit)
        stored=[db.upsert_paper(x) for x in items]; job=db.create_job("conference",f"{conference}{year}",source_name,"success",len(items),len(stored)); return {"jobId":job,"source":source_name,"items":stored,"count":len(stored)}
    except sources.SourceError as exc:
        source_name="ECVA" if conference=="ECCV" else "CVF Open Access"
        job=db.create_job("conference",f"{conference}{year}",source_name,"failed",message=str(exc)); raise HTTPException(502,f"会议采集失败(job {job}):{exc}") from exc
app.js:281-319 — reconstructAbstract / normalizeOpenAlex设计思路:浏览器离线于后端时也能直接消费 OpenAlex;摘要按位置复原,关键词与 topics 合并去重,会议由来源名判断,最后统一成页面论文对象。
边界处理:空摘要索引返回空串;无 ID 时生成本地 ID;无年份回退 2026;无关键词回退 Computer Vision;链接按 DOI、落地页、OpenAlex ID 顺序回退。
    function reconstructAbstract(inv) {
      if (!inv) return '';
      const pairs=[];
      Object.entries(inv).forEach(([word,positions]) =>
        (positions||[]).forEach(pos=>pairs.push([pos,word]))
      );
      pairs.sort((a,b)=>a[0]-b[0]);
      return pairs.map(x=>x[1]).join(' ');
    }

    function normalizeOpenAlex(w) {
      const kws = [];
      (w.keywords || []).forEach(k => {
        const name = k.display_name || k.keyword;
        if (name && !kws.includes(name)) kws.push(name);
      });
      (w.topics || []).slice(0,5).forEach(t => {
        const name = t.display_name;
        if (name && !kws.includes(name)) kws.push(name);
      });
      const sourceName = w.primary_location?.source?.display_name || '';
      let conf='OTHER';
      if (/CVPR|Computer Vision and Pattern Recognition/i.test(sourceName)) conf='CVPR';
      else if (/ICCV|International Conference on Computer Vision/i.test(sourceName)) conf='ICCV';
      else if (/ECCV|European Conference on Computer Vision/i.test(sourceName)) conf='ECCV';
      return {
        id: String(w.id || '').split('/').pop() || nextId(),
        title: w.display_name || w.title || 'Untitled',
        conference: conf,
        year: w.publication_year || 2026,
        keywords: kws.length ? kws.slice(0,8) : ['Computer Vision'],
        abstract: reconstructAbstract(w.abstract_inverted_index),
        url: w.doi || w.primary_location?.landing_page_url || w.id || 'https://openalex.org/'
      };
    }

    async function openAlexSearch(query, count=5) {
      const params = new URLSearchParams({
        search: query,
app.js:342-373 — saveRemote / batchImport设计思路:远端结果先按题名大小写不敏感去重,再加入响应式数组并持久化;批量输入逐行串行请求 OpenAlex,以降低接口压力。
边界处理:空文件/空输入提前返回;批量单次最多处理 10 行;单条失败被捕获后继续;只有真正新增才累计成功数。直接前端保存只按题名去重,没有 DOI 去重。
    function saveRemote(r, silent = false) {
      const titleLower=r.title.toLowerCase();
      if (papers.value.some(p=>p.title.toLowerCase()===titleLower)) return false;
      papers.value.unshift({...r,id:nextId()});
      persist();
      if (!silent) notify('已加入论文列表');
      nextTick(renderDashboard);
      return true;
    }

    function readFile(e) {
      const file=e.target.files?.[0];
      if (!file) return;
      const reader=new FileReader();
      reader.onload=()=>{ batchText.value=String(reader.result||''); };
      reader.readAsText(file,'utf-8');
    }

    async function batchImport() {
      const lines=batchText.value.split(/\r?\n/).map(x=>x.trim()).filter(Boolean);
      if (!lines.length) return notify('请先输入或选择文件');
      batchLoading.value=true; let ok=0;
      for (let i=0;i<Math.min(lines.length,10);i++) {
        batchProgress.value=`${i+1}/${Math.min(lines.length,10)}`;
        try {
          const rs=await openAlexSearch(lines[i],1);
          if (rs[0] && saveRemote(rs[0], true)) ok++;
        } catch(e) {}
      }
      batchLoading.value=false; batchProgress.value='';
      batchMessage.value=`批量处理完成:成功加入 ${ok} 篇(为避免接口压力,单次最多处理10条)。`;
    }
app.js:384-428 — Top10 与关键词图谱设计思路:renderDashboard 复用 ECharts 实例,通过 setOption 更新;Top10 使用横向柱图,共现关系使用 force graph;节点点击写入 Vue 的 selectedKeyword,驱动相关论文计算属性。
边界处理:非 dashboard 页面或 ECharts 未加载时直接返回;DOM 不存在时跳过;图边做无向去重;点击监听先 off 再 on,避免重复绑定。
      if (page.value!=='dashboard' || typeof echarts==='undefined') return;
      const top = keywordStats.value.slice(0,10).reverse();
      const topEl=document.getElementById('topChart');
      if (topEl) {
        topChart = topChart || echarts.init(topEl);
        topChart.setOption({
          animationDuration:700,
          grid:{left:120,right:30,top:20,bottom:30},
          xAxis:{type:'value',minInterval:1,splitLine:{lineStyle:{color:'#eef1f5'}}},
          yAxis:{type:'category',data:top.map(x=>x.name),axisLabel:{color:'#596477'}},
          series:[{type:'bar',data:top.map(x=>x.value),barWidth:16,itemStyle:{borderRadius:[0,6,6,0]},label:{show:true,position:'right'}}],
          tooltip:{trigger:'axis'}
        });
      }

      const graphEl=document.getElementById('graphChart');
      if (graphEl) {
        graphChart = graphChart || echarts.init(graphEl);
        const nodes=keywordStats.value.slice(0,18).map((x,i)=>({
          name:x.name,value:x.value,symbolSize:28+x.value*6,
          category:i<5?0:(i<11?1:2)
        }));
        const names=new Set(nodes.map(n=>n.name));
        const links=[];
        papers.value.forEach(p=>{
          const ks=analysisKeywords(p).filter(k=>names.has(k));
          for(let i=0;i<ks.length;i++) for(let j=i+1;j<ks.length;j++) {
            if(!links.some(l=>(l.source===ks[i]&&l.target===ks[j])||(l.source===ks[j]&&l.target===ks[i])))
              links.push({source:ks[i],target:ks[j]});
          }
        });
        graphChart.setOption({
          tooltip:{},
          legend:[{data:['核心热点','重要方向','关联方向'],bottom:0}],
          series:[{type:'graph',layout:'force',roam:true,data:nodes,links,
            categories:[{name:'核心热点'},{name:'重要方向'},{name:'关联方向'}],
            label:{show:true,fontSize:11},force:{repulsion:260,edgeLength:[50,120]},
            lineStyle:{opacity:.35,curveness:.08}}]
        });
        graphChart.off('click');
        graphChart.on('click', params=>{
          if(params.dataType==='node'){ selectedKeyword.value=params.name; }
        });
      }
    }
app.js:459-512 — 热度走势动画设计思路:初始化或复用趋势图实例;每个年度用三组会议柱状序列展示,setInterval 每 1600 ms 切换年份,setOption(..., true) 做整组选项替换并触发动画。
边界处理:非趋势页、ECharts 缺失、容器缺失或实例未初始化时返回;重建定时器前总是 clearInterval;暂停状态不新建定时器;重播从首年开始。若快照年份数组为空,前置 getTrendSnapshot 会提供安全年份,因此取模分母不为零。
      if (page.value!=='trend' || typeof echarts==='undefined') return;
      const el=document.getElementById('trendChart');
      if(!el) return;
      trendChart = trendChart || echarts.init(el);
      const snapshot = getTrendSnapshot();
      trendIndex = Math.min(trendIndex, snapshot.years.length - 1);
      showTrendYear(snapshot.years[trendIndex], snapshot);
      startTrendTimer();
    }

    function showTrendYear(year, snapshot=getTrendSnapshot()) {
      if(!trendChart) return;
      const d=snapshot.data[year];
      trendChart.setOption({
        title:{
          text:`${year} 年热词热度对比`,
          subtext:'统计口径:当前论文列表中,“年份 × 顶会 × 关键词”的出现次数'
        },
        tooltip:{trigger:'axis'},
        legend:{data:['CVPR','ICCV','ECCV'],top:42},
        grid:{left:55,right:30,top:95,bottom:80},
        xAxis:{type:'category',data:snapshot.keywords,axisLabel:{rotate:18}},
        yAxis:{type:'value',minInterval:1,name:'论文数'},
        series:['CVPR','ICCV','ECCV'].map(name=>({
          name,
          type:'bar',
          data:d[name],
          barMaxWidth:34,
          animationDuration:900,
          animationEasing:'cubicOut'
        }))
      },true);
    }

    function startTrendTimer() {
      clearInterval(trendTimer);
      if(!trendPlaying.value) return;
      trendTimer=setInterval(()=>{
        const snapshot=getTrendSnapshot();
        trendIndex=(trendIndex+1)%snapshot.years.length;
        showTrendYear(snapshot.years[trendIndex], snapshot);
      },1600);
    }

    function toggleTrend() {
      trendPlaying.value=!trendPlaying.value;
      startTrendTimer();
    }
    function restartTrend() {
      const snapshot=getTrendSnapshot();
      trendIndex=0;
      trendPlaying.value=true;
      showTrendYear(snapshot.years[0], snapshot);
      startTrendTimer();
AI 参与了方案初稿、样板代码和调试建议;最终接口调用、数据结构、统计口径、边界处理、部署脚本与本文档事实性内容由本人审查、运行验证并确认。上面的代码片段均标出真实文件与行号,我能够解释其输入、输出、错误分支和已知边界,不提交未理解的 AI 产出。
状态只使用 PASS / PARTIAL / MISSING。PASS 必须有正文内或仓库内的真实证据;附件中存在但未进入博客正文的内容不计为 PASS。
统计:17 项 PASS,3 项 PARTIAL,3 项 MISSING。
| 维度 | 传统人人结对 | 人机结对(本次实践) |
|---|---|---|
| 反馈速度 | 受对方时间与状态限制,但即时而双向 | 几乎即时,但单向——AI 不会主动质疑我的前提 |
| 质疑设计 | 结对伙伴会实时挑战你的判断 | 必须由我主动扮演审查者,否则 AI 会顺着我的错误前提往下写 |
| 上下文 | 共享同一份现实(能一起看屏幕、一起跑命令) | AI 不知道本机状态、真实返回与外部平台权限,需要我把事实喂准 |
| 知识边界 | 两人知识互补 | AI 有幻觉与知识截止,且会自信地给出错误结论 |
| 代价 | 沟通等待成本 | 验证成本:AI 产出必须逐条运行验证才能用 |
| 产出速度 | 慢但稳 | 从空白到可运行原型极快,但质量取决于提问与验收质量 |
结论:人机结对把"写"的成本大幅降低,把"验证"的责任全部压回给开发者。所以本次我给自己定的规则是:任何数字都要跑命令;任何"AI 说没问题"都要自己复现一遍。
AI 会构建"看起来对"的东西,而验证是开发者的活。案例 B 里 AI 的 upsert 初稿用直接覆盖,功能测试也能过——只有当我构造"第二次抓到的记录字段更少"的场景时,才会发现旧数据被冲空。测试用例要覆盖失败与降级路径,而不是只覆盖成功路径。
"TCP 能连上"不等于"服务在跑"。排查 SSH 时我一度凭端口握手就宣布安全组已放行,后来发现云转发层会无差别接受 TCP——80/443 上根本没有服务也"握手成功"。结论必须建立在应用层证据(banner / HTTP 200)之上。 这是我这次最想记住的一条。
宁可误停,不可漏放。数据库同步脚本因 bytes/str 类型比较误判 SHA256 不一致而中止——那恰恰是保护机制正确工作的样子。如果我当时为了赶时间删掉校验,就会失去唯一能防止"传错文件覆盖线上库"的防线。
优势:拆解需求、列举方案与竞品视角、生成样板代码与适配层骨架、解释报错、写测试用例,效率远超手工。它能在我"知道要做什么但懒得展开"的地方迅速铺开细节。
局限(本次真实遇到):
我的判断:AI 显著提高了从空白到可运行版本的速度,但最终责任完全属于提交者。把需求、约束和验证标准说清楚,然后逐条验收——这是人机结对唯一有效的工作方式。
# 本地仓库统计
git -C <repo> rev-list --count main
git -C <repo> rev-list --no-merges --count main
git -C <repo> log --merges --oneline main
git -C <repo> for-each-ref --format="%(refname:short) %(objectname:short)"

# 远端一致性(独立 mirror clone + 匿名读)
git ls-remote --heads --tags <codearts-url>
git clone --mirror <codearts-url> /tmp/verify.git
git -C /tmp/verify.git rev-list --count main

# 数据库统计
python -c "import sqlite3; c=sqlite3.connect('data/visionpulse.sqlite3'); print(c.execute('select count(*) from papers').fetchone())"

# 后端测试与构建检查
python -m pytest -p no:cacheprovider backend/tests -q
npm run build

# 公网验证
curl -fsS http://119.3.251.115/api/health
ssh-keyscan -T 10 119.3.251.115


