


7,745
社区成员
 发帖
 与我相关
 我的任务

 分享
系列文章:https://blog.csdn.net/HuiMinHuang2001/article/details/166688132
把模型从训练服务器搬到设备端,第一件事不是「怎么跑」,而是「为什么必须换个硬件跑」。很多算法工程师第一次做边缘部署,直觉反应是「拿个树莓派把 PyTorch 模型跑起来不就行了」——结果要么跑不动,要么根本没法量产。根本原因在于:边缘侧和云端面对的约束,根本不是同一个问题。
云端推理的底层假设是「电随便用、散热随便堆、带宽随便给、延迟可以忍」。边缘设备(机器人本体、摄像头、网关、车载盒子)恰恰四个都没有。我们把边缘侧绕不开的约束总结成三道墙:功耗墙、延迟墙、带宽墙。这三道墙是后面所有架构选择的出发点,建议你每做一个边缘项目都拿来对照一遍。
数据中心可以堆电、吹空调,单卡几百瓦随便上;但一块边缘设备的供电和散热预算极其有限。一台巡检机器人本体可能只有几十瓦的总功耗预算,留给 AI 计算的往往不到十瓦;一个智能摄像头更是要靠 PoE(网线供电)的十几瓦撑起全部功能。
[推算] 同样跑一个 ResNet-50 级别的图像分类任务,通用 CPU 的能效比大约是 NPU 的 1/10 到 1/50。这里的「能效比」指每瓦能处理的帧数(FPS/W)。换句话说,用 CPU 硬算,要么电池半小时没电,要么芯片温度迅速撞到降频墙,算力直接腰斩。NPU 之所以省电,核心不是「算得快一点」,而是它用极低精度的整数运算 + 高度规整的矩阵阵列,把每次乘加的能耗压到 CPU 的零头。
定量直觉:假设某任务在 CPU 上吃满一个核、功耗 5W、跑 20 FPS;同样任务在 NPU 上可能只吃 0.5W、跑 200 FPS。前者能效 4 FPS/W,后者 400 FPS/W,差了两个数量级。这就是边缘必须上 NPU 的物理原因,不是营销话术。
| 推理硬件 | 典型功耗 | 典型算力(INT8) | 能效比直觉 |
|---|---|---|---|
| 通用 CPU(嵌入式) | 2–5W/核 | 极弱 | 低(参考基准 1×) |
| 通用 GPU(嵌入式) | 5–15W | 中 | 中(约 5–10×) |
| 边缘 NPU | 0.5–3W | 高 | 高(10–50×) |
上表为 [推算] 量级对比,用于建立直觉,不代表某一颗具体芯片。
把数据传云端推理,一来一回网络延迟通常 20–100ms 起步,加上排队、拥塞、弱网,端到端经常超过 200ms,而且完全不可控。对于「看一眼就要决策」的场景,这是致命的。
把「云端 vs 本地」的延迟预算摊开,差距一目了然 [推算]:
| 环节 | 云端方案延迟 | 本地 NPU 方案延迟 |
|---|---|---|
| 网络往返 | 20–100ms(弱网更高) | 0(不出本地) |
| 排队/拥塞 | 0–100ms+(不可控) | 0 |
| 推理计算 | 5–50ms | 5–30ms |
| 端到端典型值 | 50–250ms+(波动大) | 10–40ms(稳定) |
注意云端方案的下限都接近本地方案的上限,且波动完全不可控——对「看一眼就要决策」的场景,这种不可控比绝对值更致命。
这些场景要求端到端 10–30ms 级响应——这只能在本地 NPU 上闭环。把数据传云端,光网络往返就把预算吃光了。此外还有隐私与离线两个附带理由:很多工业、医疗、车载数据根本不允许出本地,断网也必须能工作。NPU 本地推理一次性解决了延迟、隐私、离线三个问题。
很多人以为瓶颈在「算」,其实边缘侧更常见的是「搬」。现代神经网络每层的输入/输出特征图动辄几 MB,模型权重几十到几百 MB。如果每张图都要过内存、再进 CPU 做预处理、再经总线喂给 NPU,总线带宽会先被吃满,NPU 饿着肚子干等。
一个直观例子:多路 4K 摄像头,每路每秒原始数据量是 3840×2160×3×30 ≈ 700 MB/s,四路就近 3 GB/s。这还没算预处理和模型读写。再看 SoC 层面:以高通 QCS8550 这类高端平台为例,其设计上就考虑了 8 路相机接口与 4K@240fps 硬件解码,正是为了把「搬运」尽可能硬件化——相机数据直接进 ISP/NPU,少走内存总线,避免数据在总线上空转。
冯·诺依曼瓶颈的具象化:算 1 次乘加只要 1 个周期,但把 1 个数据从 DRAM 搬到计算单元可能要几十到上百个周期。当模型「访存密集」时,瓶颈永远在搬而不是算。这也是为什么后面(第 8 讲视觉相机流水)要把数据搬运尽可能硬件化,也为什么选型时不能只看 TOPS。
高通的 SoC 不是一颗大 CPU,而是把多类计算单元封装在同一颗芯片里协同工作,这叫异构计算(Heterogeneous Computing)。理解这一点,是理解 NPU 的前提:NPU 不是来「取代」CPU/GPU 的,而是来「补位」的。
| 单元 | 擅长 | 不擅长 | 在 AI 推理中的角色 |
|---|---|---|---|
| CPU(Kryo) | 控制流、逻辑分支、调度 | 大规模并行矩阵 | 框架调度、前后处理、逻辑控制 |
| GPU(Adreno) | 图形渲染、通用并行 | 能效比不如 NPU | 渲染、部分预处理、可兜底 AI |
| DSP(Hexagon 通用) | 信号处理、矢量运算 | 专用 AI 张量 | 传感器融合、传统信号处理 |
| NPU(Hexagon 张量) | 神经网络张量运算 | 分支复杂的通用逻辑 | 神经网络前向推理主力 |
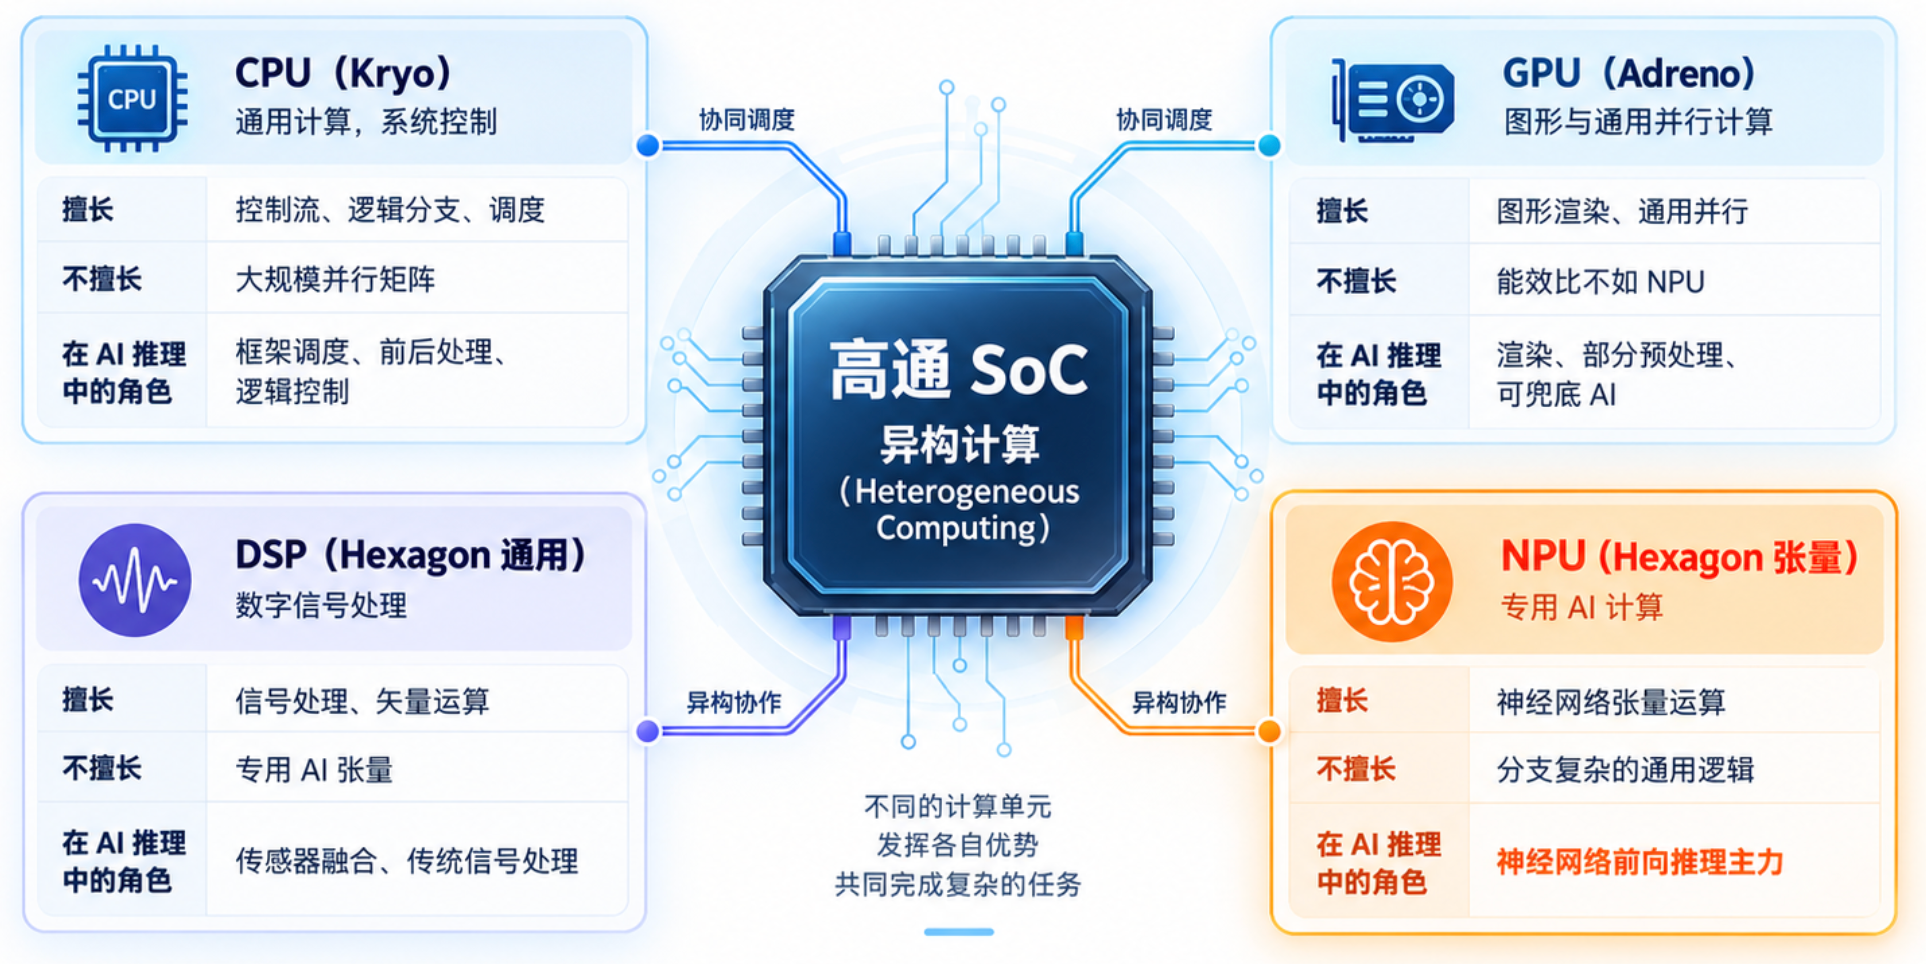
为什么不能只靠 CPU?因为神经网络的推理本质是海量「乘加(MAC,Multiply-Accumulate)」的并行堆叠。CPU 核心少、为分支预测和乱序执行优化了逻辑灵活性,并不适合这种规整的暴力并行。GPU 能做并行,但它是为图形设计的,能效比仍不如为 INT8 矩阵专门优化的 NPU。NPU 牺牲了通用性,换来了极致的 MAC 能效——这正是它在边缘侧存在的根本理由。
flowchart LR
    subgraph SoC[单颗 SoC 内部]
        CPU[CPU Kryo<br/>控制/调度]
        GPU[GPU Adreno<br/>渲染/预处理]
        DSP[DSP Hexagon<br/>信号处理]
        NPU[NPU Hexagon 张量<br/>神经网络推理]
    end
    CAM[相机/传感器] --> ISP[ISP 预处理]
    ISP --> NPU
    NPU --> CPU
    CPU --> ACT[执行/决策]
高通把 NPU 做进了 Hexagon 处理器里,称为融合 AI 加速器(fused AI-accelerator)。要理解这句话,得先知道 Hexagon 是什么:它是高通自研的 DSP(数字信号处理器)架构,多年来负责调制解调、音频、成像、传感器融合等底层信号处理。随着 AI 兴起,高通在 Hexagon 内部塞进了一个专门吃矩阵乘加的硬件模块,就是 HTP(Hexagon Tensor Processor,Hexagon 张量处理器)。
[官方] QCS6490 的 Hexagon 处理器即承担 NPU 角色;QCS8550 则是第 8 代 AI Engine,其 Hexagon 部分算力约 48 TOPS INT8。所谓「第 8 代 AI Engine」指的是高通把 CPU/GPU/Hexagon 协同做 AI 的整套架构迭代到第 8 代,NPU 算力相对前代有数倍提升。
心智模型:NPU 不是「更快的 CPU」,而是「只会做神经网络的专用车间」。它一次能并行成千上万个乘加,但你要提前把模型编译成它能懂的「工单」(这就是后面第 5–7 讲要讲的 QNN IR 与编译)。你不会、也不该用汇编去手写 NPU 程序——那是编译器的活。
HTP 高效的本质,是它内部采用了高度规整的乘加阵列(近似脉动阵列/Systolic 思想):数据像流水线一样流过阵列,每个周期都在做有效乘加,几乎没有空闲。相比之下,CPU 为了灵活性付出的控制开销,在这种规整负载下全是浪费。
参数表上的 TOPS 最容易误导人。所谓 TOPS(Tera Operations Per Second,每秒万亿次运算),在不同口径下能差出 2–4 倍。必须分清三种口径,否则选型就是盲人摸象。
graph TD
    A[TOPS 怎么读] --> B{精度?}
    B -->|INT8| C[快·省·可能掉精度]
    B -->|FP16| D[准·慢·费电]
    A --> E{稀疏?}
    E -->|Dense| F[实得基准·看这个]
    E -->|Sparse| G[理想峰值·别当真]
    A --> H[峰值 × 30%~70% = 实得]
这是全讲最容易被人忽略、却最关键的一点。NPU 算力再高,也要从内存搬权重和激活值。一旦带宽跟不上,HTP 就「饿着肚子干活」,TOPS 数字再漂亮也喂不饱。
一个简单的 [推算]:假设某 NPU 标称 48 TOPS,一次 INT8 乘加 = 2 次运算,所以理论需要 48 × 1e12 / 2 = 24 GB/s 的权重+数据吞吐才能喂饱——这还没算激活值和中间结果的多遍读写。如果板级内存带宽只有十几 GB/s,NPU 利用率直接打折。这也是为什么:
为了把「带宽卡 NPU」这件事算得更实,给一个 [推算] 的对照:假设某模型单帧权重 30 MB、特征图读写 4 遍,目标 30 FPS,那么每秒需要搬 30 MB × 5 × 30 ≈ 4.5 GB/s 的数据进出 NPU。如果 SoC 的内存带宽只有 17 GB/s,光这一个模型就吃掉了四分之一还多的带宽——更别说同Die里 GPU、CPU、ISP 也在抢总线。
| 模型规模 | 单帧权重 | 读写遍数 | 目标 FPS | 所需带宽(推算) |
|---|---|---|---|---|
| 轻量 CNN | 5 MB | 3 | 30 | ~0.45 GB/s |
| YOLOv8s 级 | 30 MB | 4 | 30 | ~4.5 GB/s |
| 大模型(端侧 LLM) | 数百 MB→量化后数十 MB | 多遍 | 10–20 | 数十 GB/s 级 |
结论:一个边缘 AI 项目卡脖子,十次里有六次不是 NPU 算力不够,而是带宽/数据搬运不够。选型时务必把「内存带宽、ISP 能力」和 TOPS 放在同等重要的位置。
传统的 CPU 编程是「写程序、编译成机器码、直接跑」。NPU 不是这样——你几乎从不直接用汇编写 NPU 指令,而是把训练好的模型交给一个编译器,由它把模型「翻译」成 NPU 能执行的工单。这套流程的入口,就是后面要讲的 QNN SDK(Qualcomm Neural Processing SDK)。
这种「模型即程序」的范式,正是边缘 AI 工程化的核心。后面的第 5–7 讲会把它拆成「转换 → 量化 → 编译 → 执行」四步逐一落地。这一讲你只要记住:NPU 不是给你写代码的,是给你「下工单」的。
「为什么偏偏是 NPU,而不是 GPU,或者干脆做一颗专用 ASIC?」这是每一个第一次接触边缘 AI 的人都会问的问题。把三者摆在同一个坐标系里,你会发现它们是「灵活性 ↔ 能效」这条轴上的不同落点,没有谁绝对更好,只有谁更匹配场景。
| 维度 | NPU(如 Hexagon HTP) | GPU(如 Adreno) | ASIC(全定制推理芯片) |
|---|---|---|---|
| 灵活性 | 中:可编程跑各类 DNN,但算子受编译器支持范围约束 | 高:通用并行,CUDA/OpenCL 生态成熟,几乎什么都能写 | 低:固化网络和精度,换模型即废 |
| 能效比 | 高(INT8 专用阵列,边缘最优档位之一) | 中(并行强但控制/访存开销大,边端偏费电) | 极高(为单一负载极致打磨,但仅限那一种) |
| 软件成熟度 | 中(QNN 等专用 SDK,需学习曲线) | 高(图形/通用生态十几年积累) | 低(通常是黑盒,厂商私有) |
| 典型用途 | 边缘 DNN 推理主力 | 渲染、训练、可兜底 AI、桌面级推理 | 超大规模、单一模型的极致降本 |
关键结论:NPU 是「可编程 + 高能效」的甜点区。ASIC 能效更高,但模型一旦变更就报废,不适合快速迭代的产品;GPU 灵活且生态成熟,但边端功耗和成本扛不住量产。对绝大多数「要迭代、要量产、要低功耗」的边缘 AI 产品,NPU 才是最优解。这也是为什么高通、苹果、华为不约而同都走了 NPU 这条路。
graph LR
    F[灵活性] ---|低| A[ASIC]
    F ---|中| N[NPU]
    F ---|高| G[GPU]
    E[能效] ---|极高| A
    E ---|高| N
    E ---|中| G
    A -.->|单模型极致降本| X
    N -.->|迭代+量产甜点| Y
    G -.->|灵活兜底| Z
高通的「AI Engine(AIE)」不是某颗芯片,而是把 CPU/GPU/Hexagon 协同做 AI 的整套架构代际。理解代际,才能理解为什么新平台的 NPU 算力会突然跳变几倍。
上面对代际的描述为 [推算] 的演进脉络梳理,用于建立「为什么新平台算力暴涨」的直觉,并非精确的性能对照表。具体每一代的算力数字,以高通官方产品页和规格书为准。
给工程师的提醒:代际差异不只是「数字变大」。新一代往往带来新的算子支持、新的量化能力、新的编译优化——你写的同一份模型,在新代 NPU 上可能直接多跑出 20%–40% 的利用率。选型时「买新不买旧」在边缘 AI 上是有真实收益的(当然要权衡成本)。
很多人疑惑:神经网络几十年前就有,为什么边缘 NPU 是这两年才成为刚需?答案不在某一颗芯片,而在三股推力同时到位:
这三股推力共同解释了「为什么现在做边缘 AI 必须懂 NPU」:十年前模型大、工具糙、需求弱,NPU 没用武之地;现在三样全齐,NPU 从「加分项」变成了「入场券」。
理解了 NPU「吃工单」的本质,就能看清后面整条工具链在干什么。下面把第 4–7 讲要落地的链路先串一遍(本讲只讲概念,不绑定任何板子):
flowchart LR
    A[训练好的模型<br/>PyTorch / ONNX] --> B[QNN 转换<br/>生成中间表示 IR]
    B --> C[量化 INT8<br/>校准数据集]
    C --> D[编译 context-binary<br/>HTP 后端]
    D --> E[板端 NPU 执行<br/>Hexagon HTP]
    E --> F[推理结果]
[实测] 真实延迟取决于模型结构、量化质量、批大小,请你在自己的模型上跑,不要直接引用厂商峰值。这部分会在第 3 讲起的上机实操中验证。
用一段 Python 把「峰值 × 利用率」的折算具象化,强化上面的坑点认知(纯推算,不涉及具体板子):
# [推算] 用峰值与典型利用率估算 NPU 有效算力
peak_tops = 48.0   # QCS8550 INT8 峰值 [官方]
util = 0.5         # 真实利用率通常在 30%~70%
eff = peak_tops * util
print(f"有效算力约 {eff:.1f} TOPS(峰值 {peak_tops} × 利用率 {util})")
# 输出:有效算力约 24.0 TOPS(峰值 48.0 × 利用率 0.5)
峰值 TOPS 是「所有乘加单元全速、且数据完美喂饱」的理想值。真实推理受内存带宽、算子覆盖、调度开销影响,实得往往只有峰值的 30%–70%。买算力、估延迟,一律按「峰值 × 1/3」打底。
看到「48 TOPS」要问清是 INT8 还是 FP16。INT8 快但可能掉精度,需要校准(第 6 讲);FP16 精度好但更慢更费。把两个数字相加、或拿 INT8 峰值去比 FP16 峰值,都是外行。
模型里只要有一个算子 NPU 不支持,整条链路就可能 fallback 到 CPU 执行,瞬间从毫秒级掉到百毫秒级,NPU 白买。第 5 讲会教你怎么查算子兼容性,提前规避。
开发板能跑峰值几分钟,但无风扇工业机连续满载会降频。[推算] 在 +50℃ 环境温度满载,NPU 有效算力可能只剩峰值的六到八成。产品化必须按「持续算力」估算,而非峰值。
INT8 量化能带来数倍能效提升,但权重/激活的动态范围被压缩,轻则精度掉点、重则模型直接失效。量化必须有校准集、必须做前后精度对比(第 6 讲)。把「量化一定能用」当默认假设,是新手最常见的坑。
同样一颗 SoC,工具链成熟度天差地别。有没有 QNN SDK 的完整支持、AI Hub 上有没有现成优化模型、有没有 Device Cloud 远程真机可调试——这些决定你两周还是两个月落地。选型时生态权重不亚于算力。
为了把抽象原理落回现实,下面用四个典型场景,说明 NPU 在不同边缘产品里到底解决什么问题、对 SoC 能力的要求有何不同。注意:以下只谈 SoC 能力维度,不绑定任何具体板子。
把上面四个场景对 SoC 能力的要求摊开成一张表,你就能直观看到「算力只是其中一格」:
| 场景 | 算力需求 | 相机/传感 | 延迟要求 | 温度/可靠性 | 典型 SoC 家族 |
|---|---|---|---|---|---|
| 智能摄像头/安防 | 中(~10 TOPS 级) | 单/少路 | 中 | 中(PoE 供电) | QCS6490 等主流 |
| 机器人感知节点 | 高(~48 TOPS 级) | 多路 + 雷达/IMU | 极严(几十 ms) | 中高(本体散热) | QCS8550 等旗舰 |
| 工业视觉检测 | 高(多路累加) | 12–16 路 CSI | 严(产线节拍) | 高(无风扇工业) | IQ-9075 / IQ-8275 |
| 车载边缘盒子 | 最高 | 多路环视 + 雷达 | 极严 | 最高(车规) | 高阶车规平台 |
你会发现:决定选哪颗 SoC 的,往往不是「多大算力」,而是「几路相机、多大带宽、多严的温度、多快的响应」。这正是下一讲(芯片矩阵与选型)要系统解决的。
Q1:我的模型一定要量化成 INT8 才能上 NPU 吗?
不一定。NPU 同时支持 INT8 与 FP16,但 INT8 能效最高。是否量化看精度容忍度(第 6 讲细讲)。多数边缘场景会优先 INT8。
Q2:GPU 和 NPU 能同时用吗?
可以。常见做法是 NPU 跑重模型,GPU 跑渲染/预处理,CPU 跑控制流——异构并行的精髓。三者各司其职。
Q3:边缘 NPU 和云端 GPU 推理怎么分工?
云端 GPU 适合大模型、批量、非实时;边缘 NPU 适合小模型、低延迟、本地闭环与离线。两者互补,不是替代。
Q4:没有开发板能先学吗?
能。高通提供 Device Cloud 远程真机(第 4 讲),以及 AI Hub 上已验证的模型,可以先在云端把流程跑通。
Q5:NPU 算力是不是越大越好?
不是。受带宽、功耗、散热、算子覆盖、软件生态共同约束。匹配场景、留有余量即可,盲目追峰值只会浪费预算。
Q6:为什么同一颗 SoC,不同模型跑出来利用率差很多?
因为模型的计算/访存特征不同。计算密集且规整的模型利用率高;访存密集、算子零散、含大量 NPU 不支持算子的模型,利用率低甚至大量 fallback 到 CPU。
Q7:量化后精度掉太多怎么办?
可尝试:增大校准集、改用逐通道量化(per-channel)、对敏感层保留 FP16、或做量化感知训练(QAT)。这些是后面第 6 讲的主题。
Q8:HTP 和常见的「NPU」名词是一回事吗?
在高通体系里,HTP 就是你平时说的那颗「NPU」的正式名字——它是 Hexagon 处理器内的张量加速硬件。不同厂商叫法不同(华为叫 Ascend、苹果叫 Neural Engine),本质都是专用神经网路加速单元。
Q9:量化(INT8)会让我的模型「变笨」吗?
看怎么量化。无校准的粗暴量化确实会掉精度;但用校准集做 PTQ(训练后量化)、或对敏感层保留 FP16、乃至做 QAT(量化感知训练),可以把精度损失压到 1% 以内,肉眼不可见。第 6 讲会手把手教,本节先建立「量化不是免费午餐,但也不是洪水猛兽」的认知。
Q10:我训练用的是 FP32,能直接丢给 NPU 吗?
不能直接跑出最佳效果。FP32 在边缘 NPU 上要么精度冗余浪费带宽、要么干脆不被某些算子支持。工程上几乎总是先转 ONNX,再量化成 INT8 或保留 FP16——这正是后面「转换 → 量化 → 编译」链路存在的意义。本讲记住流程即可,细节第 5–7 讲拆解。
Q11:NPU 利用率上不去,一般先查什么?
按优先级:① 是不是有大量算子 fallback 到 CPU(查 QNN 算子类覆盖);② 是不是模型访存密集、被带宽卡住(看特征图尺寸、batch);③ 是不是精度选错(FP16 比 INT8 慢且费电);④ 是不是持续满载降频(看温度与散热)。这四条覆盖了 90% 的「NPU 没跑满」现场。
Q12:学完本讲,我离「上板跑模型」还差几步?
差「工具链实操」四步:转换(第 5 讲)、量化(第 6 讲)、编译(第 7 讲)、上机部署(第 3–4 讲)。本讲给你的是「地图和路标」,真正踩油门是第 3 讲起。建议你带着本讲的术语表和坑点清单去读后面,会顺很多。
本讲建立了完整框架:边缘三道墙(功耗/延迟/带宽)→ 异构计算 → Hexagon NPU/HTP → TOPS 三种口径 → 带宽才是真瓶颈 → 模型到 NPU 的执行闭环。这些都是概念层,不绑定任何具体板子。
下一讲(第 02 讲) 我们上升到「高通边缘 NPU 芯片矩阵」:用 QCS8550 / QCS6490 / QCS5430、IQ-9075 / IQ-8275 这几颗 SoC 讲清算力定位、代际演进与选型方法——依然不碰具体开发板。把芯片层面搞清,第 3 讲起的上机才有底气。


