


7,845
社区成员
 发帖
 与我相关
 我的任务

 分享
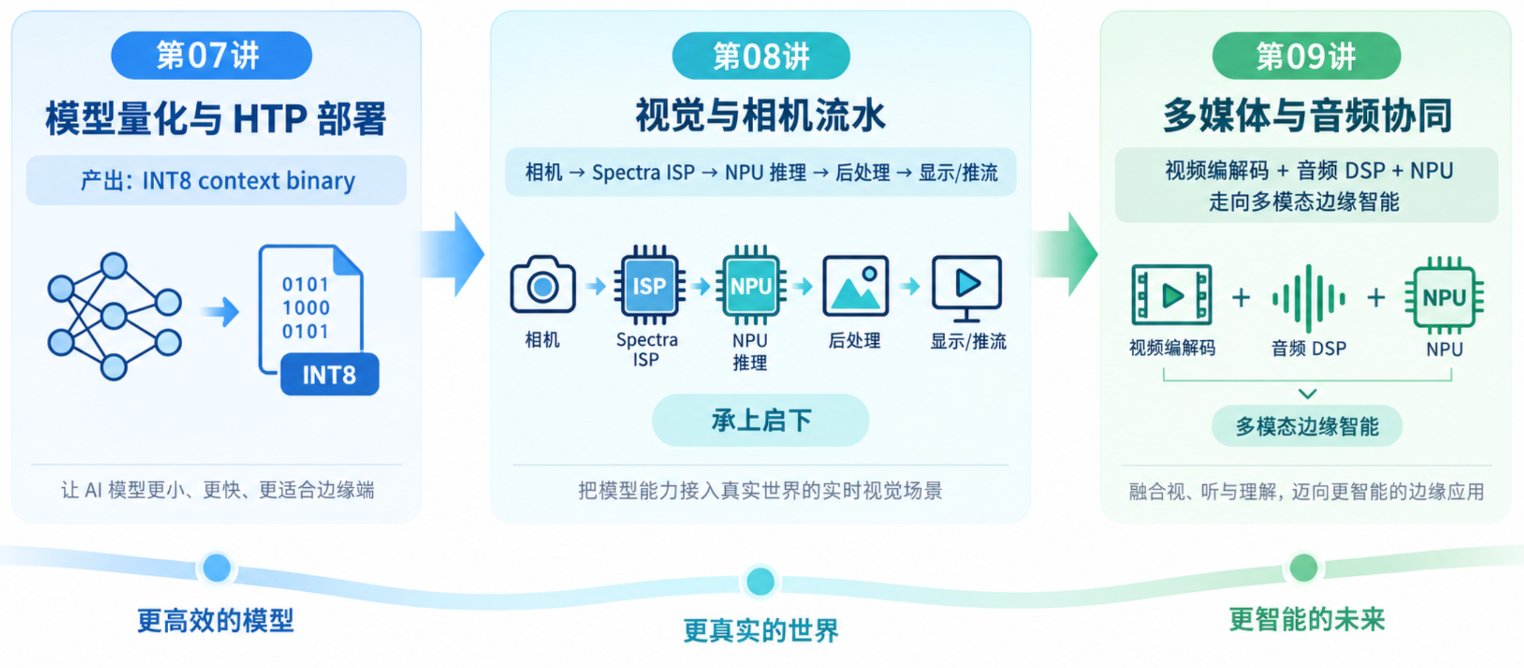
第 07 讲结束时,你手里已经能「喂一张图、出正确结果、报出延迟」。但真实世界不是一张图,而是连续不断的视频流。从「跑通一张图」到「接上相机连续看世界」,中间差的不是一行代码,而是一整套流水线工程——这正是本讲要补上的关键一跃。
很多人以为「模型在板子上跑通了,接个摄像头不过是循环调用」。现实会狠狠打脸:当你真的把相机接上,会发现「单帧 12ms 推理」在视频流里可能只能做到 15 FPS,或者画面卡顿、丢帧、延迟累积、内存吃光。原因不在于模型变慢了,而在于多了一个从未被纳入延迟预算的「相机侧」——采集、ISP、格式转换、搬运、显示,每一环都在分走你本就不宽裕的时间与带宽。
一句话定性:第 07 讲解决的是「NPU 能不能算对、算多快」;本讲解决的是「数据怎么稳定、低延迟、不断流地喂给 NPU,并把结果闭环回去」。前者是单点性能,后者是系统工程。
本讲实战主选仍是 犀牛派 A1(阿加犀,基于高通 QCS6490)。在视觉场景里,它背后那颗 SoC 的关键能力(均为 QCS6490 平台级事实 [官方],具体接口布局、MIPI 通道数、相机具体型号以阿加犀/高通官方资料为准):
| 维度 | 犀牛派 A1 背后的 QCS6490 平台能力 [官方] | 对本讲的意义 |
|---|---|---|
| NPU | Hexagon HTP,约 12 TOPS INT8(第 8 代 AI Engine) | 实时检测的算力底座(第 07 讲已验证) |
| ISP | Spectra 570L 级别,硬件图像预处理 | 相机原始数据在进 NPU 前先被「洗」干净、缩好、排好 |
| 相机接口 | MIPI CSI(多路接入能力,具体路数以官方规格书为准) | 本讲接 MIPI CSI 相机;多路场景见第 6 节 |
| 视频编解码 | 硬件 H.264 / H.265,4K@60fps 级别 [官方] | 推流/录像时由硬件编码器接管,省 CPU |
| 内存 | LPDDR5 级别,带宽直接决定能否被喂饱(呼应第 01 讲带宽墙) | 相机大数据量的隐形天花板 |
| 系统 | AidLux(预置 AI 运行环境) | 直接复用第 03/04/07 讲的环境与 context binary |
一个关键认知:Spectra ISP 不是「锦上添花」,而是视觉流水线的「第一道关」。没有它,相机吐出的原始 Bayer 数据(十比特甚至更多/像素)要全部由 CPU 做去马赛克、降噪、缩放、色彩空间转换——这一步就能把一颗 12 TOPS 的 NPU 活活饿死(因为数据根本来不及搬过去)。理解 ISP 在流水线里的位置,是理解本讲一切优化的总纲。
把本讲目标拆成三个可验收的子目标,避免「调着调着就迷失」:
新手最容易犯的错,是把流水线想成 for frame in camera: net.run(frame)。真实流水线是多阶段、可并行、有缓冲、会背压的:采集在跑、ISP 在跑、NPU 在跑、显示也在跑,它们像工厂的四条产线,靠缓冲区(buffer)衔接。哪一段慢了,缓冲区要么溢出(丢帧),要么被抽空(卡顿)。本讲后面会用「流水线并行」把这件事讲透——这是从「Demo 玩具」走向「产品」的分水岭。
动手接相机之前,先把整条 camera pipeline 在脑子里建一张图。这一节是全讲的概念地基。
ISP(Image Signal Processor,图像信号处理器)是 SoC 里专门处理相机原始数据的硬件模块。高通的 ISP 品牌叫 Spectra。以 QCS6490 平台为例,其 Spectra ISP(570L 级别 [官方])在相机数据和 NPU 之间承担了几乎全部「脏活累活」:
工程价值:上面这些操作全部由 Spectra 硬件完成,不占用 CPU、不占用 NPU。这正是「为什么边缘视觉必须让 ISP 先干活」——把计算密集且规整的图像预处理硬化到 ISP,NPU 才能专心做它最擅长的神经网络推理。
把整条链路画成一张图,本讲所有讨论都围绕它展开(节点越多,越要记住「每一跳都有延迟、都有带宽」):
flowchart LR
    S[Sensor 原始 Bayer 数据] --> CSI[MIPI CSI 接入]
    CSI --> ISP[Spectra ISP 硬件预处理<br/>去马赛克/降噪/缩放/格式转换]
    ISP --> PRE[NPU 输入张量<br/>INT8 量化值]
    PRE --> NPU[Hexagon HTP 推理<br/>YOLO INT8 context binary]
    NPU --> POST[后处理<br/>NMS / 解码检测框]
    POST --> DISP[显示 / 推流<br/>闭环输出]
    ISP -.->|硬件零拷贝/共享内存| NPU
    POST -.->|检测结果回灌| DISP
这张图最该记住的两条虚线:ISP 到 NPU 尽量走硬件零拷贝(少一次 CPU memcpy,就少一次带宽与延迟开销);后处理结果直接回灌显示(避免中间落盘再读)。这两点决定流水线「顺不顺」。
相机传感器(Sensor)通过 MIPI CSI(Camera Serial Interface) 总线把原始数据送进 SoC。MIPI CSI 是移动/嵌入式相机事实标准的物理与链路层,特点是非常高的串行带宽、低引脚数。QCS6490 平台支持多路 MIPI CSI 接入(具体通道数与并发路数以阿加犀/高通官方资料为准),这是它做多路视觉的硬件前提。
数据口径:一个 1080p(1920×1080)RGB 相机,若原始 Bayer 按 10-bit/pixel 计,单帧约 1920×1080×1.25 ≈ 2.6 MB;30 FPS 下原始数据率约 78 MB/s。这还只是「进入 SoC 之前的线速」,后面 ISP 处理后若转成 RGB 三通道,数据量还会再涨。把这股数据流稳定收进来,本身就是第一道工程门槛。
数据进 SoC 后,第一站是 Spectra ISP。它把上一节的去马赛克/降噪/白平衡/缩放/格式转换一次性做完,输出 NPU 能直接吃的张量。这里有两个工程要点:
经过 ISP 的数据,已经是规整的、量化好的输入张量。这一棒就是第 07 讲验证过的:qnn-net-run / 自建进程加载 INT8 context binary,在 Hexagon HTP 上执行 YOLO 推理,拿到输出张量(边界框坐标、类别置信度)。本讲不再重复编译细节,只强调一点——流水线下 NPU 的输入来源从「本地文件」变成了「ISP 实时帧」,喂数据的方式要从「读文件」改成「从共享内存/零拷贝 buffer 取帧」。
NPU 输出的是「一堆原始预测」:成百上千个候选框 + 各类别分数。真正给人看的检测框,要经过 后处理:
后处理通常跑在 CPU(或 GPU 协助),是延迟预算里不可忽略的一段。第 4 节的延迟拆解会把它单列出来——很多人只盯着 NPU 的 12ms,却忘了 NMS 在 CPU 上可能也吃 2–5ms。
最后一步是「让人/系统看到结果」:
闭环的意义在于:相机看到的每一帧,都在几毫秒内变成了「可决策的信息」,这正是边缘 AI 相对「云端传图再等结果」的本质优势(呼应第 01 讲延迟墙)。
单路只是起点。QCS6490 平台支持多路 MIPI CSI 接入(具体并发路数与分辨率组合以官方规格书为准),这让它胜任双目、环视、多视角质检等场景。多路带来的不是「NPU 算力线性够不够」一个问题,而是带宽、调度、同步三个新问题——第 6 节专门展开。
这是本讲最重要的性能纪律,单独点题:
memcpy。每多一次拷贝,就多一份带宽占用和延迟;把 2.4–2.9 合起来一句话:边缘视觉流水线的第一性原理,是「让数据在硬件通路里 flowing,而不是在 CPU 里 bouncing」。这也是第 01 讲带宽墙在视觉场景的具象解法。
第 01 讲提出的「带宽墙」在本讲变得无比具体:相机每秒几百 MB 的原始数据,如果不能高效进 NPU,NPU 算力再高也只是摆设。
第 01 讲说过:算 1 次乘加只要 1 个周期,但把 1 个数据从 DRAM 搬到计算单元可能要几十到上百个周期。在视觉流水线里,这个矛盾被放大成:传感器每秒产生几百 MB 数据,这些数据要过 ISP、过内存、进 NPU、出 NPU、再进后处理、再上屏——任何一段通路窄了,整条流水线就堵。
一个直观对照 [推算]:QCS6490 的 NPU 峰值约 12 TOPS INT8,把它喂饱大约需要十几 GB/s 量级的权重+激活吞吐(第 01 讲 2.4 推过类似账);而一路 4K 相机原始数据就近 700 MB/s,四路就接近 3 GB/s——这还没算 ISP 中间结果与 NPU 读写。可见带宽预算在视觉场景里极其紧张,必须靠「硬件化搬运 + 零拷贝」去省。
先量化「相机到底产生多少数据」,这是所有预算的起点:
# [推算] 单路相机原始带宽估算(纯标准库,建立直觉)
def cam_bandwidth(width, height, fps, bpp=1.25):
    # bpp: bytes per pixel。原始 Bayer 10-bit 约 1.25 字节/像素;RGB 则约 3 字节
    return width * height * bpp * fps / (1024 * 1024)  # MB/s

resolutions = {"720p": (1280, 720), "1080p": (1920, 1080), "4K": (3840, 2160)}
for name, (w, h) in resolutions.items():
    for fps in (30, 60):
        # 原始 Bayer(bpp=1.25)
        raw = cam_bandwidth(w, h, fps, 1.25)
        # 转成 RGB 三通道后(bpp=3)
        rgb = cam_bandwidth(w, h, fps, 3.0)
        print(f"{name}@{fps}fps  原始≈{raw:6.1f} MB/s  RGB≈{rgb:6.1f} MB/s")
# 输出示例(推算): 1080p@30fps 原始≈78.4 MB/s  RGB≈188.1 MB/s
[推算] 上表为量级估算。真实线速还受像素位深、打包方式、消隐期影响;具体相机请以传感器数据手册为准。但「1080p 级单路几十到近 200 MB/s」的量级直觉是成立的,用它做预算足够。
把单路乘以路数,立刻看到瓶颈的影子:
# [推算] 多路相机总带宽叠加(纯标准库)
def total_bw(cams):
    s = 0.0
    for (name, w, h, fps, bpp) in cams:
        s += cam_bandwidth(w, h, fps, bpp)
    return s

# 例:4 路 1080p@30fps 原始 Bayer
quad = [("cam%d" % i, 1920, 1080, 30, 1.25) for i in range(4)]
print(f"4 路 1080p@30fps 总原始带宽 ≈ {total_bw(quad):.1f} MB/s  "
      f"≈ {total_bw(quad)/1024:.2f} GB/s [推算]")
# 输出示例(推算): ≈ 313.5 MB/s ≈ 0.31 GB/s;若转 RGB 则约 0.74 GB/s
看到 0.3–0.7 GB/s 这个量级,再回头想 NPU 要十几 GB/s 的吞吐——相机「进」的数据相对 NPU「算」的数据是小头,但它是「必须实时进来、且不能丢」的硬约束。一旦 MIPI 带宽或内存总线被其他任务挤占,相机帧就会丢、会迟、会乱序,流水线直接崩。所以视觉流水线的带宽管理,优先级往往高于「再抠 2ms NPU 延迟」。
ISP 的妙处不只是「算得快」,更是「算在正确的位置」:
640×640×3 ≈ 1.2 MB/帧),相比接收全分辨率再缩,省了几十倍数据量;把这三招合起来,原本「每帧几百 MB 在总线上乱飞」的灾难,被收敛成「NPU 只吃精简后的小图、结果只传结构化信息或低码率视频」的清爽格局。这正是对第 01 讲带宽墙的工程回答。
这一节是可运行的核心。三段 Python 纯标准库即可运行(不依赖 numpy),帮你把「实时到底行不行」算成数字,而不是靠感觉。所有数字标 [推算],仅用于建立量级;真实值请用第 07 讲的 qnn-profile 在你的模型上实测后代入。
一条视频帧从「被拍到」到「框画出来」,由五段串行延迟拼成(理想无背压时取和,有并行时取关键路径)。我们先建一个可解释的模型。
(见 3.2,已给出 cam_bandwidth 函数,可直接复用。)
# [推算] 端到端延迟拆解:采集 + ISP + NPU + 后处理 + 显示(纯标准库)
stages = {
    "采集(曝光+读出)":        8.0,   # ms [推算] 受快门/帧周期约束,30fps 时单帧周期~33ms
    "ISP 硬件预处理":          3.0,   # ms [推算] Spectra 硬件完成,远低于 CPU 软处理
    "NPU 推理(YOLO INT8)":    12.0,   # ms [推算] 承接第07讲 HTP ~12ms 基准
    "后处理(NMS/解码框)":      2.5,   # ms [推算] 多在 CPU,框多时上升
    "显示/上屏(含vsync等待)":  5.0,   # ms [推算] 受屏幕刷新与缓冲影响
}
total = sum(stages.values())
print("端到端延迟拆解(推算):")
for k, v in stages.items():
    print(f"  {k:<24}: {v:5.1f} ms  占 {v/total*100:4.0f}%")
print(f"  合计 ≈ {total:.1f} ms  -> 理论吞吐 ≈ {1000/total:.1f} FPS")

# 敏感性:NPU 若更快(如升 QCS8550),端到端提升多少?
for npu_ms, label in [(12.0, "QCS6490 ~12 TOPS"), (4.0, "QCS8550 估算更快")]:
    t = total - stages["NPU 推理(YOLO INT8)"] + npu_ms
    print(f"  [{label}] 端到端≈{t:.1f} ms -> {1000/t:.1f} FPS")
# 输出示例(推算): 合计≈30.5ms -> 32.8 FPS;NPU 更快时仍受采集/显示下限约束
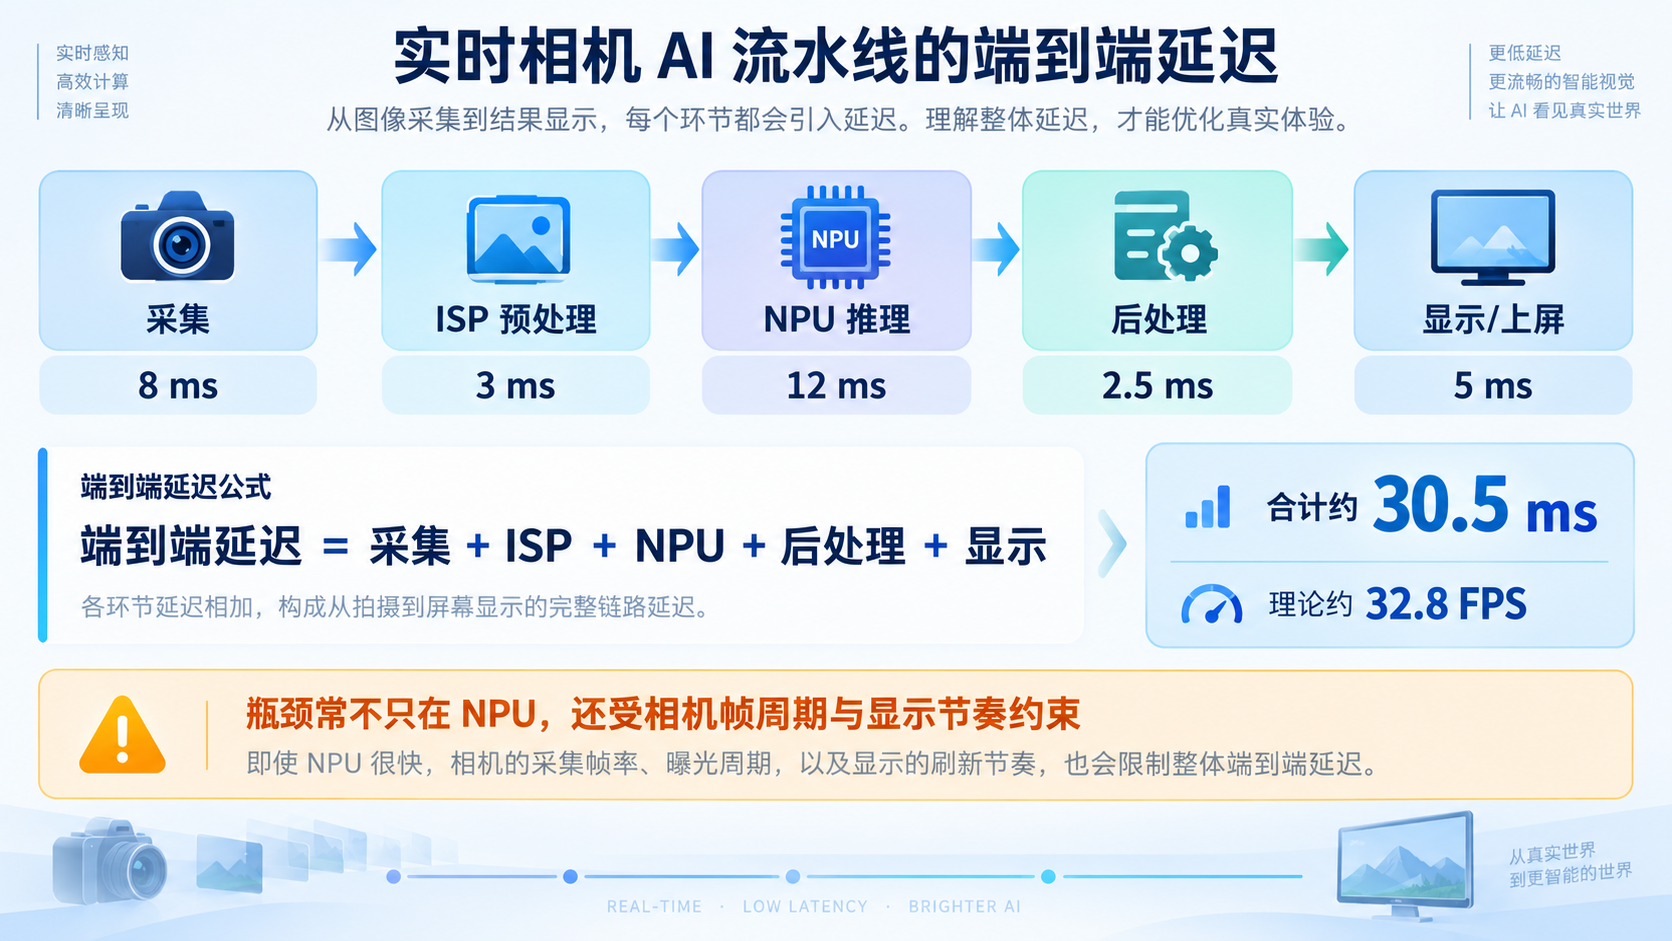
关键结论([推算]):即使 NPU 推理从 12ms 砍到 4ms,端到端也只从 ~30.5ms 降到 ~22.5ms——因为采集周期(33ms@30fps)与显示 vsync 构成了硬下限。这揭示一个反直觉事实:视觉实时流水线的瓶颈,常常不在 NPU,而在相机帧周期与显示节奏。盲目升级 NPU 算力,未必换来等比例帧率提升——先确认你是不是已经被 30fps 的帧周期「锁死」了。
NPU 算力占用随分辨率(单帧 MACs)与帧率线性变化。下面把第 07 讲 7.3 的利用率公式,延伸到「视频流」语境:
# [推算] 不同分辨率/帧率下 NPU 算力占用与利用率(纯标准库)
PEAK_TOPS = 12.0   # QCS6490 INT8 峰值 [官方]
# 各输入分辨率下单帧 MACs(十亿),YOLO 类检测 [推算] 量级
MACS = {"320x320": 4.0, "640x640": 16.0, "1280x720": 30.0}
print(f"{'分辨率':<10}{'帧率':<6}{'所需TOPS':<10}{'HTP利用率'}")
for res, m in MACS.items():
    for fps in (30, 60):
        need = m * 2 * fps / 1000.0        # TOPS = MAC(×2 op) × fps
        util = need / PEAK_TOPS * 100
        print(f"{res:<10}{fps:<6}{need:<10.2f}{util:.0f}%")
# 输出示例(推算): 640x640@30fps 需 0.96 TOPS, 利用率 8%;1280x720@60fps 需 3.6 TOPS, 30%
怎么读([推算]):在 QCS6490 上跑 YOLO 级模型,NPU 利用率往往很低(个位数到几十)——这再次印证第 07 讲 7.3 的论断:不是板子不行,是你的模型/帧率根本喂不饱 12 TOPS。这其实是好消息:说明 QCS6490 跑单路实时检测「绰绰有余」,你甚至有余量去加模型、加帧率、或上多路。真实利用率请把你的真实 MACs 与实测 FPS 代进去。
把多路相机的带宽与算力预算合到一起,判断「QCS6490 能不能扛 N 路」:
# [推算] 多路相机:总带宽 + NPU 总算力需求(纯标准库)
PEAK = 12.0
def multi_cam_analysis(n_cams, res_w, res_h, fps, macs_per_cam):
    # 带宽:RGB 三通道近似
    bw_per = res_w * res_h * 3.0 * fps / (1024*1024)
    total_bw = bw_per * n_cams
    # NPU:每路模型算力需求
    need_per = macs_per_cam * 2 * fps / 1000.0
    total_need = need_per * n_cams
    util = total_need / PEAK * 100
    print(f"{n_cams} 路 {res_w}x{res_h}@{fps}fps: "
          f"总带宽≈{total_bw:.0f} MB/s, NPU需{total_need:.2f} TOPS, 利用率≈{util:.0f}%")
    return total_bw, util

# 4 路 720p@30fps,每路 YOLO 约 16G MAC(640 级输入放大到 720p 近似)[推算]
multi_cam_analysis(4, 1280, 720, 30, 16.0)
# 输出示例(推算): 4 路 720p@30fps: 总带宽≈332 MB/s, NPU需3.84 TOPS, 利用率≈32%
结论([推算]):4 路 720p 实时检测,QCS6490 的 NPU 利用率约 32%、带宽约 0.33 GB/s——完全在能力范围内。但若升到「12 路 1080p 工业检测」,就该换 IQ-8275(40 TOPS、12 路 CSI)甚至 IQ-9075(100 TOPS、16 路),这正是第 02 讲选型逻辑的回响:视觉场景里,相机路数与带宽是比算力更硬的约束。
原理和账算完,落到「怎么写」。这一节给的是思路与骨架,不是逐行可编译成品——因为相机具体型号、AidLux 版本、QNN Python API 细节以阿加犀/高通官方资料为准,硬写死反而会误导。
实时检测首选 YOLO 系列(单阶段检测器,天然适合实时)。原始论文 arXiv:1506.01497 奠定了单阶段检测思路,后续 v5/v8 等在精度与速度上持续迭代。工程上注意:
第 07 讲你已经产出 model.so / model.bin(HTP backend)。本讲只是把「喂数据」的源头从文件换成相机帧。关键纪律不变:前处理(resize、归一化均值方差、RGB/BGR、NHWC 排布)必须和第 05 讲导出 ONNX、第 06 讲校准时完全一致,否则 NPU「跑得很忙、框全错」。
下面是一段逻辑骨架(标准库 + 注释丰富,落地时把相机 API / QNN Python 绑定换成你环境的真实接口即可):
# [推算] 相机 -> NPU 实时检测 逻辑骨架(以官方相机/QNN API 为准,非逐行可编译)
import time

def camera_loop(model_so, input_size=(640, 640)):
    # 1) 打开相机(具体 API 以 AidLux/官方 camera SDK 为准)
    cap = open_camera(mipi_id=0, width=1920, height=1080, fps=30)
    # 2) 加载第 07 讲的 INT8 context binary(HTP backend)
    net = load_qnn_model(model_so, backend="libQnnHtp.so")

    frame_idx = 0
    while True:
        t0 = time.time()
        raw = cap.read()                       # 阶段1: 采集(MIPI -> buffer)
        pre = isp_preprocess(raw, input_size) # 阶段2: Spectra/硬件预处理到模型输入
        out = net.run(pre)                    # 阶段3: HTP 推理(YOLO INT8)
        boxes = postprocess(out, raw.shape)   # 阶段4: NMS/解码框(CPU)
        show(raw, boxes)                      # 阶段5: 显示/推流闭环
        frame_idx += 1
        if frame_idx % 30 == 0:
            fps = 1.0 / (time.time() - t0)
            print(f"[第{frame_idx}帧] 端到端 ≈ { (time.time()-t0)*1000:.1f} ms, "
                  f"≈ {fps:.1f} FPS [推算/实测占位]")

# 注意:上面 open_camera/isp_preprocess/load_qnn_model/postprocess/show
# 的真实实现依赖你的相机驱动、AidLux 视觉库、QNN Python API 与显示库,
# 务必以阿加犀/高通官方文档为准,本骨架只表达「五阶段闭环」的控制流。
诚实标注:相机的
read()、ISP 预处理、QNN Python 绑定、画框显示,四者的真实接口随 AidLux/相机型号/SDK 版本而变。本骨架的价值是把第 2.2 节的 mermaid 变成可对照的控制流,而不是给你一份「复制即跑」的代码(那会诱导你在不确定参数上出错)。
把 5.3 收口成一个可演示的产品形态:
这个 Demo 的价值不止「炫」——它是后续所有视觉产品(门禁、巡检、机器人感知、工业质检)的最小可运行内核。
把第 4.3 节的推算,替换成你自己的 [实测] 值,做成一份可归档的账本:
| 阶段 | [推算]占位 ms | [实测]你的 ms | 优化手段 |
|---|---|---|---|
| 采集(曝光+读出) | 8.0 | ___ | 升帧率/改快门(受硬件限) |
| ISP 硬件预处理 | 3.0 | ___ | 让 ISP 直接出模型尺寸 |
| NPU 推理(YOLO INT8) | 12.0 | ___ | 第 07 讲 HTP + 量化 |
| 后处理(NMS) | 2.5 | ___ | 减少候选框/用 GPU 协助 |
| 显示/上屏 | 5.0 | ___ | 双缓冲/硬件合成 |
| 端到端 | 30.5 | ___ | 取关键路径最小值 |
每次换模型/换分辨率/换相机,都重填这张表。它是你「实时性是否达标」的客观判据,比「感觉挺流畅」靠谱一万倍。
单路跑通只是入门,真实产品常常是「多只眼睛一起看」。这一节讲多路带来的新约束与应对。
多路不是「N 个单路叠起来」那么简单——它引入了带宽竞争、算力分摊、帧同步三个新维度。
QCS6490 平台支持多路 MIPI CSI 并发接入(具体路数、各路最高分辨率组合以阿加犀/高通官方规格书为准)。工程上要做的是:确认你的「路数 × 分辨率 × 帧率」落在 SoC 的 MIPI 带宽与 ISP 处理能力之内(用第 3–4 节的带宽账先算一遍)。一旦超出,要么降分辨率、要么降帧率、要么换 IQ 系列(12–16 路 CSI)。
回顾 1.4 说的「流水线不是简单串联」。正确的做法是把五阶段铺成可并行的产线,用缓冲衔接:
flowchart LR
    subgraph P1[产线1 采集]
        C1[相机A 出帧] --> B1[Buffer A]
    end
    subgraph P2[产线2 推理]
        B1 --> I1[NPU 推理 A]
        C2[相机B 出帧] --> B2[Buffer B]
        B2 --> I2[NPU 推理 B]
    end
    subgraph P3[产线3 后处理+显示]
        I1 --> POST1[NMS+画框 A]
        I2 --> POST2[NMS+画框 B]
        POST1 --> DISP[合成上屏/推流]
        POST2 --> DISP
    end
要点:
复用 4.5 的 multi_cam_analysis,对不同配置快速试算,决定「在 QCS6490 上到底能上几路」:
# [推算] 不同多路配置下的预算对照(纯标准库)
configs = [
    (2, 1280, 720, 30, 16.0, "双目/双视角"),
    (4, 1280, 720, 30, 16.0, "四路环视"),
    (4, 1920, 1080, 30, 30.0, "四路1080p重负载"),
]
for n, w, h, fps, macs, desc in configs:
    print(f"[{desc}] ", end="")
    multi_cam_analysis(n, w, h, fps, macs)
# 输出示例(推算): 四路1080p重负载 NPU需11.5 TOPS, 利用率≈96% —— 已逼近 QCS6490 上限!
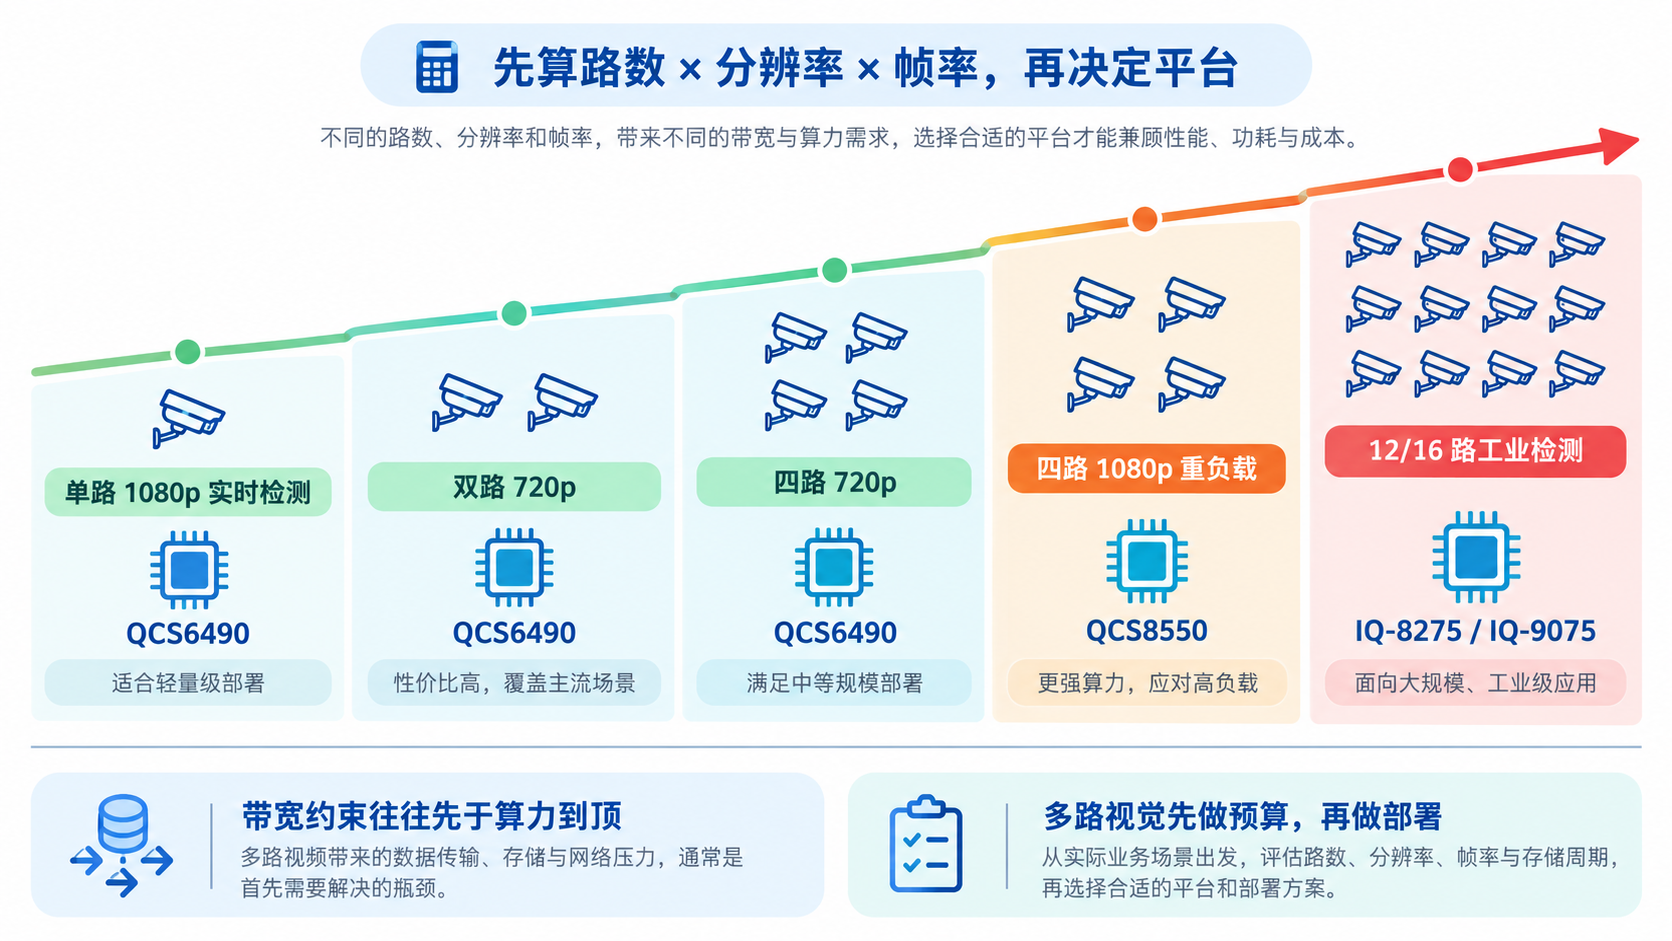
判读([推算]):四路 1080p 重负载时 NPU 利用率逼近 96%,这意味着几乎没余量——再叠加后处理、显示、系统开销就会掉帧。这时就该下探分辨率(720p)、或换 QCS8550(~48 TOPS),或把多路拆到多块板,这是在第 02 讲「选型看持续余量、不盯峰值」中描述的视觉场景落地。
相机在 v4l2-ctl / 相机 App 里能出图,≠ 你的 AI 流水能 30 FPS。前者只看采集,后者看五阶段总和(第 4.3 节)。务必用端到端 FPS 验收,而不是「能出画面」。
最典型的反模式:相机出全分辨率 → CPU 软 resize → CPU 软转 RGB → 再送 NPU。这一步往往比 NPU 推理还慢。对策:让 Spectra ISP 在硬件里直接出模型尺寸与格式(2.4 节),把 CPU 从搬运工解放。
ISP 默认出 NV12,NPU 训练时吃 RGB NHWC,中间若漏了格式/排布转换,结果是「跑通了但框全错」。对策:把前后处理与第 05/06 讲导出校准时逐项比对(呼应第 07 讲坑点 9.4)。
每帧都 memcpy 一遍相机 buffer 到 NPU 输入,既吃 CPU 又吃带宽。对策:用共享内存/ION buffer,让 ISP/NPU/后处理读同一块物理内存(2.9 节 zero-copy)。这是从 Demo 到产品的分水岭优化。
四路 1080p 的 RGB 带宽已近 0.75 GB/s,若再叠加 NPU 权重读写、显示,总线竞争激烈。对策:ISP 就近缩小到模型输入尺寸、用硬件编码推流、必要时降路数/分辨率或更换更高带宽平台(IQ 系列)。
以为 NPU 12ms 就一定 80 FPS,却忘了 HDMI 60Hz 屏幕物理上限就是 60 FPS,且 vsync 等待会吃掉余量(第 4.3 节已示)。对策:实测端到端 FPS 而非 NPU 单段 FPS;显示不是越快越好,匹配场景即可。
归一化均值/方差、RGB/BGR、NCHW/NHWC、resize 插值方式,任意一处和第 05/06 讲不一致,NPU 就会「跑得忙、结果错」。这是首跑最常见的隐形 bug,务必建一份「前后处理核对清单」。
QCS6490 12 TOPS 是峰值。真实单模型实得往往只有峰值的 30%70%(第 01 讲 2.3、第 07 讲 9.8)。报告里凡写数字必标 [官方]/[推算]/[实测],绝不把峰值当实测。
工业/户外场景相机可能过热、断流、丢帧。代码若假设「相机永远在」,一旦掉帧整个进程卡死。对策:加帧超时、断流重连、缓冲区背压保护(6.3 节)。产品级流水线的稳定性,一半在「异常兜底」。
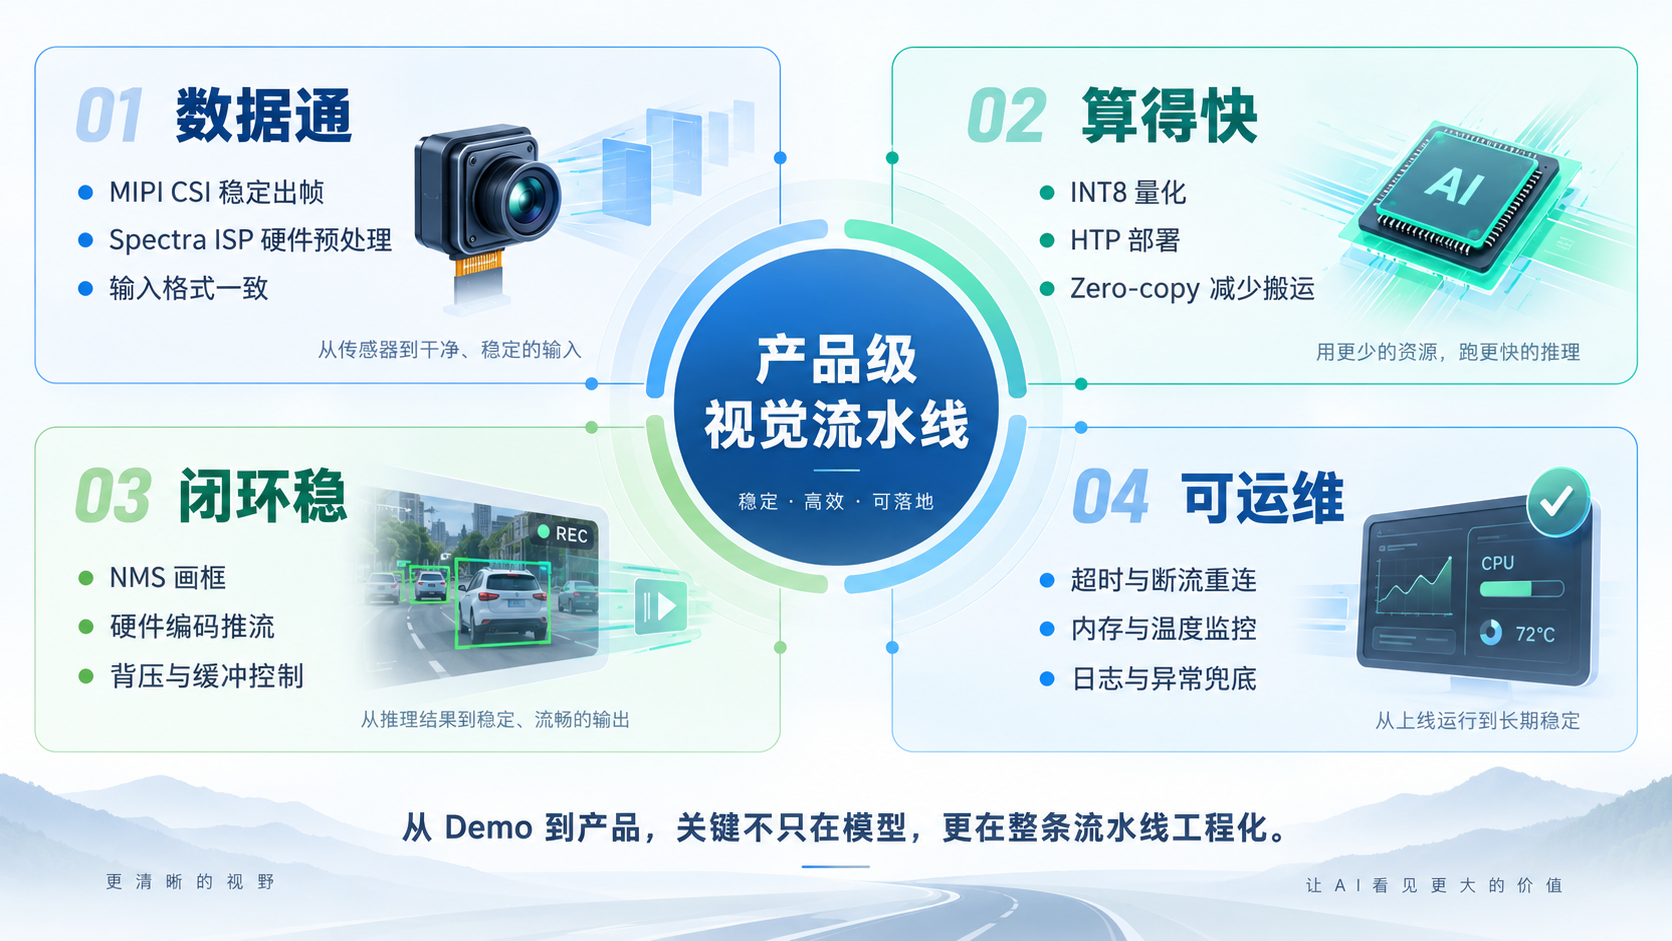
如果把前面的工程问题全部收束起来,一条真正能上线的视觉流水线,
最终无非要满足四件事:数据通、算得快、闭环稳、可运维。
Q1:Spectra ISP 能不能帮我把图直接缩到模型输入尺寸?
能,且强烈建议这么做。QCS6490 的 Spectra ISP 支持硬件缩放/裁剪,把相机原图在 ISP 内直接规整到模型输入(如 640×640),NPU 只收小图,省带宽又省时(2.4、3.4 节)。别让 CPU 软 resize。
Q2:单路 1080p 实时检测,QCS6490 够吗?
从算力账看(4.4 节 [推算])绰绰有余:YOLO 级模型在 30 FPS 下 NPU 利用率往往只有个位数到十几。真正的约束常在相机帧周期(30fps→33ms 硬下限)与显示 vsync,而非 NPU。先用第 07 讲 qnn-profile 实测你的模型单帧延迟,再填 5.5 的延迟表。
Q3:多路相机一定要多颗 NPU 吗?
不一定。QCS6490 单颗 HTP 可通过分时复用跑多路(轮流喂不同路帧),靠调度隐藏单路延迟;算力够则并流。要不要升级到多 NPU/多板,看第 6.4 节的预算——四路 1080p 重负载已逼近 QCS6490 上限,那时该换 QCS8550 或 IQ 系列。
Q4:相机帧怎么「零拷贝」喂给 NPU?
理想路径是相机帧经 ISP 后驻留在共享内存/ION buffer,NPU 与后处理直接从同一块读,全程不 memcpy(2.9 节)。具体 API 取决于 AidLux/相机 SDK/ QNN 运行时版本,以阿加犀/高通官方资料为准。核心是「在设计上避免 CPU 拷贝」。
Q5:为什么我 NPU 单帧 12ms,流水却只有 25 FPS?
因为端到端 ≠ NPU 单段。采集周期(30fps→33ms)、ISP、后处理 NMS、显示 vsync 都在叠加(4.3 节)。25 FPS 可能已经快撞上 30fps 帧周期下限了——先填 5.5 延迟表定位哪段最长,别只盯着 NPU。
Q6:推流用 CPU 软编码还是硬件编码?
务必用 QCS6490 的硬件视频编码器(H.264/H.265),码率仅几到十几 MB/s,几乎不占 CPU;CPU 软编码会吃掉本就紧张的算力与带宽,实时性直接崩。
Q7:前后处理放 CPU 还是 GPU?
NMS/解码框这类逻辑强、并行弱的后处理,通常 CPU 足够;若框极多(如密集小目标),可考虑 GPU 协助。但记住后处理再快也受模型输出规模影响——优化优先级仍是「ISP 硬预处理 + zero-copy + NPU 量化」三件套。
Q8:多路相机怎么保证帧同步?
给每路帧打硬件/软件时间戳,按时间窗对齐再推理(6.3 节)。纯软件对齐有抖动,关键场景要查相机是否支持硬件触发/全局快门,具体以相机型号与官方资料为准。
Q9:为什么我的流水跑一会儿就内存爆了?
典型原因是缓冲区无上限:相机出帧快于推理消费,帧越积越多。对策:buffer 设上限,满了丢最旧帧或降采样(背压管理,6.3 节);同时检查是否漏了释放相机/推理 buffer 的引用。
Q10:QCS6490 跑不动我的多路需求,换哪颗?
按第 02 讲逻辑:多路视觉 + 强 ISP 选 QCS8550(~48+12 TOPS);12 路工业检测选 IQ-8275(~40 TOPS、12 路 CSI);16 路重负载选 IQ-9075(~100 TOPS、16 路 CSI)。换 SoC 后,第 05–07 讲的 QNN 流程复用,只需重编译 context binary 并核对 BSP 版本(第 04 讲 1.7)。
Q11:实时检测的延迟达标线怎么定?
看场景:机器人避障/AR 交互要 10–30ms 级;工业质检看产线节拍;安防回看可放宽到百 ms。先把 5.5 延迟表填出 [实测],再对照场景阈值,别拍脑袋。
Q12:本讲和第 07 讲的关系是什么?
第 07 讲交付「能在 HTP 上跑通的 INT8 模型 + 延迟测量方法」;本讲把它接上真实相机、做成连续不断的实时流水线,并引入带宽/延迟/多路的新约束。两者是「单点性能」与「系统工程」的关系——第 07 讲是地基,本讲是在上面盖的房子。
本讲把第 07 讲「跑通一张图」升级成了「连续看世界的视觉流水线」:
核心收获盘点:
本讲关键认知速记:视觉实时 ≠ NPU 快;ISP 先干活、zero-copy 少搬运、带宽比算力更先到顶;多路先算预算再决定平台。所有性能数字标 [官方]/[推算]/[实测],峰值 ≠ 实得。
下一讲(第 09 讲) 我们横向拓展到多媒体与音频:把高通的硬件编解码器(视频/音频)、音频 DSP 与 NPU 协同利用起来,讲清楚「视觉 + 音频 + 多媒体」在同一颗 SoC 上如何互不抢资源、如何做多模态流水线——让你的边缘设备既能「看」,也能「听」与「说」。


