

301
社区成员
 发帖
 与我相关
 我的任务

 分享
title: 大二下面向对象设计与构造课程总结
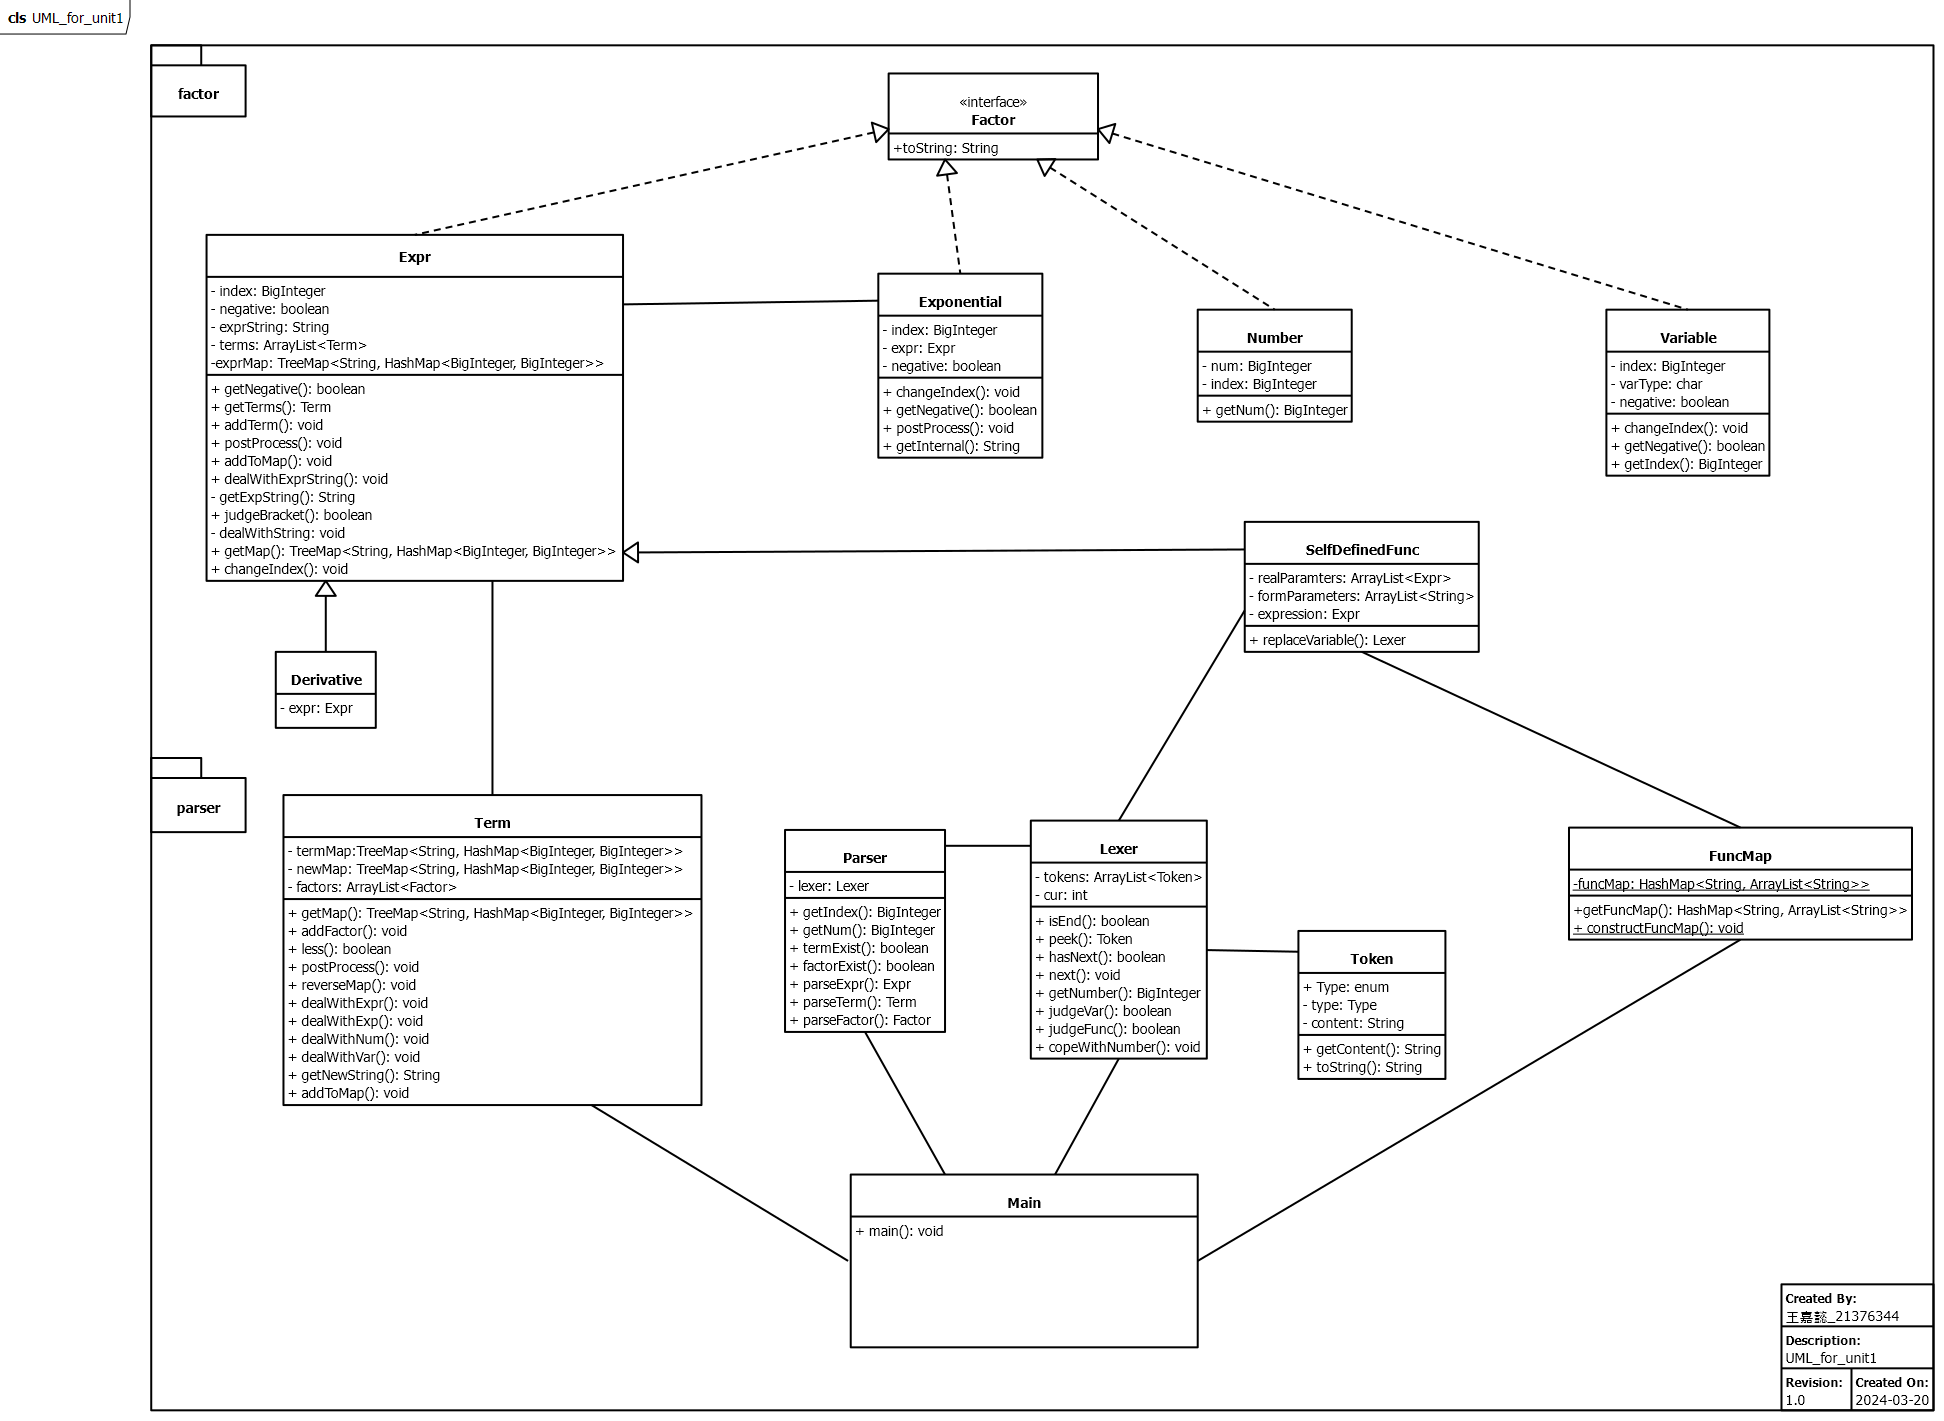
自我评价:类的构建结构较为清晰、各个类内部聚合度高、冗余部分少,总体架构设计而言有较强的可迭代性,尤其是在`hw3`时,只需补充较少的内容即可实现求导功能;但缺点在于内部逻辑较为复杂,不利于调试
Main:
接受屏幕输入,并构建相应的funcMap,以备后续对自定义函数的解析;实例化Lexer、Parser和Expr类
FuncMap:
简单解释、化简并储存输入的自定义函数的原始定义
Lexer:
用于扫描分析输入的字符串,利用Token对其进行分类的初步化简
Parser:
词法解释器,接收Lexer格式化之后的token列表,并将其解释为对应的Expr、Term、Factor
Term:
实例后储存因子为单位的解释实例,并为Expr提供最后用于转换为输出字符串的termMap
Token:
为Lexer类中各个基本单位提供格式化方式,从而方便Parser解释器中对于Expr、Term、Factor的词法解释
Derivative:
导数因子类,储存导数因子的有关信息,对外提供求导方法
Exponential:
指数因子类,储存指数因子的有关信息
Expr:
表达式因子以及最终表达式的存储类,兼顾对Term最小因子单位的存储能力以及接受下属Term后输出最终表达式字符串的表达能力
Factor:
作为一个接口,满足因子这一单位的多态性
Number:
常数类,储存常数因子
SelfDefinedFunc:
自定义函数类,继承自Expr类,对自定义函数进行对应的替换、展开工作
Variable:
自变量因子类,存储自变量x与其index
代码规模
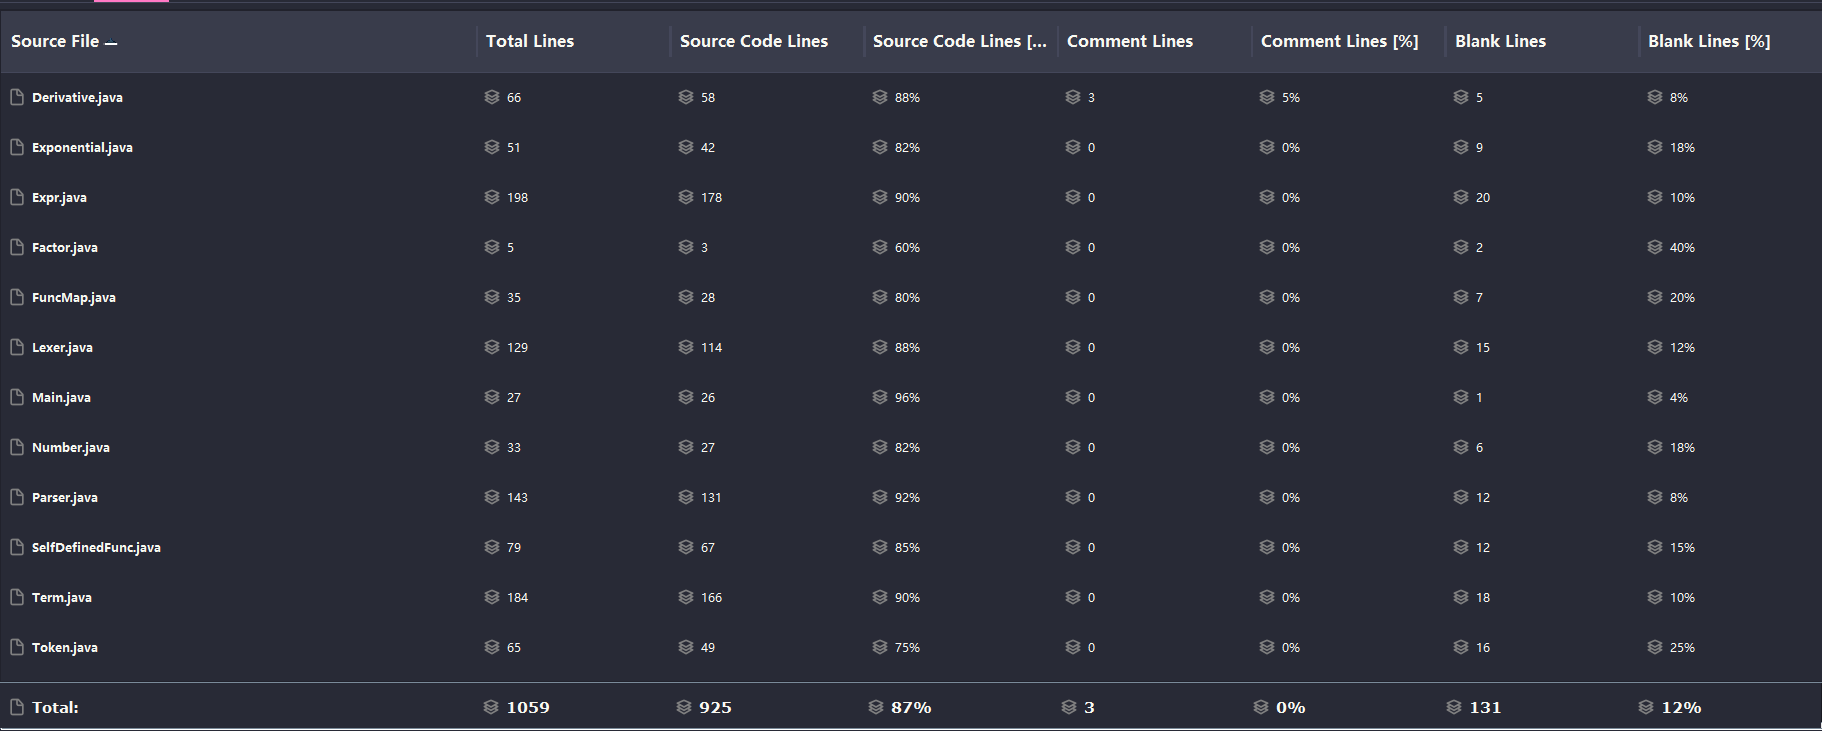
实用代码规模为900到1000,个人认为规模较有限,功能集成度满足普遍标准
复杂度展示
各复杂度含义解释
$$
CogC:认知复杂度,衡量代码的难以理解的程度,CogC高说明代码比较难以理解
ev(G):基本复杂度,是用来衡量程序非结构化程度的,非结构成分降低了程序的质量,增加了代码的维护难度,使程序难于理解。因此,基本复杂度高意味着非结构化程度高,难以模块化和维护。实际上,消除了一个错误有时会引起其他的错误。
Iv(G)是模块设计复杂度,是用来衡量模块判定结构,即模块和其他模块的调用关系。软件模块设计复杂度高意味模块耦合度高,这将导致模块难于隔离、维护和复用。模块设计复杂度是从模块流程图中移去那些不包含调用子模块的判定和循环结构后得出的圈复杂度,因此模块设计复杂度不能大于圈复杂度,通常是远小于圈复杂度。
v(G)是圈复杂度,用来衡量一个模块判定结构的复杂程度,数量上表现为独立路径的条数,即合理的预防错误所需测试的最少路径条数,圈复杂度大说明程序代码可能质量低且难于测试和维护,经验表明,程序的可能错误和高的圈复杂度有着很大关系。
$$
| Complexity metrics | ||||
|---|---|---|---|---|
Method//方法复杂度 | CogC | ev(G) | iv(G) | v(G) |
Main.main(String[]) | 1 | 1 | 2 | 2 |
factor.Derivative.Derivative(Expr, Boolean) | 0 | 1 | 1 | 1 |
factor.Derivative.postProcess() | 27 | 4 | 8 | 9 |
factor.Exponential.Exponential(Expr, boolean) | 0 | 1 | 1 | 1 |
factor.Exponential.changeIndex(BigInteger) | 0 | 1 | 1 | 1 |
factor.Exponential.getInternal() | 2 | 2 | 1 | 2 |
factor.Exponential.getNegative() | 0 | 1 | 1 | 1 |
factor.Exponential.postProcess() | 0 | 1 | 1 | 1 |
factor.Exponential.toString() | 4 | 1 | 1 | 3 |
factor.Expr.Expr(boolean) | 0 | 1 | 1 | 1 |
factor.Expr.addTerm(Term) | 0 | 1 | 1 | 1 |
factor.Expr.addToMap(String, BigInteger, BigInteger) | 5 | 1 | 3 | 3 |
factor.Expr.changeIndex(BigInteger) | 0 | 1 | 1 | 1 |
factor.Expr.dealWithExprString() | 26 | 4 | 10 | 12 |
factor.Expr.dealWithString(StringBuilder, BigInteger, StringBuilder) | 6 | 1 | 4 | 4 |
factor.Expr.getExpString(String) | 21 | 1 | 6 | 7 |
factor.Expr.getIndex() | 0 | 1 | 1 | 1 |
factor.Expr.getMap() | 0 | 1 | 1 | 1 |
factor.Expr.getNegative() | 0 | 1 | 1 | 1 |
factor.Expr.getTerms() | 0 | 1 | 1 | 1 |
factor.Expr.judgeBracket(String) | 3 | 1 | 2 | 4 |
factor.Expr.postProcess() | 6 | 1 | 4 | 4 |
factor.Expr.toString() | 0 | 1 | 1 | 1 |
factor.Number.Number(BigInteger) | 0 | 1 | 1 | 1 |
factor.Number.changeIndex(BigInteger) | 0 | 1 | 1 | 1 |
factor.Number.getNum() | 1 | 1 | 2 | 2 |
factor.Number.toString() | 1 | 1 | 2 | 2 |
factor.SelfDefinedFunc.SelfDefinedFunc(ArrayList<String>, ArrayList<Expr>, boolean) | 2 | 1 | 3 | 3 |
factor.SelfDefinedFunc.changeIndex(BigInteger) | 0 | 1 | 1 | 1 |
factor.SelfDefinedFunc.getMap() | 0 | 1 | 1 | 1 |
factor.SelfDefinedFunc.getTerms() | 0 | 1 | 1 | 1 |
factor.SelfDefinedFunc.postProcess() | 0 | 1 | 1 | 1 |
factor.SelfDefinedFunc.replaceVariable(Lexer) | 8 | 4 | 5 | 5 |
factor.SelfDefinedFunc.toString() | 0 | 1 | 1 | 1 |
factor.Variable.Variable(char, boolean) | 0 | 1 | 1 | 1 |
factor.Variable.changeIndex(BigInteger) | 0 | 1 | 1 | 1 |
factor.Variable.getIndex() | 0 | 1 | 1 | 1 |
factor.Variable.getNegative() | 0 | 1 | 1 | 1 |
factor.Variable.toString() | 4 | 1 | 1 | 3 |
parser.FuncMap.FuncMap() | 0 | 1 | 1 | 1 |
parser.FuncMap.constructFuncMap(ArrayList<String>) | 6 | 1 | 4 | 4 |
parser.FuncMap.getFuncMap() | 0 | 1 | 1 | 1 |
parser.Lexer.Lexer(String) | 26 | 1 | 16 | 17 |
parser.Lexer.copeWithNumber(String, int) | 4 | 3 | 2 | 4 |
parser.Lexer.getNumber(char) | 2 | 1 | 3 | 3 |
parser.Lexer.getString() | 1 | 1 | 2 | 2 |
parser.Lexer.getTokens() | 0 | 1 | 1 | 1 |
parser.Lexer.hasNext() | 0 | 1 | 1 | 1 |
parser.Lexer.isEnd() | 0 | 1 | 1 | 1 |
parser.Lexer.judgeFunc(char) | 1 | 1 | 1 | 3 |
parser.Lexer.judgeVar(char) | 1 | 1 | 1 | 3 |
parser.Lexer.next(int) | 0 | 1 | 1 | 1 |
parser.Lexer.peek() | 0 | 1 | 1 | 1 |
parser.Parser.Parser(Lexer) | 0 | 1 | 1 | 1 |
parser.Parser.factorExist() | 1 | 2 | 1 | 2 |
parser.Parser.getIndex() | 4 | 1 | 3 | 3 |
parser.Parser.getNum() | 3 | 1 | 3 | 3 |
parser.Parser.parseExpr(boolean) | 1 | 1 | 2 | 2 |
parser.Parser.parseFactor() | 13 | 6 | 9 | 10 |
parser.Parser.parseTerm() | 1 | 1 | 2 | 2 |
parser.Parser.termExist() | 2 | 2 | 2 | 3 |
parser.Term.Term() | 0 | 1 | 1 | 1 |
parser.Term.addFactor(Factor) | 0 | 1 | 1 | 1 |
parser.Term.addToMap(String, BigInteger, BigInteger) | 5 | 1 | 3 | 3 |
parser.Term.dealWithExp(String) | 7 | 1 | 4 | 4 |
parser.Term.dealWithExpr(TreeMap<String, HashMap<BigInteger, BigInteger>>) | 16 | 1 | 6 | 6 |
parser.Term.dealWithNum(BigInteger) | 7 | 1 | 4 | 4 |
parser.Term.dealWithVar(BigInteger) | 7 | 1 | 4 | 4 |
parser.Term.getMap() | 0 | 1 | 1 | 1 |
parser.Term.getNewString(String, String) | 4 | 2 | 2 | 4 |
parser.Term.less(BigInteger, BigInteger) | 0 | 1 | 1 | 1 |
parser.Term.postProcess() | 21 | 4 | 11 | 11 |
parser.Term.reverseMap() | 0 | 1 | 1 | 1 |
parser.Token.Token(Type, String) | 0 | 1 | 1 | 1 |
parser.Token.getContent() | 0 | 1 | 1 | 1 |
parser.Token.isAdd() | 0 | 1 | 1 | 1 |
parser.Token.isDerive() | 0 | 1 | 1 | 1 |
parser.Token.isExp() | 0 | 1 | 1 | 1 |
parser.Token.isFunc() | 0 | 1 | 1 | 1 |
parser.Token.isLeft() | 0 | 1 | 1 | 1 |
parser.Token.isMul() | 0 | 1 | 1 | 1 |
parser.Token.isPow() | 0 | 1 | 1 | 1 |
parser.Token.isRight() | 0 | 1 | 1 | 1 |
parser.Token.isSub() | 0 | 1 | 1 | 1 |
parser.Token.isVar() | 0 | 1 | 1 | 1 |
parser.Token.toString() | 0 | 1 | 1 | 1 |
复杂度分析:
可以看到复杂度大体上处在一个相对低的值,不过仍有部分方法在体现出了较高的复杂度
复杂度峰值产生处:
1、factor.Derivative.postProcess()
因子求导部分的具体实现,需要对多种求导情况进行分类讨论,产生分支繁多
2、factor.Expr.dealWithExprString()
总表达式类对表达式map的拆分以及最终表达式化简后字符串的构建处,需要对ExprMap的内容进行集中处理,中间调用了多个类内函数以满足最终需求,产生较高复杂度
3、factor.Expr.getExpString(String)
与指数函数相乘有关的新字符串的构建,需考虑的情况较多(如同类项合并等),并且需要在其内置一表达式的解释器用于解释并归类新产生的内部字符串,带来了相应的复杂度
4、parser.Lexer.Lexer(String)
对输入的原始字符串的初步词法分析和化简,包含了对不同Token类型的归类
tokens队列的产生,需要进行多样的分类讨论,分支较多
5、parser.Parser.parseFactor()
内含对多种因子的解释以及Term中factors队列的入列处理,需要对不同可能的因子 进行分类讨论,并对之进行相应的处理和实例化,导致了较高的复杂度
6、parser.Term.dealWithExpr(TreeMap<String, HashMap<BigInteger, BigInteger>>)
对尚未归类的表达式因子进行分割和归类入Map,需要考虑到新入册的表达式因子内部的多种情况,并基于其内置Map的keyset进行循环迭代,各个复杂度均较高,但是在该代码框架下难以避免
7、parser.Term.postProcess()
对Term在Parser解析过程后已包含的Factor进行相应的以分类讨论为基本的解释,以及Map的构建,需要在Factor为Expr、Variable、Number等情况下对其分别解释、分别分析归类,产生复杂度较高
从hw1到hw2进行了一次规模较大的重构
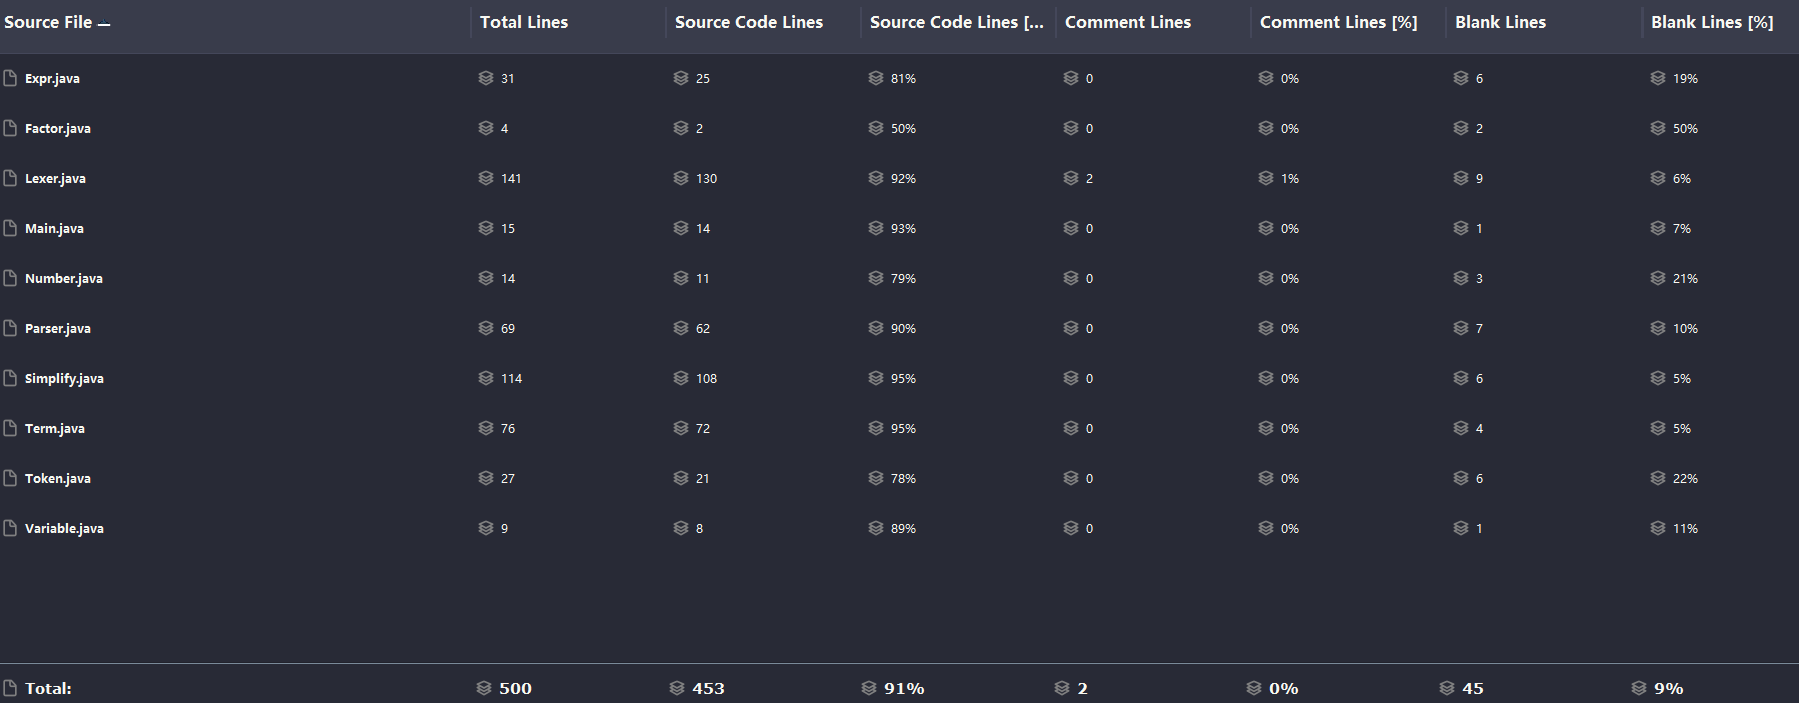
由上图可观察到,在`hw1`时,我`Simplify`一类用于最后的字符串化简,看起来好像无伤大雅,可实际上这是因为当时使用的逻辑是`index`全面展开->`parser`解析->利用`toString`配合特判使得表达式初步成型->Simplify类内化简出结果这一逻辑,这一逻辑有着明显的漏洞:
1、一开始就在`Lexer`部分将所有的index都展开,这会在一些如`x^8^8^8`...的特殊情况时发生数组越界、超时的情况
2、在最终表达式的`toString`时,中间过程的信息传递均使用`String`传递,这会导致结构内部对于Parser的过重复调用,需要多次特判来解决特殊情况,不利于调试和效用,这也使得最终必须新加入一个Simplify类用于最终的化简,属于是结构冗余了
为各个泛化自Factor接口的类赋予index这一属性,并在对应的解释中做相应的处理
取缔Simplify这一抽象类,在各个层次的信息传递时使用如
private final TreeMap<String, HashMap<BigInteger, BigInteger>> exprMap = new TreeMap<>();

public TreeMap<String, HashMap<BigInteger, BigInteger>> getMap() {
    return exprMap;
}
的表达式Map来组成构建条件,为之配置好相应的接口和处理函数,以满足后续迭代需要
假设:需要添加入如sin、cos、tan等三角函数功能实现
可迭代性:只需新构建相应的三角函数类别,并在Parser解析、TermMap构建、expr字符串构建等部分做好三角函数情况的特殊、特殊构建即可,可扩展性以及可迭代性较强
已出现过的bug
hw1中涉及到正负项加减的错误:
原因在于Term内有关表达式因子的解释逻辑存在问题,其只可处理因子在输入时自带负号的情况,而无法处理因子在化简后产生"新"负号的情况,使得当测试样例够大时回产生bug,我认为这跟架构的设计有关,在当时的设计中Term结构过分地依赖于基于字符串的信息传递,导致每次新使用已产生的因子时都要再解释一遍,这提高了产生bug的概率,也提高了调试成本,加上测试样例不够全面,最后导致了强测出问题
hw2中未考虑自定义函数的声明可以包含空白符的情况:
可以说是最乌龙的错误,其主要原因在于对题意中的隐藏条件不够敏锐,实际上在题干中从未提及到关于自定义函数的声明格式中不可包含空白字符,再加上中测中未测试到该情况,最终使得笔者强测爆炸=.=,这意味着我读题以及构建样例时仍不够谨慎
hw2的架构无法满足index连续展开:
对此部分的反思在上文中"改进策略"已经完成
bug与复杂度相关的分析
差异:
明显可以发现出现bug的方法其复杂度往往相比于未出现bug的方法而言复杂度要高出不少,且其往往有较多较复杂的分支,这为代码的调试和重构增添了不少麻烦
降低复杂度:
可以通过将多分支拆解为不同的类与方法来降低其复杂度,或者重构成信息密度较大的、更依赖于JAVA容器的结构,从而达到方便调试、减少隐藏bug的效果,应切记遵循封装原则,力求各部分各司其职而不互相干扰
发现他人bug的策略
评测机:
使用评测机对其进行暴力枚举进而找到对应的薄弱部分,并以此为基本进行更广泛的打击
代码阅读与复杂度评估:
阅读对方的代码,重点关注其中复杂度较高、分支较多、结构冗余较多的部分,因为这可能意味着其在这一部分的优化做得不够完善,往往越复杂难解的结构,编程者便往往更难意识到该结构中存在的漏洞,可以基于此对其进行试探的hack
优化分析
优化方式:
优化的过程实际上就是上文提到过的优化过程,此处便不再赘述
优化效果:
该优化可以保证代码的整洁性与正确性,其宗旨在于将用于制造最终输出字符串所需的信息打包于Term和Expr中相应的TreeMap中进行传递,从而起到降低复杂度、易于理解并使得程序更加简洁的作用
在第一单元中我们学习了递归下降法、词法解释等内容,其中递归下降在JAVA中配合类系统的使用使我印象深刻,递归下降与类系统的配合使用可以做到将原本繁纷复杂的结构解构成一个个细小的单位以供输入,我认为这简直是递归结构与JAVA语言彼此优势的完美融合,凸显出的是一种封装的、结构化的编程智慧
其次,在第一单元的学习中,一次次的结构优化和调整也让我收益匪浅,在这个过程中我领会到了从设计架构的一开始便需要考虑其可迭代空间、可优化性、可扩展性,并且应通过利用相应的容器以减小类与类之间信息传递的复杂度,且应通过结构上的优化以避免"重复造轮子"的现象,提高结构的集成度的同时兼顾好各个方法的复杂度,利用不同方法的模块化分工来减小调试的成本、降低bug发生的概率
最后,在第一单元的学习中,我养成了利用IDEA的分步调试功能并结合设置的断点debug的习惯,一改以前到处乱加System.out.println的头铁习惯,学会了从更加实际更加具有层次化的角度出发来调试自己的代码,我认为这对于我以后的学习与开发都大有裨益
最后我希望感谢课程组的老师和助教们,我在这一单元经历的良好的课程体验以及收获的知识成果均离不开你们的付出与支持,谢谢你们
在整个第一单元的学习历程中我认为是非常满意的,如果非得提出建议的话,我建议以后上机的时间或许应该调整地较前一些,因为实际上在作业发布之后很大一部分都已经开始动手实操了,这个时候再进行像是上机课这样以预习作业内容为基准设置难度的课程,属实有些令人感到食之无味弃之可惜,以上是我的一些拙见

orz


