

 2024年北航面向对象设计与构造

BUAA-OO 第一单元总结
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
第一次作业
简述
第一次作业的类图如下:
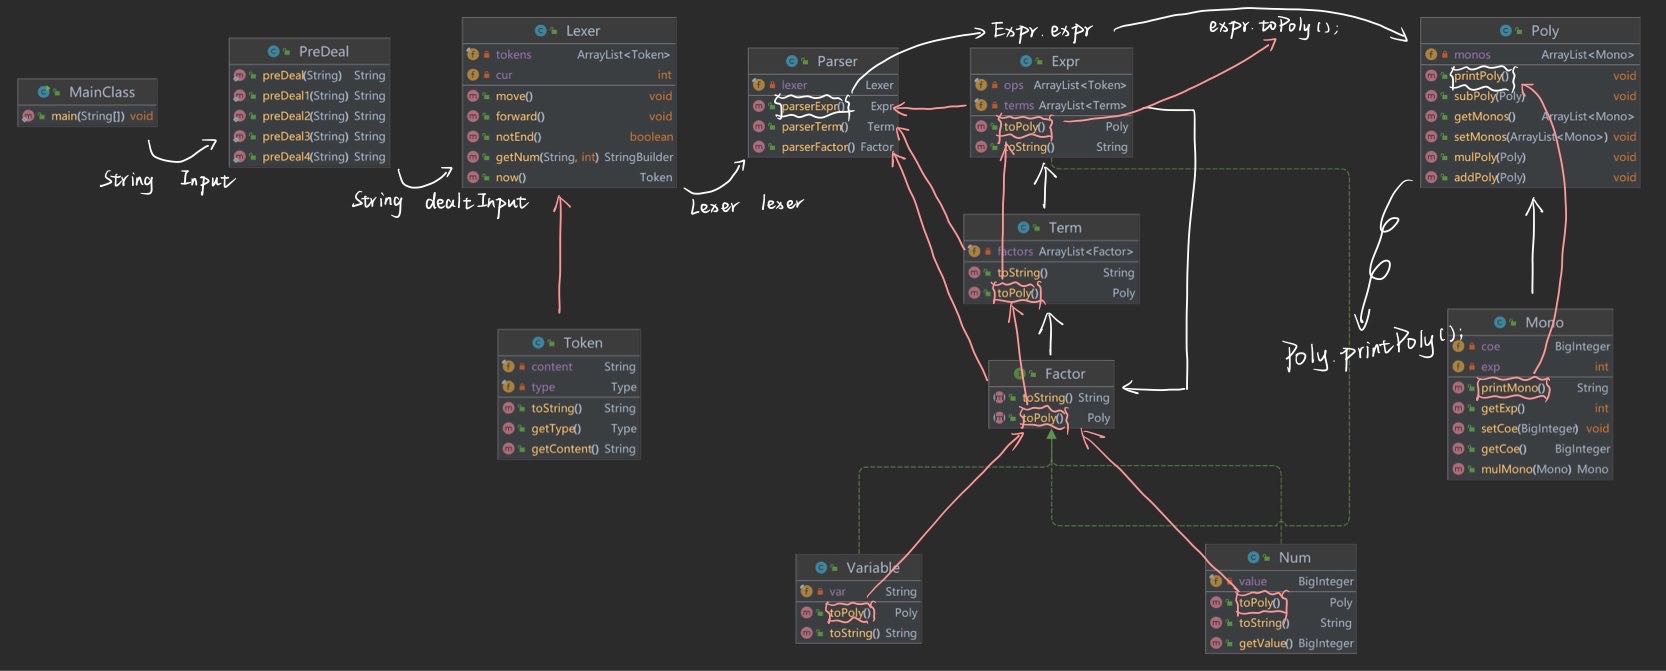
其中白色箭头大致展现出了数据的流动方向,粉色箭头表示一种工具与工具使用者之间的支持关系,绿色箭头为继承关系。
类图中包含了我对第一次作业中架构的思考,即分三步完成任务:对输入进行预处理和token切分;递归下降解析表达式,将所有数据存储至Expr对象中;将表达式转换为多项式,并调用输出方法进行输出。
迭代思考
我认为在解析表达式的任务中,这种方法可以尽可能地减少类与类之间的互相影响与耦合,同时为将来的迭代开发与扩展留出了“接口”,对如新函数,新变量,求导等新增功能,只需要在Factor下新建立对应的类并完成相应的toPoly()方法,并修改部分与Factor相关的内容即可,拓展性相对较高。
具体实现
第一步:字符串处理
对第一步的处理任务,我将PreDeal类作为一个工具类,用来完成对输入字符串Input的预处理工作,包括去空格,去除连续加减号,将乘方展开为连乘等操作,方便后续的进一步token分割与处理。而处理好的字符串dealtInput则进入下一个工具类Lexer,对其中的符号、数字、变量等进行进一步的拆分与处理,把字符串变为一块块有意义的小单元,再对小单元进行遍历处理就更加地方便。
第二步:递归下降
在第二步的递归下降部分中,oolens给出的递归下降的详解让我受益良多,我决定采用公众号给出的伪代码进行修改,即将存储了tokens的Lexer作为数据源传给工具类Parser进行文法解析,最终将所有数据交由一个Expr对象进行管理。
递归下降这种方法让我感到十分巧妙,即将表达式,项,因子视作三层,先“欺骗自己”已经实现了下一层的解析方法,通过调用下一层的解析方法完成本层的解析方法后再去实现下一层的解析方法,如此可以将三层的实现方法递归地实现,这是我之前未尝接触过的。
通过递归下降这种解析方式,可以有效简洁地将Lexer中的数据整理为一棵表达式树,根节点为一个Expr对象,枝节点可以是Expr,Term,Factor三种中任意一种,叶子节点则一定为Num或者Variable,这保证了递归下降一定存在递归终点,不可能无限递归下去。如此便把Lexer中线性存储的token流转化为可以直接进行计算的树状表达式结构。
第三步:多项式转换
我首先实现了Poly和Mono类,作为下一个数据存储与处理的介质。Poly和Mono类的数据结构如下:
$ poly = \sum_{n=1}^{N} mono $
$ mono = coe \cdot x^{exp} $
对于Poly类,在hw1中我考虑其应当具有的方法有:多项式相加相减,多项式相乘。多项式相加即为遍历两个多项式对其中每个单项式进行相加,相减类似,由于单项式相加相减较为简单,我没有采用新增方法的方式来实现。多项式相乘则为遍历两个多项式对每个单项式均进行相乘,我在Mono类中实现了相应的单项式相乘来简化方法复杂度。至此Poly和Mono的计算方法已经实现完毕。
下一步是将Expr的数据转到Poly中。在Expr转Poly的实现方法toPoly()中,我同样使用了类似递归下降的思想,即对Expr,Term,Factor及其扩展对象均实现toPoly()方法进行递归调用,类似于对表达式树的后序遍历。Expr的toPoly()过程实则为对Expr的每个term.toPoly()调用addPoly()方法得到返回的poly,其中term.toPoly()则又要对term的每个factor调用mulPoly()方法,以此类推就实现了数据的迁移与整理。
最后则是多项式的输出,只需要实现一个printPoly()方法和一个printMono()方法,在printPoly()方法中遍历每个mono对其进行printMono()即可。
bug分析
由于太长时间没有写面向对象程序,先导课的训练也十分生疏,导致最后时间十分紧张,没有经过充分的测试便急匆匆的提交了程序,强侧也错的十分惨烈,甚至没有进入互测。
前途一片黑暗啊(绝望)
主要原因出自对左括号与加减号的共同出现的情况没有处理周全,例如(-的符号组合便会出错,我的程序会直接忽视左括号并将后面的右括号也一同忽视,将整体作为表达式来处理。这属于一个相当恶性的bug,同时应当也十分容易发现,可见没有对程序进行充分测试的悲惨后果。
最终我的解决方法为将(-中间插入一个0,即替换为(0-,成功防止了上述错误。这样的修改方式虽然只需要在预处理过程中添加一行代码即可成功修复,但我个人认为这种方法实在是太过低劣,可惜我能力有限实在没能想出其他更加高雅的修改方法,希望在一个学期的学习之后,我能有时间再来看看这个问题,同时更加希望自己能够认真对待自己写的每一份代码,进行充分的考量与测试。
优缺点分析
优点:经过充分思考选择了正确的架构,避免了大规模的重构,大幅度降低了后两次作业的工作量。
缺点:对递归下降的理解的十分不好,导致实现出现误差耗时长的同时强测大规模崩盘,十分可惜。同时对于次方的处理十分低劣,并且存在性能上的不足。
代码规模与复杂度
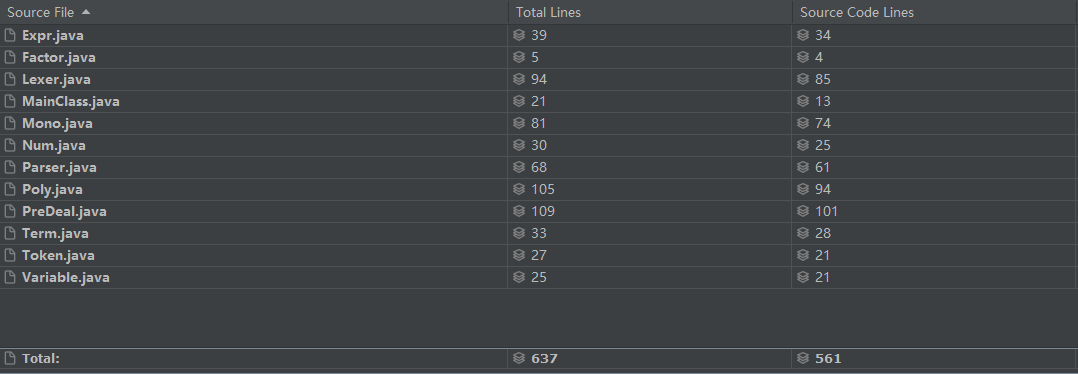
代码规模如下:
方法复杂度如下(只截取了最复杂的一部分方法):
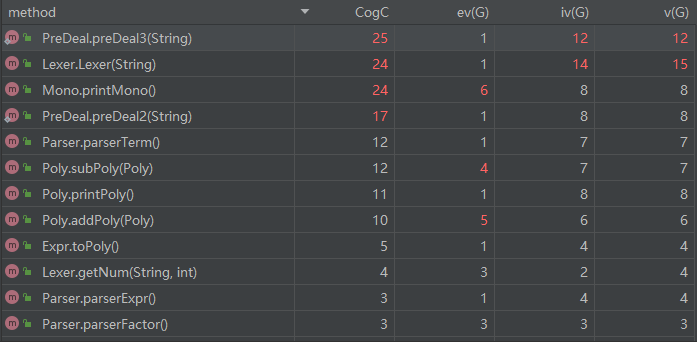
可见预处理部分,分析器部分,打印单项式的方法复杂度严重超标,之后应当对相应处理较多的方法部分做分割,有助于维护代码稳定性和扩展性,总体仍算可观。
第二次作业
简述
第二次作业的类图如下:
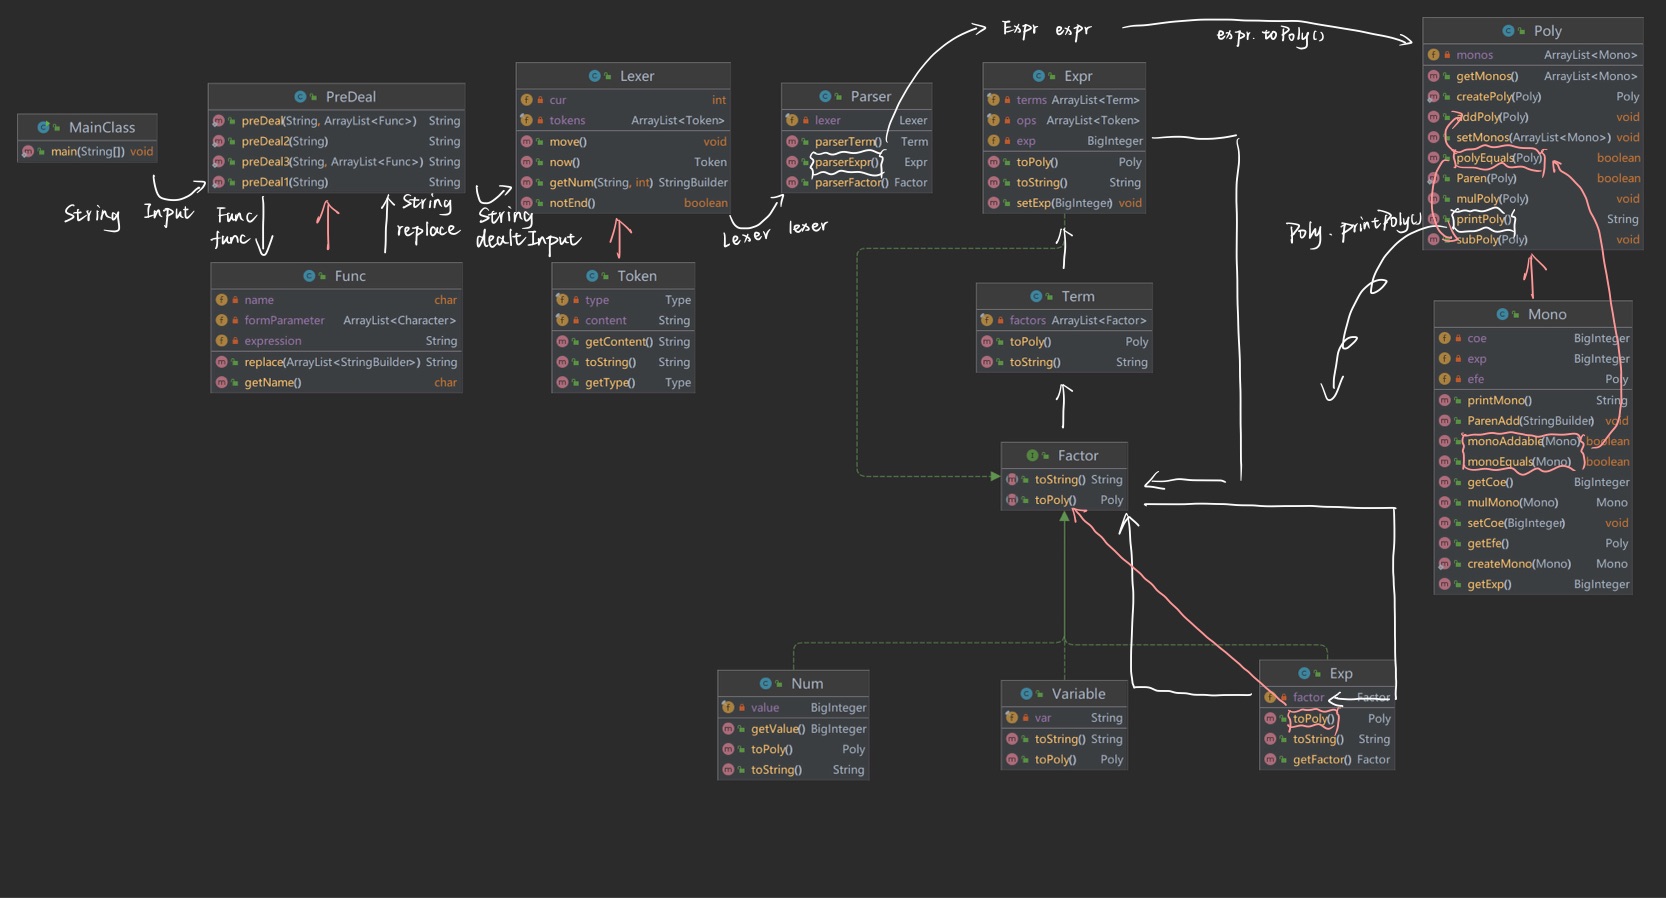
我省略了一些与第一次作业相同的箭头与线条,保留了主要的数据流动通路,新增了第二次作业相关的指示
第二次作业添加了自定义函数(不允许嵌套定义),指数函数和括号嵌套。得益于第一次作业较为成功的架构,第二次作业相对顺利。
迭代思考
为了能够更好地处理嵌套括号,将乘方展开为多个连乘的形式显然已经不再合适,我最一开始采用了当读入乘方符号时,就将term中保存factor的容器的最后一项复制多次并存入容器,这种方法虽然比字符串处理的方式优越一些,但实质上并未做出改动,仍旧处于一个后化简先计算的处理过程,这导致我的程序无法处理例如强测第二个测试点中x的高次嵌套。
对于乘方的处理方法,我最终采用了,在Expr类中添加一个exp的属性,表示此表达式整体的次数。在Expr的toPoly()方法中,我会判断表达式的次数,若大于1,则进行mulPoly()方法,真正实现了先化简后计算。使用这样高性能且较为优雅的方式修改了这个架构问题,这也算满足了我的一点点强迫症吧(
具体实现
自定义函数
我选择新增加一个自定义函数类Func类,用来保存函数名,函数形参和对应的函数表达式,在预处理过程中将函数直接进行替换带入。
具体分为两步,第一步是找到函数及其几个参数。这里我采用栈的数据结构思想,对函数传参进行解析。
函数表达式内部的参数都使用,进行分割,而参数中可能存在函数,参数中的函数的传参也包含,,这就提高了函数参数分析的难度。因此我对函数部分的括号着重考虑,读入左括号时进行入栈,读入右括号时将栈顶的左括号出栈,由此分析,只有当栈的大小为1时,读入的参数才是最外层函数的参数,此时读入到,符号,就表示最外层函数的一个参数已经读取完毕。重复以上操作,最终当栈的大小为0时,证明此函数解析完毕,可以进行替换。
第二步则是替换部分,对应之前存入的形参列表进行同位替换即可。
需要注意的地方就是如下例子:
1
f(y, x) = y^2 + x
f(x, 1)
这里形参列表y在x的前面,替换时会先替换y再替换x,第一步得到x^2 + x,第二步会将所有的x均替换为1,即最后结果为2,显然是不正确的。为了避免以上情况,在替换时需要先进行x的参数替换,再进行其他变量的参数替换。
指数函数
在指导书的文法规定中,指数函数属于Factor的一部分,因此我选择新建立一个Exp类,用来保存指数函数相关的数据,其中包含一个Factor的属性,用来描述指数。
作为Factor的一部分,其需要实现接口中的所有方法,即用来调试的toString()方法和用来转换多项式的toPoly()方法。其中toPoly()方法只需要对其Factor属性调用toPoly()方法即可,十分的简单。
通过这次作业,我认识到接口的方便之处。接口既能体现规范作用,用于提醒程序员新增子类时需要实现哪些共同行为的方法,又能体现向上兼容作用,即屏蔽子类的各种各样的差异,向上只展现共同行为,极大地减少了耦合性,提高了程序可扩展性。
Poly类和Mono类的改动
在这次迭代过后,Mono类作为最小单元需要进行一些改动,即添加了指数函数项:
$ mono = coe \cdot x^{exp} \cdot e^{factor} $
而Poly类仍旧是几个mono的加和:
$ poly = \sum_{n=1}^{N} mono $
其中mulPoly()方法可以沿用,因为两个mono无论什么情况都是可以进行相乘的,较大的改动是addPoly()和subPoly(),其中需要判断两个mono是否可以相加或者相减。
为此,我添加了monoAddable(),monoEqual()和polyEqual()三个方法用来实现以上功能。两个单项式可以相加当且仅当x的指数相同并且e的指数多项式完全相同,因此需要调用monoEqual()和polyEqual()方法,这两个方法也是递归实现的。
令我较为苦恼的是,判断单项式和多项式相等的方法实现起来不是很简洁,希望能对此进行一部分的改进与处理
同时,我添加了Paren()方法,用来判断输出指数函数时是否需要添加一个括号,不难看出,指数函数输出时不添加括号的情况只有常数和x,其余情况全部需要添加括号。
为了应对随处可见的深浅拷贝的“定时炸弹”,我使用递归方法建立了深拷贝方法createMono()和createPoly()方法,只需要传入待拷贝的引用,即可返回一个深拷贝的引用,对我的代码维护与稳定性扩展起到了极大的帮助。
bug分析
唉!
第二次作业虽然较为复杂,但在熟练之后,实现起来技术难点不算太多,也成功通过了强测。互测中被发现的bug存在于printMono()中,具体为当x的系数为0,e的指数为0且整体系数不为0时,输出会略去中间的*号,变为诸如-9exp(0)这样的存在。对于这种粗心至极的bug,只能是扼腕而叹,赶紧修复,希望下次不要再犯才好!
优化
本次做出的优化十分简单,仅考虑了单项式合并与exp(0)的简化,即使是这样也让我汗流浃背,毕竟我还在正确性上挣扎(
真是得努力了
优缺点分析
优点:添加了相应功能后整体结构仍旧相对简洁,有潜力应对更多更复杂的迭代开发
缺点:一些方法复杂度过高,仍旧有很多面向过程的风格存在,并且不是很好改动,十分不符合面向对象的思维模式
代码规模与复杂度
代码规模如下:
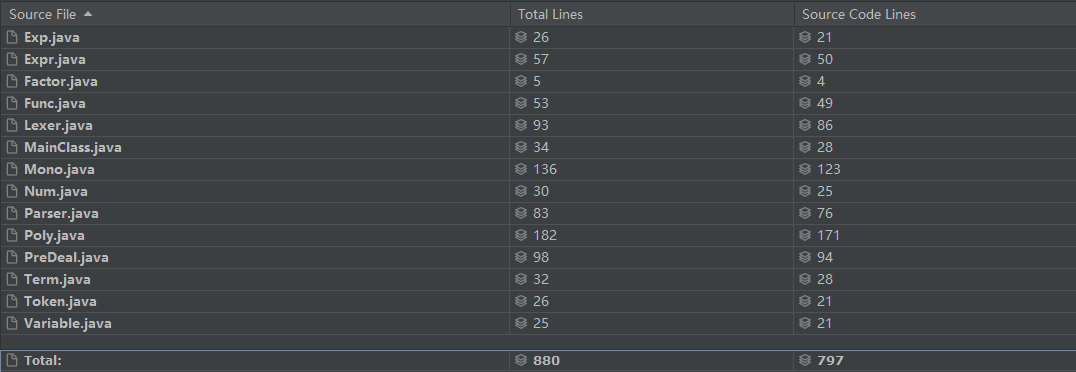
方法复杂度如下(只截取了最复杂的一部分方法):
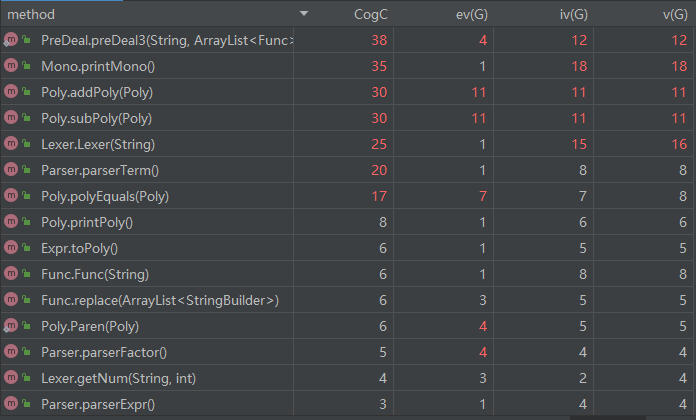
新增的复杂度超标的方法为poly.addPoly(),poly.polyEquals()和Parser.parserTerm(),前中是由于之前提到相应功能的添加而超标,后则是因为对Expr中指数的处理而超标,暂未想到合理轻巧的解决方法
第三次作业
简述
第三次作业的类图如下:
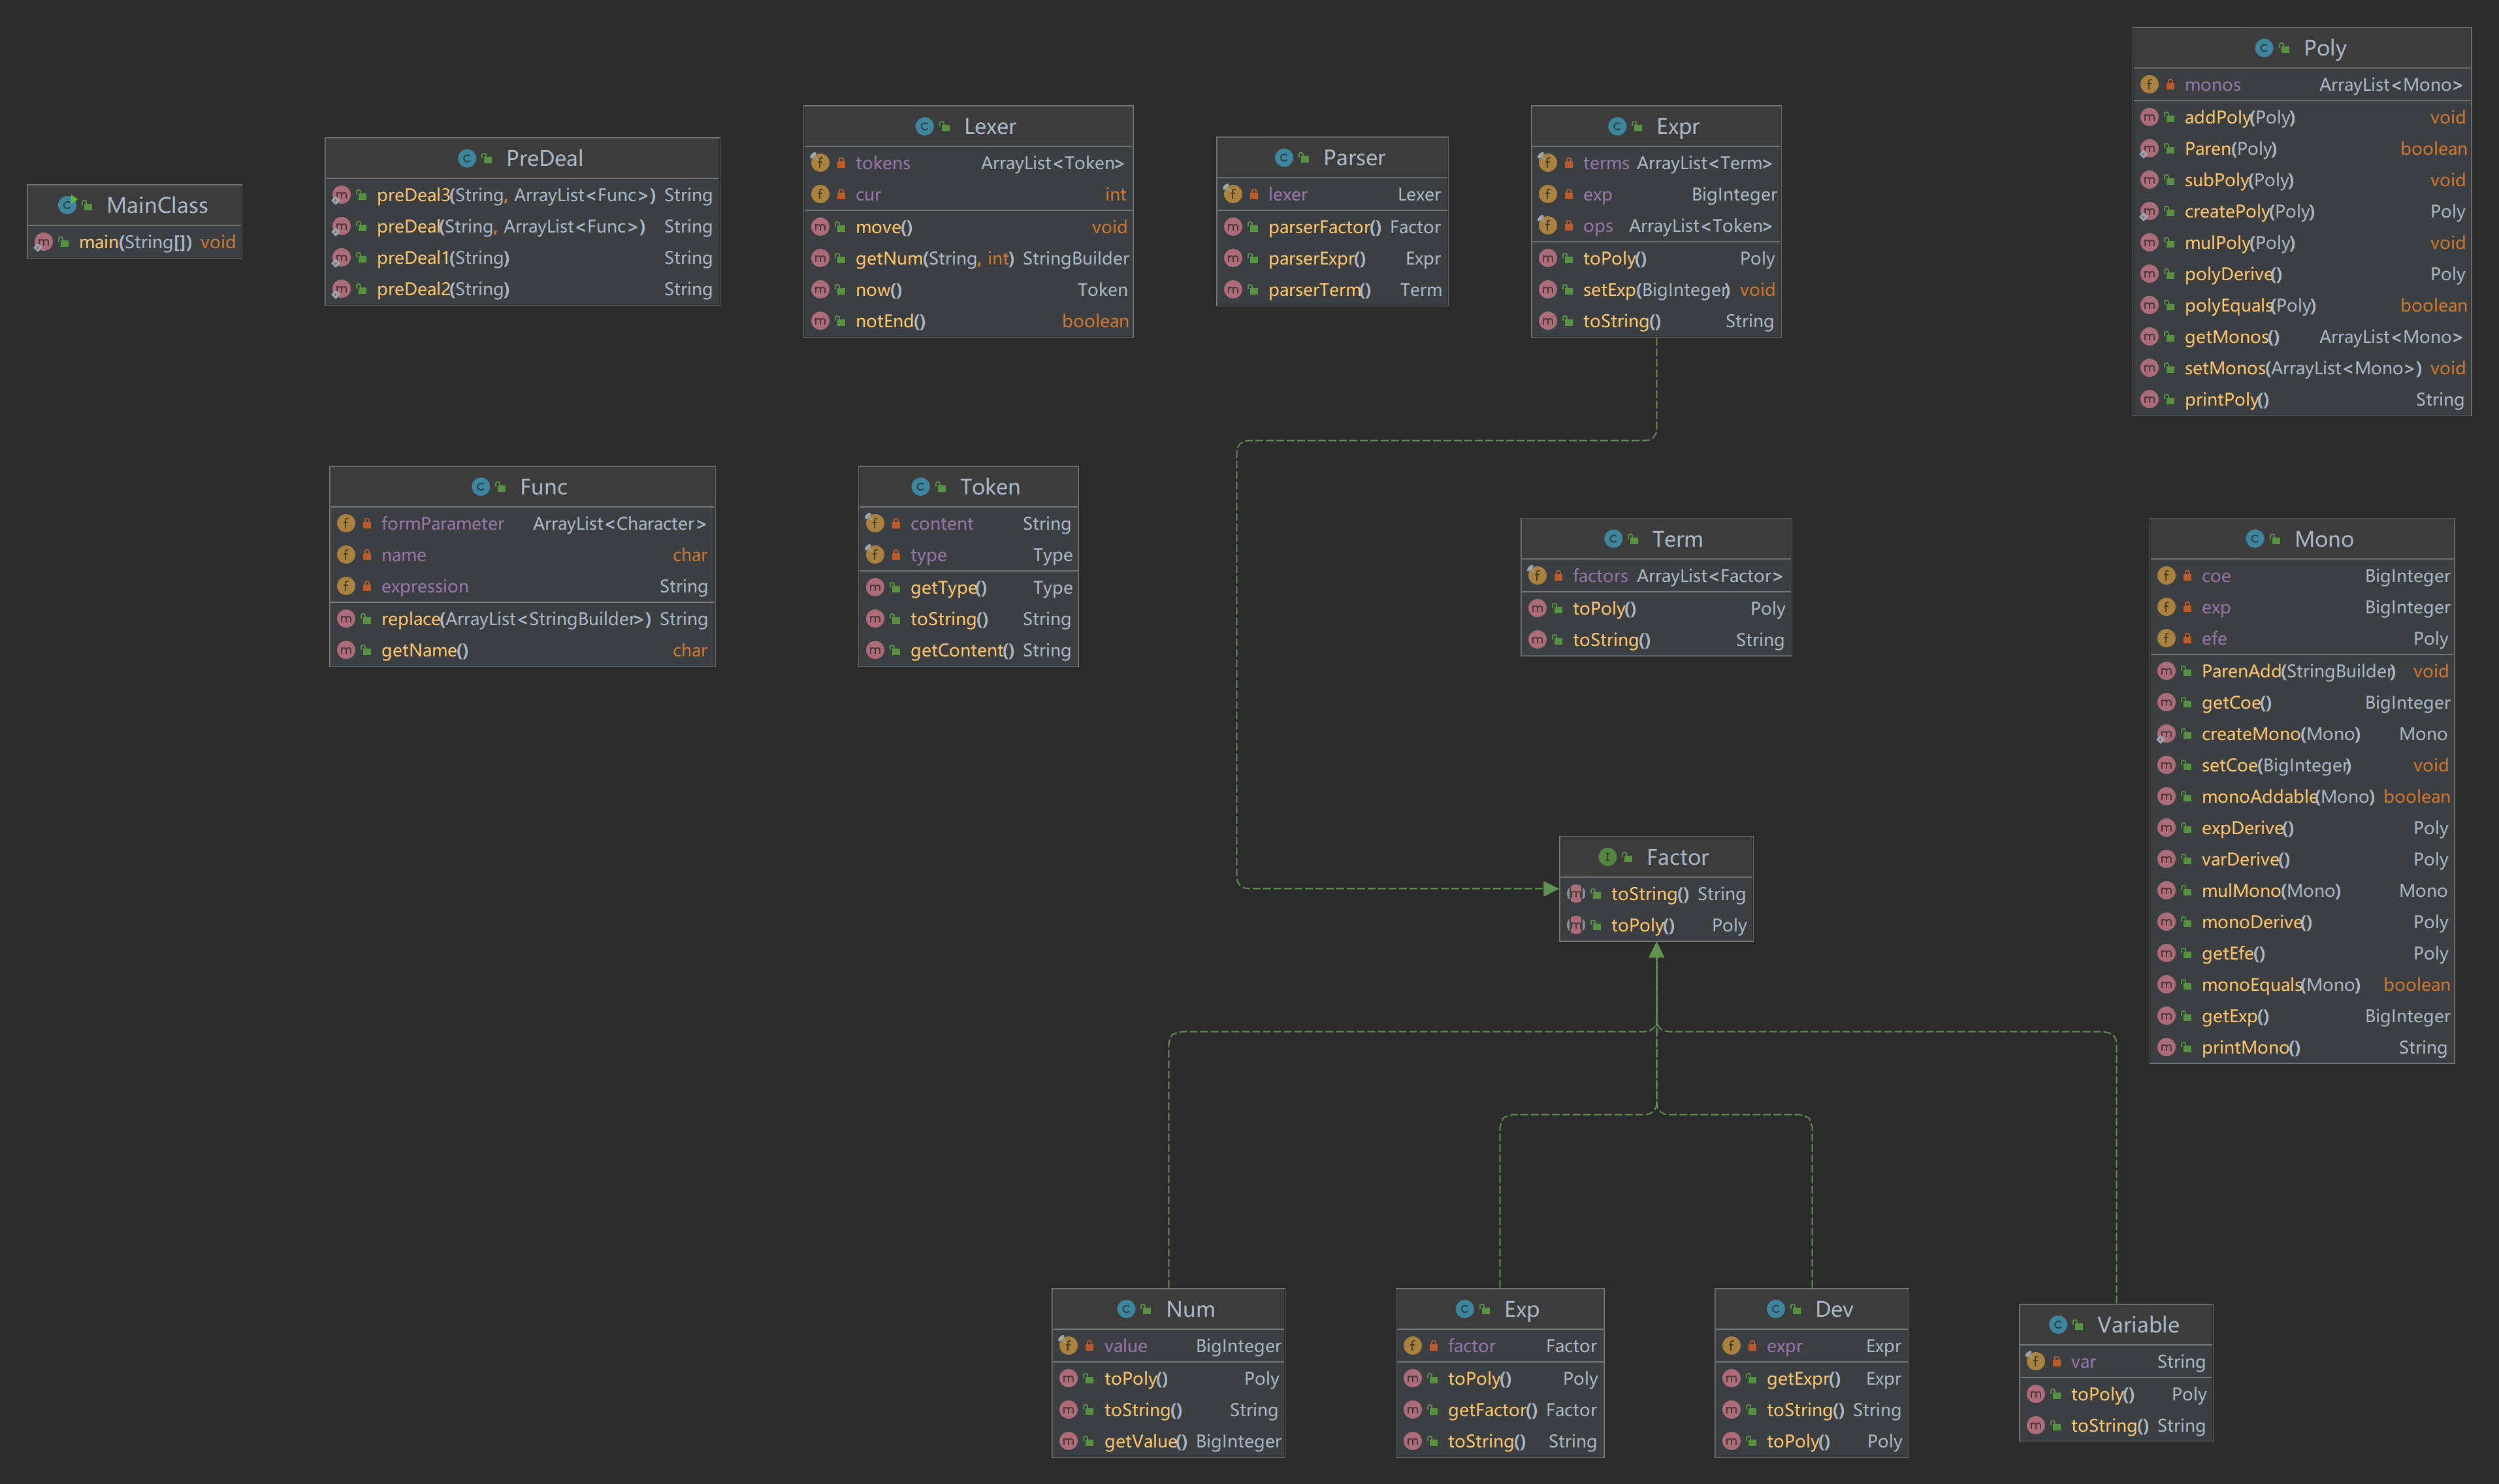
第三次作业添加了求导与自定义函数(嵌套定义)
迭代思考
由于第二次作业中的字符串替换已经实现了嵌套定义的功能,这里不再赘述。求导部分与指数函数部分类似,由指导书中给出的文法解析将新建求导类安排为Factor的子类,实现相应方法即可实现,难度不算太大。
具体实现
新建求导类
在接口Factor下实现了Dev类,用来管理求导相关式子的数据。只需实现Factor中的两个方法就可以与之前的程序对接,其中toPoly()中通过调用polyDerive()实现了求导的运算。
Poly类和Mono类的改动
Poly类和Mono类分别实现了相应的求导方法,最终求导操作是在Mono类中进行实现的。实现难度也不高,对于一个单项式,需要求导的只有两部分:x和exp()部分,分别对这两个部分实现一个求导方法,并进行结合即可。
bug分析
唉唉唉!
强测没有出现问题,但互测中被抓住了函数表达式没有进行预处理的问题,又是比较笨的问题。
修复也只需要一行,即添加一行预处理即可。
代码规模与复杂度
代码规模如下:
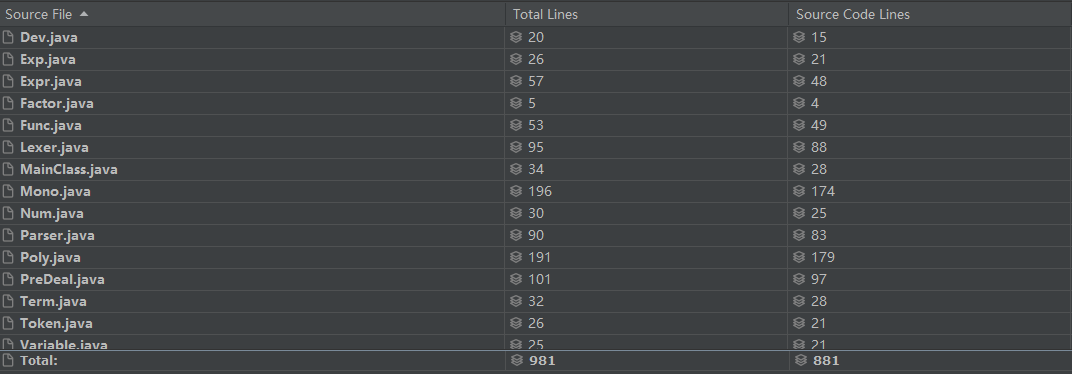
方法复杂度如下(只截取了最复杂的一部分方法):
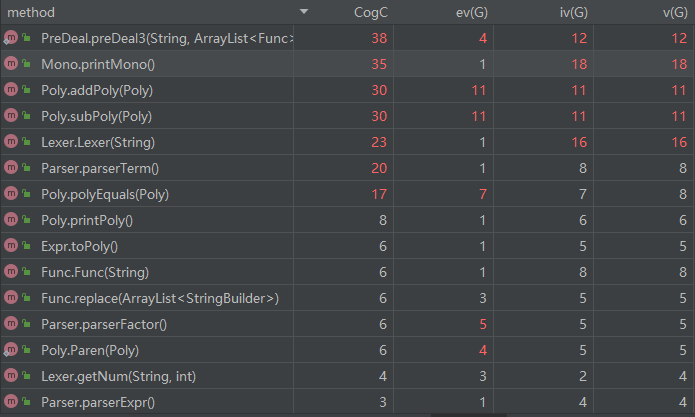
复杂度超标方法没有增加,仍需要解决老问题
架构可能扩展分析
如加入三角函数,加入广义指数函数。
前者的实现需要在Factor类中新增三角函数类,同时在mono项中添加保存三角函数的两个容器,并实现相应的化简方法,与指数函数的实现类似。
后者则需要对已实现的Exp类进行修改,添加底数字段,并对判断单项式多项式相等和可加的方法等进行修改。
一个优秀的架构应当面对可能存在的各种修改而临危不惧,不需要进行太大的变动就能适应变化。但对于初学者,重构势在必行,只有不断地进行重构与迭代开发,在其中体会面向对象思想,才能真正学懂学会
心得体会与建议
第一次作业可能是由于手生,个人感觉相比后两次作业的难度简直是一个天上一个地下,光是理清架构就花了很久的时间,我也知道这样的事情不可避免,需要在一次次困难中磨练自己,学会面向对象知识的同时还要学会如何安排时间。你可少玩会吧
建议方面,希望能够平衡一下各次作业难度,同时对入门级的第一次作业给出更多的指导,毕竟如果在第一次作业就放弃的话,后面的作业自然不可能顺利完成
相关推荐
电梯调度java程序 buaa oo课程
程序能够模拟多部电梯调度,通过输入指令进行运算。可以处理电梯内请求,电梯外请求,顺路捎带,加入停止电梯。用java实现的,内有java工程,还有一份输入输出样例。
elevator3.zip_java_java编程_北航oo_北航电梯_电梯
北航第三次oo作业,在原来傻瓜电梯的基础上增加捎带功能
毕设&课设:自动测评 for BUAA Object-Oriented(OO) 北航 面向对象设计与构造 jav.zip
经导师指导并认可通过的大作业设计项目源码,适用人群:计算机,电子信息工程、数学等专业的大学生课程设计、期末大作业或毕业设计,作为“参考资料”使用。
毕设&课设:2017级北航计算机学院面向对象设计与构造作业.zip
经导师指导并认可通过的大作业设计项目源码,适用人群:计算机,电子信息工程、数学等专业的大学生课程设计、期末大作业或毕业设计,作为“参考资料”使用。
从注意力到行动 pdf Agent
从注意力到行动 pdf




