


301
社区成员
 发帖
 与我相关
 我的任务

 分享
输入一个表达式,包含+, -, *, number, variable, ). 括号仅有一层。要求输出展开后的表达式。
在hw1的基础上,添加如下要求:
在hw2基础上,新增:
整体上就是处理表达式。在ds课程中写过用栈和后缀表达式实现的计算器。但是,在扩展上很麻烦。这里,采用先构造抽象表达式树(AST),之后就是对这棵树的各种处理了。
共有14个类,72个方法。由分析工具(idea插件Metrics)可以看出,FuncSets.replaceFuncInExpr(String), Lexer.Lexer(String), Parser.parserFactor(), Unit.minExp(Poly), Unit.simplify(StringBuilder), Poly.toString() 复杂度较高。其中,lexer, parer用于解析,难以避免复杂度较高;而minExp, simplify用于优化,也会复杂度较高。而如果使用了HashMap实现自动合并同类项,则应该可以有效降低后三者的复杂度(因为为了在过程中不断合并同类项而大量调用了后三种方法)
| method | Cogc | ev(G) | 方法规模 |
|---|---|---|---|
| ExpFactor.derive() | 2.0 | 2.0 | 14 |
| ExpFactor.ExpFactor(Factor, BigInteger) | 0.0 | 1.0 | 4 |
| ExpFactor.toPoly() | 0.0 | 1.0 | 8 |
| Expr.addTerm(Term) | 0.0 | 1.0 | 3 |
| Expr.derive() | 5.0 | 3.0 | 22 |
| Expr.Expr(BigInteger) | 0.0 | 1.0 | 4 |
| Expr.Expr(Expr, BigInteger) | 0.0 | 1.0 | 4 |
| Expr.Expr(String) | 0.0 | 1.0 | 5 |
| Expr.mergeExpr(Expr) | 0.0 | 1.0 | 3 |
| Expr.setPower(BigInteger) | 0.0 | 1.0 | 3 |
| Expr.toPoly() | 5.0 | 2.0 | 19 |
| FuncSets.addFunc(String) | 5.0 | 3.0 | |
| FuncSets.callFunc(String, String[]) | 5.0 | 1.0 | |
| FuncSets.FuncSets() | 0.0 | 1.0 | 19 |
| FuncSets.replaceFuncInExpr(String) | ==16.0== | ==7.0== | 29 |
| Lexer.Lexer(String) | ==20.0== | ==13.0== | 4 |
| Lexer.move() | 0.0 | 1.0 | 27 |
| Lexer.notEnd() | 0.0 | 1.0 | 45 |
| Lexer.now() | 0.0 | 1.0 | 3 |
| Lexer.printTokens() | 1.0 | 1.0 | 3 |
| Main.input() | 1.0 | 1.0 | 3 |
| Main.main(String[]) | 0.0 | 1.0 | 5 |
| Number.derive() | 0.0 | 1.0 | 18 |
| Number.Number(BigInteger) | 0.0 | 1.0 | 14 |
| Number.Number(String) | 0.0 | 1.0 | 4 |
| Number.toPoly() | 0.0 | 1.0 | 3 |
| Parser.getPower() | 4.0 | 1.0 | 4 |
| Parser.Parser(Lexer) | 0.0 | 1.0 | 9 |
| Parser.parserExpr() | 8.0 | 1.0 | 12 |
| Parser.parserFactor() | ==16.0== | 5.0 | 3 |
| Parser.parserTerm(int) | 2.0 | 1.0 | 22 |
| Poly.addPoly(Poly) | 2.0 | 2.0 | 54 |
| Poly.addUnit(Unit) | 5.0 | 3.0 | 9 |
| Poly.equals(Object) | 0.0 | 1.0 | 10 |
| Poly.getUnits() | 0.0 | 1.0 | 19 |
| Poly.hashCode() | 0.0 | 1.0 | 7 |
| Poly.mulConst(BigInteger) | 1.0 | 1.0 | 3 |
| Poly.mulPoly(Poly) | 2.0 | 2.0 | 4 |
| Poly.mulUnit(Unit) | 1.0 | 1.0 | 5 |
| Poly.negate() | 1.0 | 1.0 | 10 |
| Poly.Poly() | 0.0 | 1.0 | 11 |
| Poly.Poly(ArrayList) | 1.0 | 1.0 | 7 |
| Poly.toString() | ==12.0== | 6.0 | 3 |
| Processer.delSpaces() | 0.0 | 1.0 | 8 |
| Processer.delZeros() | 6.0 | 3.0 | 25 |
| Processer.mergeAddSub() | ==10.0== | 6.0 | 3 |
| Processer.processAllInOne() | 0.0 | 1.0 | 13 |
| Processer.Processer(String) | 0.0 | 1.0 | 20 |
| Term.addFactor(Factor) | 0.0 | 1.0 | 6 |
| Term.derive() | 3.0 | 1.0 | 3 |
| Term.getFactors() | 0.0 | 1.0 | 3 |
| Term.Term(int) | 0.0 | 1.0 | 14 |
| Term.toPoly() | 2.0 | 1.0 | 3 |
| Token.getContent() | 0.0 | 1.0 | 4 |
| Token.getType() | 0.0 | 1.0 | 11 |
| Token.Token(Type, String) | 0.0 | 1.0 | 3 |
| Unit.canBeMerged(Unit) | 4.0 | 1.0 | 3 |
| Unit.equals(Object) | 1.0 | 1.0 | 4 |
| Unit.getCoe() | 0.0 | 1.0 | 7 |
| Unit.getExpContent() | 0.0 | 1.0 | 6 |
| Unit.getPower() | 0.0 | 1.0 | 3 |
| Unit.hashCode() | 0.0 | 1.0 | 3 |
| Unit.minExp(Poly) | ==30.0== | 2.0 | 3 |
| Unit.setCoe(BigInteger) | 0.0 | 1.0 | 3 |
| Unit.simplify(StringBuilder) | ==15.0== | 1.0 | 48 |
| Unit.toString() | 4.0 | 3.0 | 3 |
| Unit.Unit(Poly, BigInteger, BigInteger) | 0.0 | 1.0 | 29 |
| Variable.derive() | 2.0 | 2.0 | 18 |
| Variable.toPoly() | 0.0 | 1.0 | 5 |
| Variable.Variable(BigInteger, String) | 0.0 | 1.0 | 12 |
| Total | 192.0 | 118.0 | 9 |
| Average | 2.742857142857143 | 1.6857142857142857 | 4 |
ev(G)(控制流程数), Cogc(圈复杂度), CBO (耦合度)
| class | Cogc | ev(G) | 类规模 | CBO |
|---|---|---|---|---|
| ExpFactor | 1.3333333333333333 | 2.0 | 30 | 6 |
| Expr | 1.875 | 5.0 | 67 | 6 |
| FuncSets | ==4.25== | 7.0 | 84 | 2 |
| Lexer | 3.6 | 13.0 | 63 | 4 |
| Main | 1.5 | 2.0 | 34 | 6 |
| Number | 1.0 | 1.0 | 23 | 7 |
| Parser | ==4.2== | 10.0 | ==103== | 10 |
| Poly | 2.4166666666666665 | 7.0 | ==115== | 8 |
| Processer | 2.4 | 6.0 | 48 | 1 |
| Term | 1.8 | 3.0 | 39 | 6 |
| Token | 1.0 | 1.0 | 14 | 3 |
| Token.Type | 3 | 3 | ||
| Unit | 2.727272727272727 | 9.0 | ==133== | 4 |
| Variable | 1.3333333333333333 | 2.0 | 29 | 6 |
| Total | 785 | |||
| Average | 2.414285714285714 | 5.230769230769231 | 56.07143 | 5.142857 |
观察类指标可以发现,类的圈复杂度较为均匀,说明类之间的任务分配较好。
但是,CBO偏高(尤其是Parsert与Poly),说明耦合度偏高。在设计上以后应当注意降低耦合度。
其实这次比较保守,采用了比较经典的架构(实验代码提供的架构思路)。但是,事后再想想,这个架构真的很好吗?恐怕未必。
实验提供这样的架构,这个架构确实很稳妥,但是感觉灵活性一般,可拓展性不能说很高那种。每次都要修改上不少。再想想,实验的要求比较少,所以这个架构完全应付的来;然而面向作业,的确还有不少更为优秀的整体架构与局部设计。
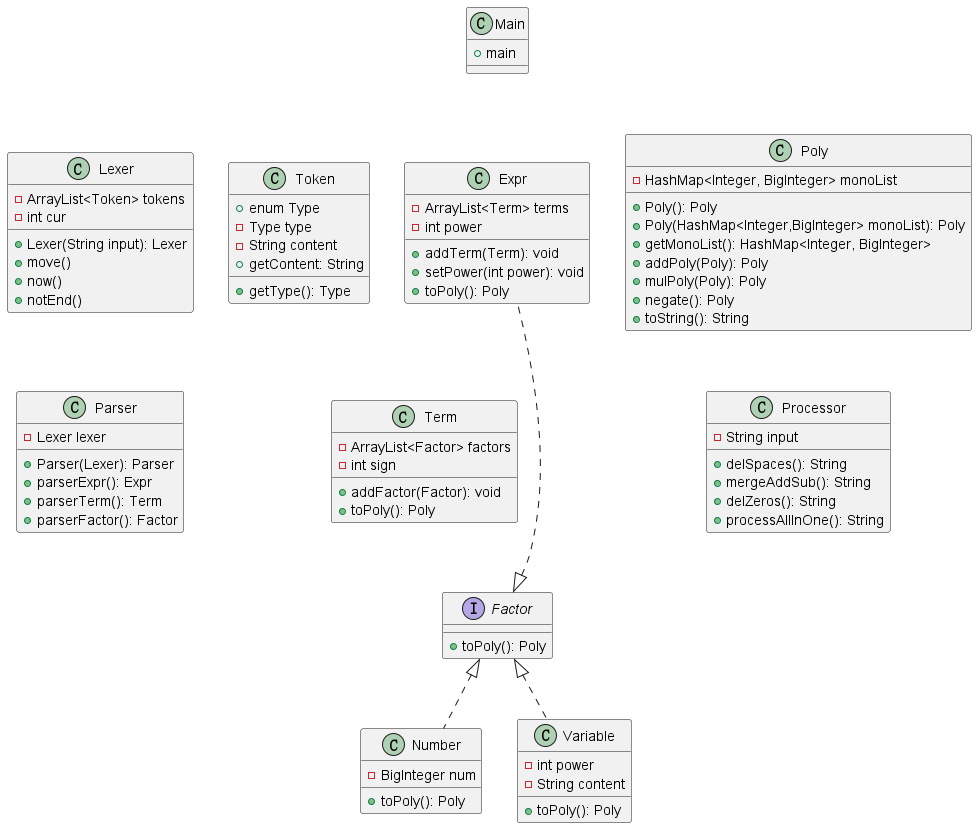
这次作业我没有重构。下面先从第一次作业开始,讲这个架构如何建立起来,之后再由每次迭代来介绍架构如何完善。
首先,输入的是一个字符串。使用Lexer对其进行解析,得到一个tokenlist;
然后,使用Parser建立起一棵表达式树;
最后,通过Poly实现对表达式树的展开。
字符串是不太好处理的,所以我们想先把它搞成一个一个的基本单元——token,这个使用Lexer解析即可,比较容易。但是一定要想清楚格式,否则细节很容易出bug(比如,lexer.move()到底move几次?)
public class Lexer {
    private final ArrayList<Token> tokens = new ArrayList<>();
    private int cur = 0;

    public Lexer(String input)

    public void move()

    public Token now()

    public boolean notEnd()
}
之后,我们用Parser递归地生成那棵树
class Parser {
    -Lexer lexer
    +Parser(Lexer): Parser
    +parserExpr(): Expr
    +parserTerm(): Term
    +parserFactor(): Factor
}
具体如何递归下降呢?
其实就是每次只处理一层,可以认为下一层之后的东西已经处理好了(其实就是递归函数的处理思想)。然后,上一层就可以直接用下一层进行构建。
具体举一个例子,比如
public Term parserTerm(int sign) {
    Term term = new Term(sign);
    term.addFactor((parserFactor()));
    while (lexer.notEnd() && lexer.now().getType() == Token.Type.MUL) {
        lexer.move();
        term.addFactor(parserFactor());
    }
    return term;
}
这里,我们认为factor已经解析好了。于是,只需要按照Term的文法进行解析。
其实,可以发现,给出的形式化表述本身就是只关注两层的关系的,也就是本身就是“递归下降”的。
最终的表达式的形式是:$$ Expr = \sum a_ix^{n_i}$$
我们发现,真正有意义的就是系数和指数。直接一个HashMap就可以对应起来。
更关键的,HashMap实现了自动合并同类项。
public class Poly {

    private HashMap<Integer, BigInteger> monoList;

    public Poly addPoly(Poly a) {
    }

    public Poly mulPoly(Poly a) {
    }

    public Poly negate() {
    }
}
建立Poly类之后,由于是要把那棵树展开,所以,还需要在树中的每个node上都加上toPoly()方法。这里,toPoly又是一次“递归下降”,从顶层调用下一层,层层下去。
先看看hw2迭代增加了什么:
在hw1的基础上,添加如下要求:
括号可能有多层(expr嵌套)
自定义函数因子
指数函数因子
首先,递归下降已经天然实现了解决括号嵌套问题(由于AST想长多深长多深);
然后,对于自定义函数因子,我采用了一个有点偷懒的方法——直接在字符串那儿进行替换。
最后,对于指数函数因子,其实和别的没啥区别,都是lexer里面加一下,parserFactor里加一下,新建一个类ExpFactor进行解析即可。
在hw2基础上,新增:
对于前者,还是在字符串层级直接替换。这里需要注意一点,就是x、y、z的顺序很容易换错。我们希望对于一个形参,只换一次。那么,可以从右向左遍历字符串,这样都不需要移动那个“指针”,非常巧妙。
对于求导因子,我也是仿照了实验代码,给每一层都添加了derive()方法,从而自顶而下递归下降式地实现求导。
第一次作业
第三次作业
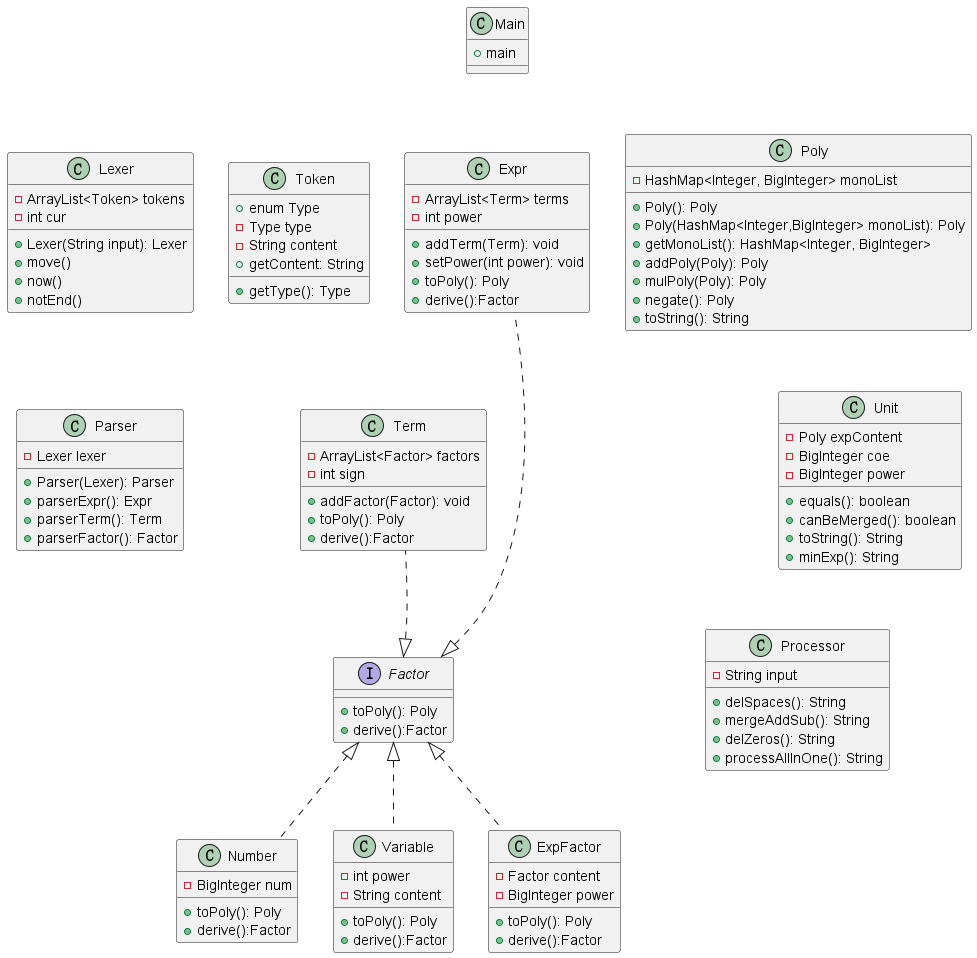
可以发现,hw1到hw3只增加了两个类,架构没有多大变化。改变了一些类的关系(主要是Term,这样实现了在求导时的简化处理,有效减少了嵌套层数)。这样看来,总体的架构其实还不错。
但是,事实上,在每次作业中修改的都很多。主要都是在类内有大量修改。由上面的代码分析可以看出,类之间的耦合度还是比较高的。所以造成了类内的大量修改。具体如何降低类内耦合度还不是很清楚T_T,后面要多看看设计模式相关。
最经典也最常被考虑到的就是三角函数sin,cos了。这个,其实只要
这次在最后一次作业出了bug,原因在于优化exp的时候把负数提了出来(群里早就有人说过这个问题了,我也看到了这条消息,结果当时没太懂,之后忘了T_T)
其实原因还是没有仔仔细细搞懂指导书、读清形式化表述。荣老师说写程序最重要的就是甲方的需求,的确,下次再写,要能做到把题目条件与表述默写出来。
这次作业主要还是依赖评测机打,当然,效果一般般……毕竟,大家大多在交上去之前就用评测机测了很多了……
另外,还用了自己写的时候感觉易错的点和别人出的一些bug,这些样例虽然简单,但是特别有攻击性。
第一次的优化都很容易,需要考虑清楚并且层次清晰。
0,则最终结果为0,+-1,则可以省略系数0,则最终结果只输出系数1,则指数部分可以省略2,则x**2可以化简为x*x-第二次、第三次的优化是一样的。当然,我没有做优化仙人的优化,因为程序时间效率本身偏低(由于没有使用HashMap实现自动合并同类项),所以也估计支持不了过高的优化。
这一单元最大的心得体会就是要独立思考,深入思考。只有真正自己思考了,自己设计架构,自己分析程序,才能对“设计与构造”有所体会。
在写第一单元时,总是感觉代码不少地方很ugly,难以拓展等等,但是又不太清楚到底应该怎么做。
感觉可以给出一些在架构、模式上的建议,可以更好地训练“设计与构造”?


