


301
社区成员
 发帖
 与我相关
 我的任务

 分享
在OO课程之前,我并没有参加OOpre课程,因此这是我第一次接触OO编程,其中许多地方架构混乱,解耦合不完善,因此本篇博客仅作为交流学习,希望大家能在各自的博客中获得灵感,共同进步。
第一次作业要为第一单元打好基础,在设计架构时尽可能考虑到之后会出现的新需求,因此保证第一次作业架构的简洁性和拓展性是相对重要的。我在第一次作业中,考虑到了可能会变和可能不变两种类型。
首先是表达式的基本结构,无论其中内容发生怎样的改变,无论是否会增加新的函数和变量,表达式的层次结构是不会变的。
表达式总可以表达为多个不同项的和,而项也可以表达为多个不同因子的积,这是指导书中提示我们的内容,也是一个表达式的基本属性。
当做到第三次作业时,再回看第一次作业的架构,即使后来出现了指数和求导两种因子,但总的来说,既可以解释为一种特殊的因子,其中包含表达式,也可以解释为一个新的表达式,而具有不同的属性。在具体实现中,我倾向于将指数看作因子,而导数看作表达式。
综合以上,表达式的结构是固定的,因此我们在设计数据结构时的架构也是固定的,即以树结构形成表达式树。
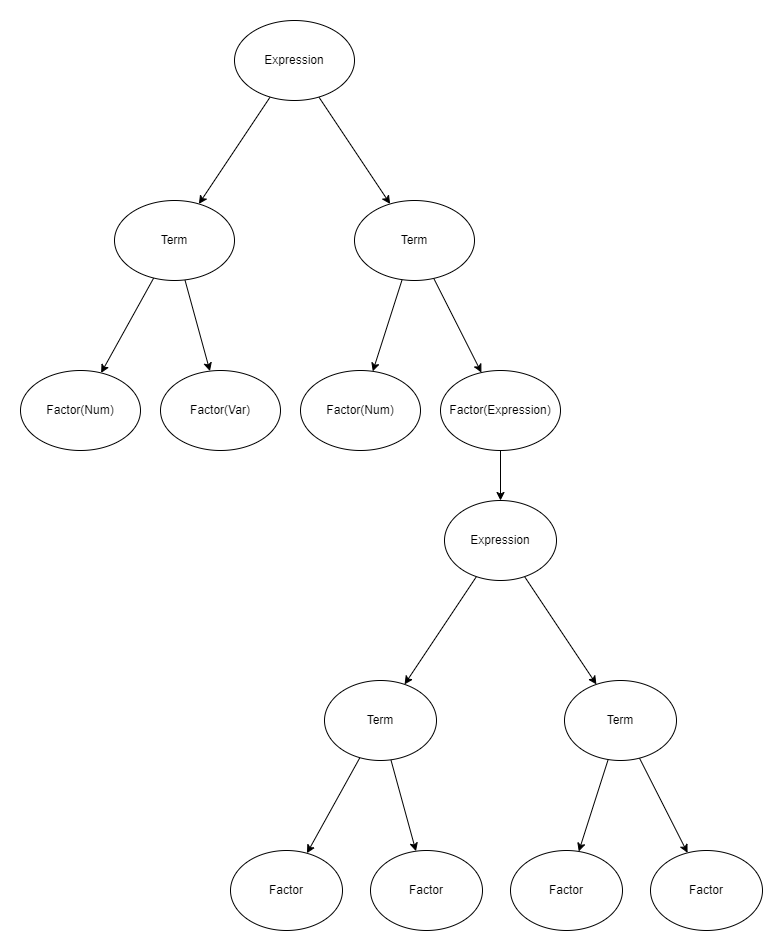
树可以按照形式化表示的内容来设计,其中主要分为表达式,项,因子三个层次,在表达式因子中还可以再保存下一层的表达式,因此形成一个无限延伸的树状结构,层次化向下伸展。
具体结构如图所示:
在指导书中有如下描述:
读入一个包含加、减、乘、乘方以及括号(其中括号的深度至多为 1 层)的单变量表达式,输出恒等变形展开所有括号后的表达式。
可能要出现其他的计算方式,如何面对新增的计算方式对结构的影响极其重要?
可能会出现多层括号嵌套,如何理解括号,如何将括号的深度拓展到无限层?
由自变量 x,指数符号 ^ 和指数组成,指数为一个非负带符号整数,如:x ^ +2,x ^ 02,x ^ 2
可能出现多重不同的变量,如何处理不同的变量,以及如果出现多字母变量?
可能出现负指数?
用一对小括号包裹起来的表达式,可以带指数,且指数为一个非负带符号整数
依然是这个问题,但如果出现负数能否化简
包括上面的数均为整数,之后是否会出现小数,包括数字和指数部分,此时如何表示小数,能否用分数形式表示?
整数的范围并不一定在int或long范围内
已明显表明,因此要涉及到其他的数字保存方法
综合以上内容,我们已经对于未来可能出现的情况作了一个简单的预期,并为保证架构的拓展性,因此要考虑这些未来可能的发展,尽可能完善架构。
除此之外,还有性能判定,因此程序中不仅要考虑输出答案的正确性,还要尽可能考虑程序的性能,如何使程序能够化简?
首先放上大致的类图:
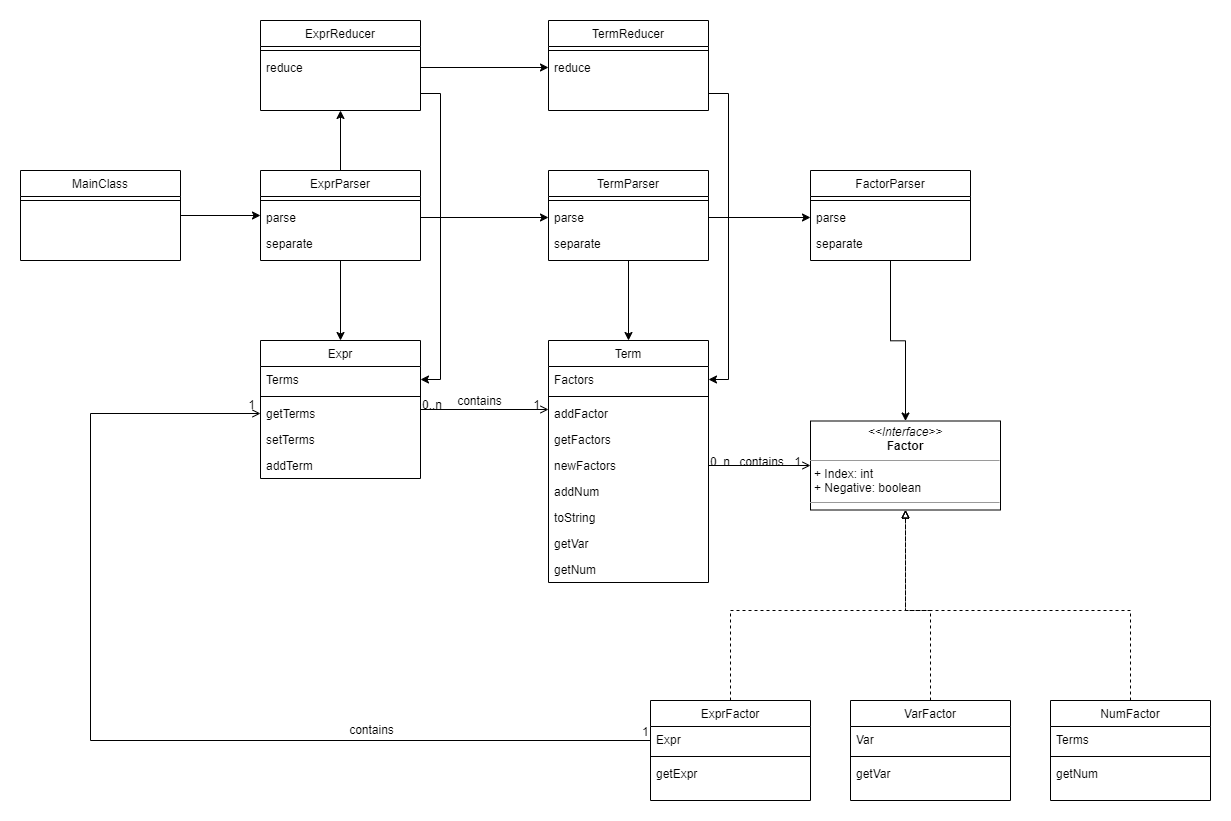
到了具体实现的部分后,就发现程序实际上可以分为几个大块,以程序的大致运行流程为序:
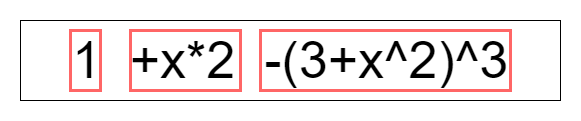
首先将表达式根据加减号拆分成为一个个独立的项
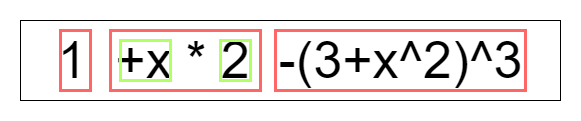
再次将表达式根据乘号拆分为一个个独立的因子
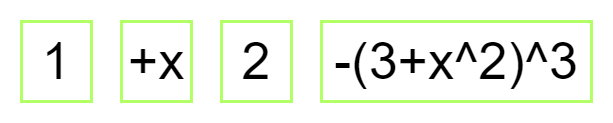
根据因子中的数据类型不同,将其分为不同的因子保存,分别是:
这些因子都具有相同的特征,例如正负,指数,因此可以将这些属性作为接口的属性,规范因子类的行为
除此之外,在表达式因子中,在可以解释为一个新的表达式,而将外部的符号和指数作为因子的特性,不考虑到其中
再一切表达式都被解析完毕之后,应当可以建立一个完整的表达式树,其中由表达式和项以下,管理着许多包含特定数值的因子
化简和建树都带有递归的特增,具体来说细节的话,建树是由一个完整地树根,一步步开枝散叶,建立出因子作为叶节点
而化简则是由外围的因子作为起点,一步步回到最初的那一棵最简表达式树,那么这个过程显而易见,可以参考DFS作为算法设计
项化简的过程大致如下:
表达式的过程:
表达式因子的指数:
综上所述,可以保证在每一次处理时,当前层次下的内容都是最简形式,这样的化简思路减轻了我们设计程序时的复杂度
首先给出由Metrics分析得到的复杂度结果,由于第一次实现面向对象思路的设计,因此在程序中有许多耦合度高的部分,但实际根据前面所设计的运行逻辑,这部分耦合度是可以降低的
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| Add.and(Expr, Expr) | 1 | 1 | 2 | 2 |
| Debug.debug(Expr) | 1 | 1 | 2 | 2 |
| Debug.debug(Factor) | 12 | 1 | 7 | 7 |
| Debug.debug(Term) | 1 | 1 | 2 | 2 |
| Debug.repeat(String, int) | 1 | 1 | 2 | 2 |
| Expr.Expr() | 0 | 1 | 1 | 1 |
| Expr.addTerm(Term) | 0 | 1 | 1 | 1 |
| Expr.getTerms() | 0 | 1 | 1 | 1 |
| Expr.setTerms(HashSet) | 0 | 1 | 1 | 1 |
| ExprFactor.ExprFactor(Expr, int, boolean) | 2 | 1 | 3 | 3 |
| ExprFactor.getExpr() | 0 | 1 | 1 | 1 |
| ExprFactor.isNegative() | 0 | 1 | 1 | 1 |
| ExprFactor.setNegative(boolean) | 0 | 1 | 1 | 1 |
| ExprParser.parse(String) | 1 | 1 | 2 | 2 |
| ExprParser.separate(String, int) | 15 | 1 | 10 | 11 |
| ExprReducer.reduce(Expr) | 0 | 1 | 1 | 1 |
| ExprReducer.reduce(Expr, Boolean) | 14 | 1 | 9 | 9 |
| FactorParser.parse(String) | 18 | 4 | 10 | 13 |
| FactorParser.separate(String, int) | 12 | 1 | 6 | 7 |
| MainClass.main(String[]) | 4 | 1 | 3 | 3 |
| MainClass.testing(String) | 0 | 1 | 1 | 1 |
| Mult.clone(Expr, Expr) | 8 | 1 | 6 | 6 |
| Mult.parse(Expr, BigInteger) | 8 | 4 | 5 | 5 |
| Mult.parse(Expr, Expr) | 6 | 1 | 4 | 4 |
| Mult.parse(Expr, Factor) | 3 | 1 | 4 | 4 |
| Mult.parse(Expr, String, int) | 8 | 4 | 5 | 5 |
| NumFactor.NumFactor(BigInteger, int, boolean) | 0 | 1 | 1 | 1 |
| NumFactor.getIndex() | 0 | 1 | 1 | 1 |
| NumFactor.getValue() | 0 | 1 | 1 | 1 |
| NumFactor.isNegative() | 0 | 1 | 1 | 1 |
| NumFactor.setIndex(int) | 0 | 1 | 1 | 1 |
| NumFactor.setNegative(boolean) | 0 | 1 | 1 | 1 |
| NumFactor.setValue(BigInteger) | 0 | 1 | 1 | 1 |
| Output.outPut(Expr) | 15 | 6 | 6 | 8 |
| Term.Term() | 0 | 1 | 1 | 1 |
| Term.addFactor(Factor) | 0 | 1 | 1 | 1 |
| Term.addNum(BigInteger) | 3 | 1 | 3 | 3 |
| Term.getFactors() | 0 | 1 | 1 | 1 |
| Term.getNegative() | 13 | 1 | 7 | 7 |
| Term.getNum() | 6 | 1 | 4 | 4 |
| Term.getVar() | 9 | 6 | 5 | 6 |
| Term.newFactors(HashSet) | 0 | 1 | 1 | 1 |
| Term.toString() | 8 | 1 | 5 | 5 |
| TermParser.parse(String) | 1 | 1 | 2 | 2 |
| TermParser.separate(String, int) | 12 | 1 | 6 | 7 |
| TermReducer.combine(Expr) | 14 | 1 | 7 | 7 |
| TermReducer.reduce(Term) | 20 | 1 | 8 | 11 |
| Testing.calculate(String) | 0 | 1 | 1 | 1 |
| Testing.generate() | 0 | 1 | 1 | 1 |
| Testing.test() | 6 | 4 | 3 | 4 |
| VarFactor.VarFactor(String, int, boolean) | 0 | 1 | 1 | 1 |
| VarFactor.getIndex() | 0 | 1 | 1 | 1 |
| VarFactor.getVar() | 0 | 1 | 1 | 1 |
| VarFactor.isNegative() | 0 | 1 | 1 | 1 |
| VarFactor.setIndex(int) | 0 | 1 | 1 | 1 |
| VarFactor.setNegative(boolean) | 0 | 1 | 1 | 1 |
可以看出程序的复杂度主要集中在解析和化简部分,而其中复杂度最主要是因为此部分代码没有使用面向对象的思路,仍为单一方法中对容器中内容直接进行访问,因此在后续的修改和迭代开发中也出现了难以维护的情况。经过这一单元的开发,我深刻认识到模块间解耦合对程序维护和迭代的重要意义,当面对数百行互相关联的代码时,体现出的无力感着实令人焦躁
expression = expression.replaceAll("[ \t]", ""); // 去掉所有空格和制表符
运用简单的正则表达式即可实现
        Expr expr = new Expr();
        int i = 0;
        while (i < expression.length()) { // 遍历表达式
            int j = separate(expression, i); // 分离项
            String sub = expression.substring(i, j); // 设项为子串
            Term term = TermParser.parse(sub); // 解析项
            expr.addTerm(term); // 添加项
            i = j;
        }
        expr = ExprReducer.reduce(expr); // 简化表达式
        return expr;
采用递归的思路,借助一个项结尾的特征设计分离函数(项的结尾一定是字母或括号链接正负号),将子项作为新的字符串进行解析
在获得表达式时,一定会调用化简,因此解析得到的所有表达式一定是最简形式(运算得到的表达式不一定最简)
        Term term = new Term();
        int i = 0;
        while (i < sub.length()) {
            int j = separate(sub, i); // 分离因子
            String subsub = sub.substring(i, j);
            Factor factor = FactorParser.parse(subsub); // 解析因子
            term.addFactor(factor);
            i = j + 1;
        }
        return term;
因子同理,因子之间的分隔符为*,注意跳过括号中的内容
        /**
         *  前面分离因子的正负号和指数,指数分隔符为^
         */
        if (subsub.charAt(i) == '(') { // 表达式因子
            Expr expr = ExprParser.parse(subsub.substring(i + 1, tj - 1));
            return new ExprFactor(expr, index, isNegative);
        } else if (Character.isDigit(subsub.charAt(i))) {
            return new NumFactor(new BigInteger(subsub.substring(i, tj)), index, isNegative);
        } else if (Character.isLetter(subsub.charAt(i))) {
            return new VarFactor(subsub.substring(i, tj), index, isNegative);
        } else {
            return null;
        }
可见,在获得新的表达式因子之前,会将表达式的内容化简,因此得到一个完全最简的表达式因子,满足程序设计时的假设
        for (Factor factor : term.getFactors()) {
            if (factor instanceof VarFactor) {
                VarFactor varFactor = (VarFactor) factor;
                String var = varFactor.getVar();
                if (varMap.containsKey(var)) {
                    varMap.put(var, varMap.get(var) + varFactor.getIndex());
                } else {
                    varMap.put(var, varFactor.getIndex());
                }
                if (varFactor.isNegative()) {
                    isNegative = !isNegative;
                }
            } else if (factor instanceof NumFactor) {
                NumFactor numFactor = (NumFactor) factor;
                integer = integer.multiply(((NumFactor) factor).getValue());
                if (numFactor.isNegative()) {
                    isNegative = !isNegative;
                }
            } else if (factor instanceof ExprFactor) {
                ExprFactor exprFactor = (ExprFactor) factor;
                Expr expr1 = ExprReducer.reduce(exprFactor.getExpr());
                list.add(expr1);
                if (exprFactor.isNegative()) {
                    isNegative = !isNegative;
                }
            }
        }
在化简项时,为了以后多变量考虑,此时现将其中的变量名提取出来,并建立一个变量名和指数相结合的HashMap,以此存放表达式中的内容,如果有相同变量名的因子,则将指数相加
如果有数字,则将数字乘在一起,留作整个项的参数
如果有表达式(括号),则将括号中的表达式先存进队列,等待后续处理
        Term newTerm = new Term();
        for (String var : varMap.keySet()) { // 缩减变量
            VarFactor varFactor = new VarFactor(var, varMap.get(var), false);
            newTerm.addFactor(varFactor);
        }
        NumFactor numFactor = new NumFactor(integer, 1, isNegative); // 整合数字
        newTerm.addFactor(numFactor);
        Expr newExpr = new Expr();
        newExpr.addTerm(newTerm);
        for (Expr exprF : list) {
            newExpr = Mult.parse(newExpr, exprF);
        }
        newExpr = combine(newExpr); // 化简数字
        // TODO
        return newExpr;
将化简后的项提取出来,并分别于队列中等待展开的表达式相乘,得到的新表达式再进行合并,最终返回一个表达式
本次作业bug共一处:
if (index == 0) { // 次数为0则清零
    Term t = new Term();
    t.addFactor(new NumFactor(BigInteger.ONE, 1, false));
    te.addTerm(t);
}
在表达式因子的指数为0时,本应该直接将表达式清零,并存储一个新的为一的表达式,但可惜在此处忘记先清楚表达式的内容了
为了检测同学的代码是否有bug,我设计了一个简单的测试点生成器,因为设计简单,所以不保证所有的数据点均符合互测要求,所以只用来检查同学代码的bug,而一旦发现bug后再构造一个简单的数据进行hack
这个生成器在第二次作业时进行了修改,以适配第二次作业,因此第一次没有留档,在这里一并于第二次作业部分做介绍
简单说一下发现的bug:
在本次作业中,首先考虑的是程序的拓展性,因此没有过多关心优化的问题,程序中涉及的优化仅一下内容:
本次作业要求增加了指数因子和自定义表达式,以及多层嵌套的括号
首先是关于不可变部分,整体表达式的结构(层次化结构)并没有发生改变,这也说明第一次作业时作的假设成真
除此之外,考虑第一次开发时预留的拓展内容,本次作业的几个新要求,也可以被化作第一次作业拓展性的一种变形
例如多层嵌套的括号,这是在第一次就已经被考虑到的,因此几乎不需要作修改
其次是指数因子,在实验中主要有两种思路:
但实际上指数具有几个特点:
因此指数的特点是与变量相似的,但是指数内部含有一个新的表达式,因此最合适还是增加一个指数因子
但是因为不想大幅度修改其他部分的内容,因此我将指数作为一种特殊的幂函数来表示,复用了变量因子
再其次就是自定义函数,这部分是这次作业相对复杂的部分
但是因为我之前的表达式中已经支持了表达式的多变量,因此可以直接将自定义函数的具体内容,作为一个表达式解析
解析出的表达式,是一个由x, y, z组成的最简表达式,此时要考虑函数的几个问题
而且表达式的处理方法也大致有几个方案
为了尽可能不修改原有的表达式解析部分,我这里选择使用字符串替换的方法
同时为了处理以上几个问题,我首先将表达式中的参数替代为@0, @1, @2等不会重复的占位符,并将预处理好的函数存为函数名——函数的HashMap
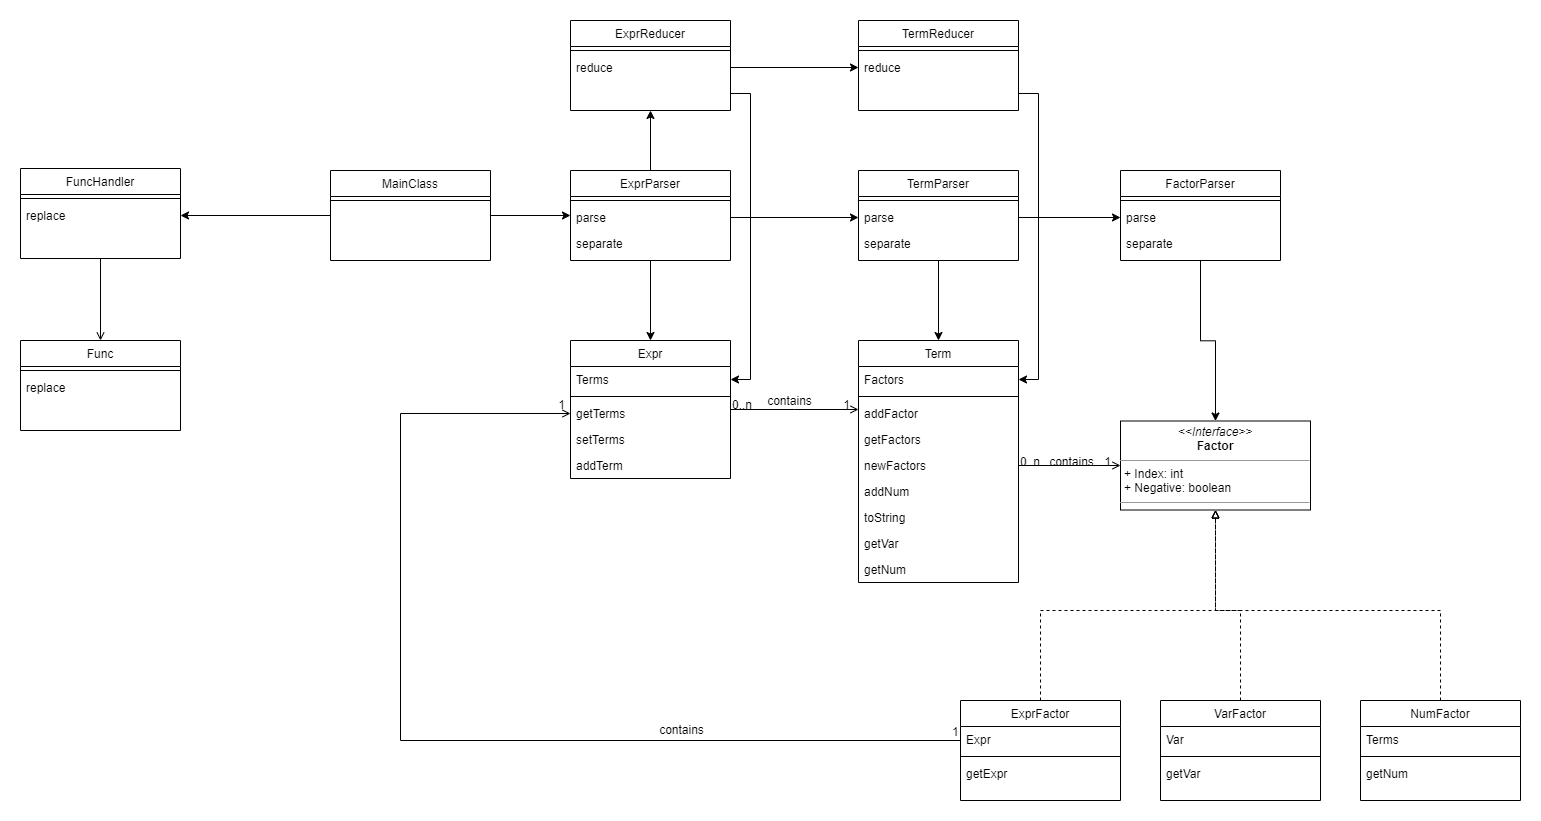
由图可见,第二次对架构的修改较少,大部分内容可以沿用第一次作业
关于整体流程部分,可以增加两个新内容:
具体操作流程为:
至于指数的部分,我直接附在变量因子内,乘法合并时只需要将两个表达式相加即可,而加法合并时则保证按规律输出的表达式相同,则可以合并,具体合并逻辑和变量是相同的
在本次作业中,我对第一次中的部分耦合度较高的部分进行了重构,主要内容包括:
首先是重构后的复杂度分析
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| Box.Box(T) | 0 | 1 | 1 | 1 |
| Box.getData() | 0 | 1 | 1 | 1 |
| Box.setData(T) | 0 | 1 | 1 | 1 |
| Debug.completeDebug() | 3 | 1 | 3 | 3 |
| Debug.debug(Expr) | 1 | 1 | 2 | 2 |
| Debug.debug(Factor) | 12 | 1 | 7 | 7 |
| Debug.debug(Term) | 1 | 1 | 2 | 2 |
| Debug.nope() | 0 | 1 | 1 | 1 |
| Debug.repeat(String, int) | 1 | 1 | 2 | 2 |
| Expr.Expr() | 0 | 1 | 1 | 1 |
| Expr.add(Expr) | 9 | 1 | 6 | 6 |
| Expr.addTerm(Term) | 0 | 1 | 1 | 1 |
| Expr.clear() | 0 | 1 | 1 | 1 |
| Expr.clone() | 1 | 1 | 2 | 2 |
| Expr.compare(Expr, Expr, int) | 33 | 1 | 13 | 13 |
| Expr.getTerms() | 0 | 1 | 1 | 1 |
| Expr.outPut() | 20 | 6 | 8 | 10 |
| Expr.print(BigInteger[], BigInteger[], BigInteger[]) | 29 | 1 | 12 | 12 |
| Expr.replace(String, String) | 1 | 1 | 2 | 2 |
| Expr.setTerms(HashSet) | 0 | 1 | 1 | 1 |
| Expr.toString() | 0 | 1 | 1 | 1 |
| Expr.toString(boolean, boolean) | 6 | 4 | 4 | 5 |
| ExprFactor.ExprFactor(Expr, BigInteger, boolean) | 2 | 1 | 3 | 3 |
| ExprFactor.clone() | 0 | 1 | 1 | 1 |
| ExprFactor.getExpr() | 0 | 1 | 1 | 1 |
| ExprFactor.isNegative() | 0 | 1 | 1 | 1 |
| ExprFactor.setNegative(boolean) | 0 | 1 | 1 | 1 |
| ExprParser.parse(String) | 3 | 1 | 3 | 3 |
| ExprParser.separate(String, int) | 15 | 1 | 10 | 11 |
| ExprReducer.reduce(Expr) | 0 | 1 | 1 | 1 |
| ExprReducer.reduce(Expr, Boolean) | 13 | 1 | 9 | 9 |
| FactorParser.parse(String) | 29 | 5 | 16 | 18 |
| FactorParser.separate(String, int) | 12 | 1 | 6 | 7 |
| Func.Func(String, boolean) | 22 | 1 | 12 | 13 |
| Func.getExpr() | 0 | 1 | 1 | 1 |
| Func.getSymbol() | 0 | 1 | 1 | 1 |
| Func.getVarList() | 0 | 1 | 1 | 1 |
| Func.replace(ArrayList) | 1 | 1 | 2 | 2 |
| Func.setExpr(Expr) | 0 | 1 | 1 | 1 |
| Func.setVarList(ArrayList) | 0 | 1 | 1 | 1 |
| FuncHandler.FuncHandler(HashMap<String, Func>) | 3 | 1 | 3 | 3 |
| FuncHandler.replace(String, Box) | 18 | 3 | 9 | 12 |
| MainClass.main(String[]) | 9 | 1 | 5 | 5 |
| MainClass.testing(String) | 0 | 1 | 1 | 1 |
| Mult.parse(Expr, BigInteger) | 8 | 4 | 5 | 5 |
| Mult.parse(Expr, Expr) | 3 | 1 | 3 | 3 |
| Mult.parse(Expr, Factor) | 3 | 1 | 4 | 4 |
| Mult.parse(Expr, String, BigInteger) | 8 | 4 | 5 | 5 |
| NumFactor.NumFactor(BigInteger, BigInteger, boolean) | 0 | 1 | 1 | 1 |
| NumFactor.addNum(BigInteger) | 0 | 1 | 1 | 1 |
| NumFactor.clone() | 0 | 1 | 1 | 1 |
| NumFactor.getIndex() | 0 | 1 | 1 | 1 |
| NumFactor.getValue() | 0 | 1 | 1 | 1 |
| NumFactor.isNegative() | 0 | 1 | 1 | 1 |
| NumFactor.setIndex(BigInteger) | 0 | 1 | 1 | 1 |
| NumFactor.setNegative(boolean) | 0 | 1 | 1 | 1 |
| NumFactor.setValue(BigInteger) | 0 | 1 | 1 | 1 |
| Term.Term() | 0 | 1 | 1 | 1 |
| Term.addFactor(Factor) | 0 | 1 | 1 | 1 |
| Term.addNum(BigInteger) | 3 | 3 | 3 | 3 |
| Term.clone() | 5 | 1 | 5 | 5 |
| Term.getFactors() | 0 | 1 | 1 | 1 |
| Term.getNegative() | 13 | 1 | 7 | 7 |
| Term.getNum() | 6 | 1 | 4 | 4 |
| Term.getVar() | 9 | 6 | 5 | 6 |
| Term.merge(Term) | 0 | 1 | 1 | 1 |
| Term.newFactors(HashSet) | 0 | 1 | 1 | 1 |
| Term.replace(String, String) | 8 | 1 | 6 | 6 |
| Term.sort() | 13 | 1 | 8 | 8 |
| Term.toString() | 0 | 1 | 1 | 1 |
| Term.toString(boolean, boolean) | 17 | 6 | 10 | 11 |
| TermParser.parse(String) | 3 | 1 | 3 | 3 |
| TermParser.separate(String, int) | 12 | 1 | 6 | 7 |
| TermReducer.combine(Expr) | 14 | 1 | 7 | 7 |
| TermReducer.extract(HashMap<String, Factor>, boolean, BigInteger, ArrayList) | 6 | 1 | 5 | 5 |
| TermReducer.reduce(Term) | 34 | 1 | 9 | 13 |
| Testing.calculate(String) | 0 | 1 | 1 | 1 |
| Testing.generate() | 0 | 1 | 1 | 1 |
| Testing.test() | 6 | 4 | 3 | 4 |
| VarFactor.VarFactor(BigInteger, String, Expr, boolean) | 0 | 1 | 1 | 1 |
| VarFactor.VarFactor(Expr, boolean) | 0 | 1 | 1 | 1 |
| VarFactor.VarFactor(String, BigInteger, boolean) | 7 | 1 | 4 | 4 |
| VarFactor.addExpr(Expr) | 0 | 1 | 1 | 1 |
| VarFactor.addIndex(BigInteger) | 0 | 1 | 1 | 1 |
| VarFactor.clone() | 2 | 2 | 2 | 2 |
| VarFactor.getExpr() | 0 | 1 | 1 | 1 |
| VarFactor.getIndex() | 0 | 1 | 1 | 1 |
| VarFactor.getVar() | 28 | 5 | 10 | 11 |
| VarFactor.isExp() | 0 | 1 | 1 | 1 |
| VarFactor.isNegative() | 0 | 1 | 1 | 1 |
| VarFactor.setExpr(Expr) | 0 | 1 | 1 | 1 |
| VarFactor.setIndex(BigInteger) | 0 | 1 | 1 | 1 |
| VarFactor.setNegative(boolean) | 0 | 1 | 1 | 1 |
| VarFactor.setVar(String) | 0 | 1 | 1 | 1 |
看起来部分方法,例如化简和输出的方法复杂度仍然很高,但实际上这部分是因为大量调用了Debug的方法,实际在Debug模式被关闭的情况下是不会影响程序内容的
Expr expr = this.expr.clone();
String ans = expr.toString(false, false);
for (int i = 0; i < list.size(); i++) {
    ans = ans.replace("@" + i, "(" + list.get(i) + ")");
}
return ans;
带入的实参要额外带一层括号,以免部分内容优先级出错
if (this.expr != null) {
    Expr expr1 = this.expr.clone();
    expr1 = ExprReducer.reduce(expr1);
    HashSet<Term> terms = expr1.getTerms();
    int i = terms.size();
    if (i == 0) {
        return "exp(0)";
    } else if (i == 1) {
        String exp = expr1.toString(false, false);
        int t = 0;
        BigInteger integer = BigInteger.ONE;
        for (Term term : terms) {
            for (Factor factor : term.getFactors()) {
                if (factor instanceof NumFactor) {
                    NumFactor numFactor = (NumFactor) factor;
                    integer = integer.multiply(numFactor.getValue());
                    if (numFactor.isNegative()) {
                        integer = integer.multiply(new BigInteger("-1"));
                    }
                } else if (factor instanceof VarFactor) {
                    t++;
                }
            }
        }
        if (t == 1 && integer.equals(BigInteger.ONE)) {
            return "exp(" + expr1.toString(false, false) + ")";
        } else {
            return "exp((" + expr1.toString(false, false) + "))";
        }
    }
    // TODO
    // Debug.debug(this.expr);
    return "exp((" + expr1.toString(false, false) + "))";
}
return var;
这其中的提取参数的部分,实际上依旧被修改到expr的方法中,但是这里忘了改了
String ans = funcMap.get(func.getSymbol()).replace(func.getVarList());
waitingMap.put(find, ans);
for (String s : waitingMap.keySet()) {
    // TODO bug ff(x) f(x)
    if (ans.contains(s)) {
        suc.setData(true);
        ans = ans.replace(s, "(" + waitingMap.get(s) + ")");
    }

}

return ans;
前面先提取出对应的实参,并将实参覆盖到预处理后的函数中,生成一个字符串到字符串的映射关系,最后直接进行字符串替换
public String toString(boolean ignoreNum, boolean debug) {
    Expr expr = clone();
    ArrayList<String> list = new ArrayList<>();
    for (Term term : expr.getTerms()) {
        list.add(term.toString(ignoreNum, debug));
    }
    Collections.sort(list);
    StringBuilder sb = new StringBuilder();
    for (String s : list) {
        if (s.equals("0")) {
            continue;
        }
        sb.append(s).append("+");
    }
    if (sb.length() != 0) {
        sb.deleteCharAt(sb.length() - 1);
    } else {
        return "0";
    }
    String s = sb.toString();
    s = s.replaceAll("[+]-", "-");
    s = s.replaceAll("-1\\*", "-");
    return s;
}
这个方法用于对表达式的项进行字典序排序,并最终化简输出,项的toString方法也类似,但是因为起初并不知道IDE在debug时会调用toString方法,导致我经历了极其折磨的一天(IDE输出和jar包输出不一致,但debug输出又一致了......)
除此之外,为了适配exp的化简需要,我将化简时存储的BigInteger类型的指数修改为了因子类型,进而适配指数合并
本次bug共一处,因为重写了expr的输出函数,因此在第一次考虑到仅有0时,会保留0,但重写后忘记这个细节,导致在仅有0作为输出时,会导致输出为空
if (sb.length() != 0) {
    sb.deleteCharAt(sb.length() - 1);
} else {
    return "0";
}
在起初没有else部分的判断,因此输出可能为空
除此之外,还因为toString方法重载,导致IDE运行结果和jar运行结果不一致,最后发现原因是:
经历这一次难忘的debug经历,以后在重载toString方法时,一定要保证内容不被影响
发现的同学的bug仅一处:
总的来说,这个bug的触发条件比较复杂,主要错误原因是自定义函数的解释过程和表达式解释过程不同,而出现的bug
在第一次作业时为了更好的进行互测,我写了一个简单的评测机,其中测试点是根据规则生成的,但是因为没有总的限制测试点的复杂度,导致可能出现部分复杂度过高的情况,反而导致最后程序运行时间太长,影响测试效率,因此我一并改为超时即停止
具体生成代码比较长,在这里只介绍一些我为了优化测试点的设计:
这部分都是通过一个有上下限的非线性函数表示,根据深度,长度逐渐增加,函数得到的生成概率会快速降低,最终到达上限时为0
这部分有正态分布生成,0-8的在数值上的分布为0.5的间隔,但是因为正态分布的性质,导致0的概率显著高于8
使测试点的能够大概率测试出包含0的特殊情况,同时不会导致复杂度过高
因为要测试BigInteger的性能,因此我和第一个限制方法是一样的,即数字长度越高,继续延伸的概率也越低,最后生成的数值大部分分布于2-10位,小概率会出现20+甚至50+的特殊情况,以测试大数的运算效果
起初在考虑指数函数时,本认为提取公因式不一定能带来很大的性能提升,因此没做提取公因式
除此之外,程序的优化主要有:
第三次作业的新增要求为:
在实现函数部分时,因为我的处理方法是先进行预处理,并且会将函数表达式部分解析
因此整体代码可以复用,只需要将每一次处理后得到的函数对进入到FuncHandler中再次处理下一个函数
即可对新的函数中调用的函数进行替换,因此不需要进行大改
而关于求导因子,具体实现方式参考了第二次实验中的代码,唯一区别在于变量求导有一点区别
总的来说,如果只追求正确性,第三次作业的要求并不多,在前两次兼顾到拓展性的情况下,并不需要进行多少修改
第三次作业的架构和第二次没有变化,唯一区别在于表达式,项和因子都添加了一个求导方法,用以递归调用求导
而对于整体流程:
也没有明显变化
int n = Integer.parseInt(scanner.nextLine());
for (int i = 0; i < n; i++) {
    String funcS = scanner.nextLine();
    funcS = funcS.replaceAll("[ \t]", "");
    FuncHandler funcHandler = new FuncHandler(funcMap);
    Box<Boolean> suc = new Box<>(true);
    while (suc.getData()) {
        suc.setData(false);
        funcS = funcHandler.replace(funcS, suc, true);
    }
    Func func = new Func(funcS, true);
    funcMap.put(func.getSymbol(), func);
}
Expr expr = ExprParser.parse(subsub.substring(i + 3, tj - 1));
expr = expr.derivation();
return new ExprFactor(expr, index, isNegative);
public Expr derivation() {
    Expr expr = new Expr();
    for (Term term : terms) {
        expr.getTerms().addAll(term.derivation().getTerms());
    }
    expr = ExprReducer.reduce(expr);
    return expr;
}
public Expr derivation() {
    Expr expr = new Expr();
    ArrayList<Factor> list = new ArrayList<>(factors);
    for (int i = 0; i < list.size(); i++) {
        Factor factor = list.get(i);
        Term term = factor.derivation();
        for (int j = 0; j < list.size(); j++) {
            if (i == j) {
                continue;
            }
            Factor factor1 = list.get(j);
            term.addFactor(factor1);
        }
        expr.addTerm(term);
    }
    return expr;
}
public Term derivation() {
    Term term = new Term();
    Expr expr1 = expr.derivation();
    ExprFactor exprFactor = new ExprFactor(expr1, BigInteger.ONE, isNegative);
    term.addFactor(exprFactor);
    return term;
}
public Term derivation() {
    Term term = new Term();
    if (expr == null) {
        if (var.equals("x")) {
            NumFactor numFactor = new NumFactor(index, BigInteger.ONE, isNegative);
            VarFactor varFactor = new VarFactor(var, index.subtract(BigInteger.ONE), false);
            if (varFactor.index.equals(BigInteger.ZERO)) {
                term.addFactor(numFactor);
            } else {
                term.addFactor(numFactor);
                term.addFactor(varFactor);
            }
        }
    } else {
        Expr expr1 = expr.derivation();
        ExprFactor exprFactor = new ExprFactor(expr1, BigInteger.ONE, isNegative);
        term.addFactor(this.clone());
        term.addFactor(exprFactor);
    }
    return term;
}
public Term derivation() {
    NumFactor factor = new NumFactor(new BigInteger("0"), new BigInteger("1"), false);
    Term term = new Term();
    term.addFactor(factor);
    return term;
}
分别是表达式,项,表达式因子,变量因子,参数因子的求导方法,其中变量因子与实验中的代码有一定区别,主要是因为我的变量因子包含指数和指数函数
这一次作业并没有发现什么bug,同时目前了解到的优化区间主要在于如何快速求导
作为少数没有参加OOpre的学生,第一次作业带给我的压力还是很大的,但多亏之前曾因为兴趣自学过java的基本用法和git等工具的用法,因此并没有在第一次作业直接被卡主。但是缺少面向对象程序设计经验的缺陷却是难以避免的,从程序设计课程的取巧式编程,到数据结构的结构化编程,再到现在的面向对象,在程序设计上的思路和规范发生了一次次的改变。还记得当时在程序设计课程上,还曾用尽可能取巧的方法,仅解决题目给出的单一问题,那是不会考虑这一段代码之后能否修改,能否迭代,只需要简单的十几行到几十行就可以满足题目需求。再到数据结构,终于要构思程序的结构,要保证每一次运算的意义。而今进入面向对象课程,仅仅考虑程序的大致框架已经难以满足迭代开发的需求,当数百行代码互相勾结在一起时,牵一发而动全身,让人无从下手。在第一次作业中,与其说是面向对象编程,不如说是包含着数据结构的面向过程编程。整个流程耦合度极其高,尽管设计时总想着,这一个个模块之间可以有单调的关系,但实践时却总是缺少这样的一个思路和警惕。当最后终于完成全部功能时,却发现这牵连在一起的毛线球已经难以挽救。
总的来说,第一单元作业对我来说,是一次对OOpre的补课,通过这一次迭代开发的体验,让我熟悉了一下OO课程的流程,同时学习了面向对象设计的思路,并有了一定经验。
在这次的开发训练中,有如下潜在的发展方向


