


301
社区成员
 发帖
 与我相关
 我的任务

 分享
代码规模:
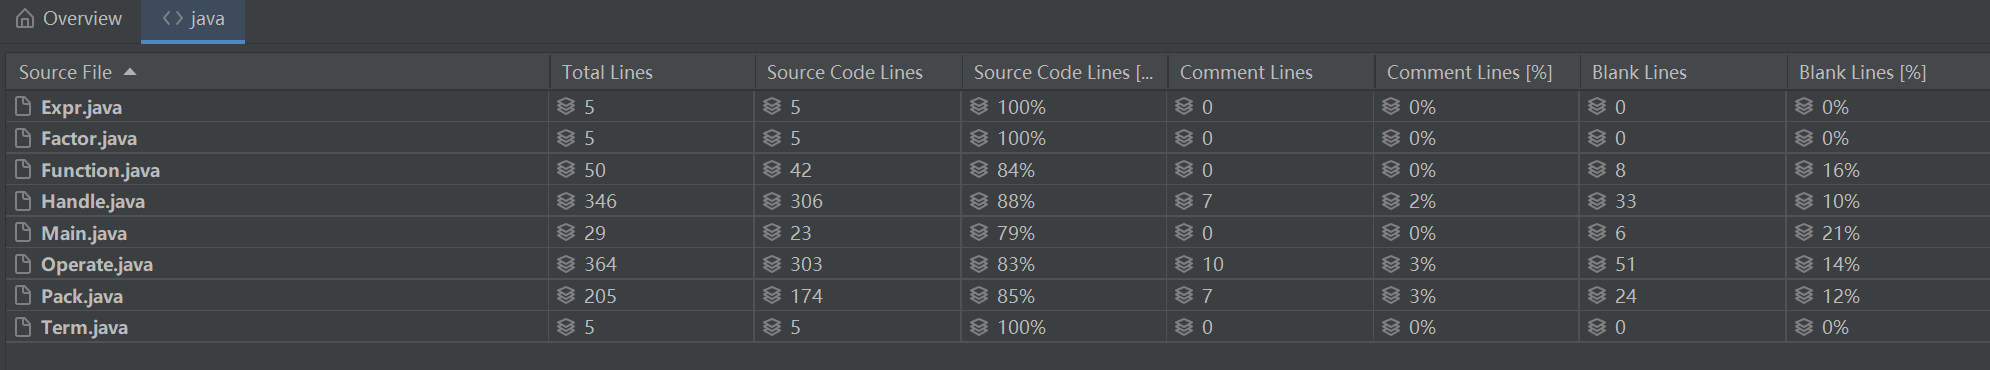
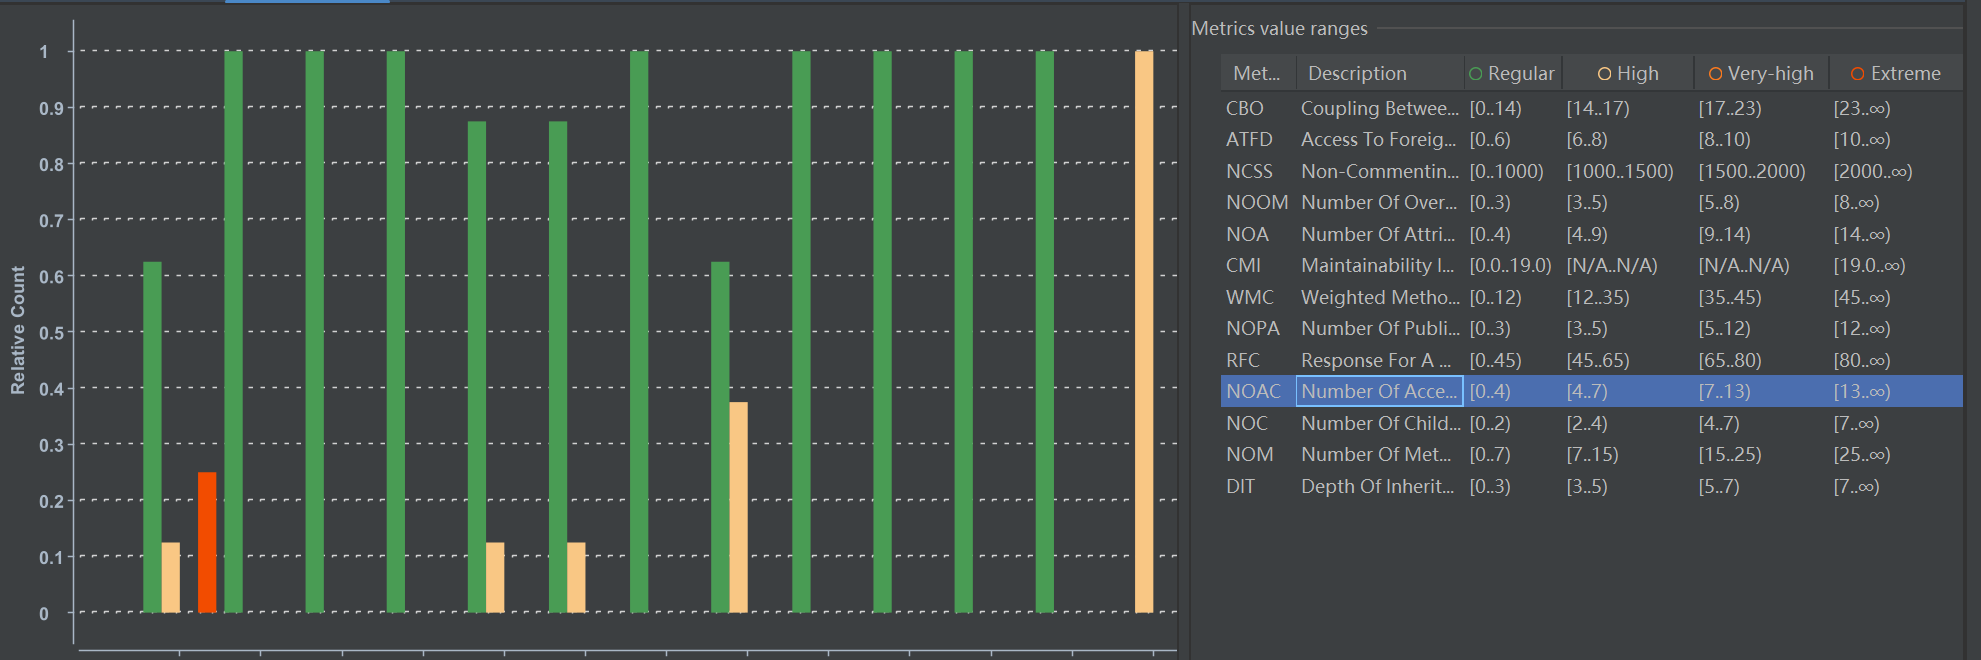
如下
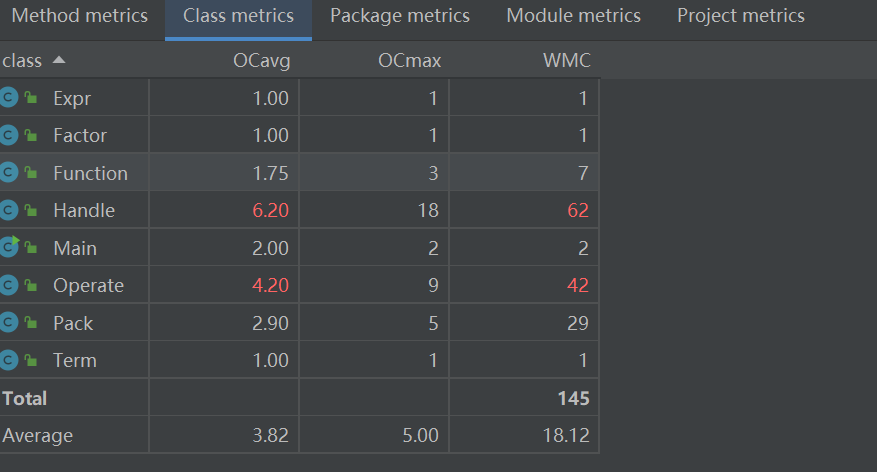
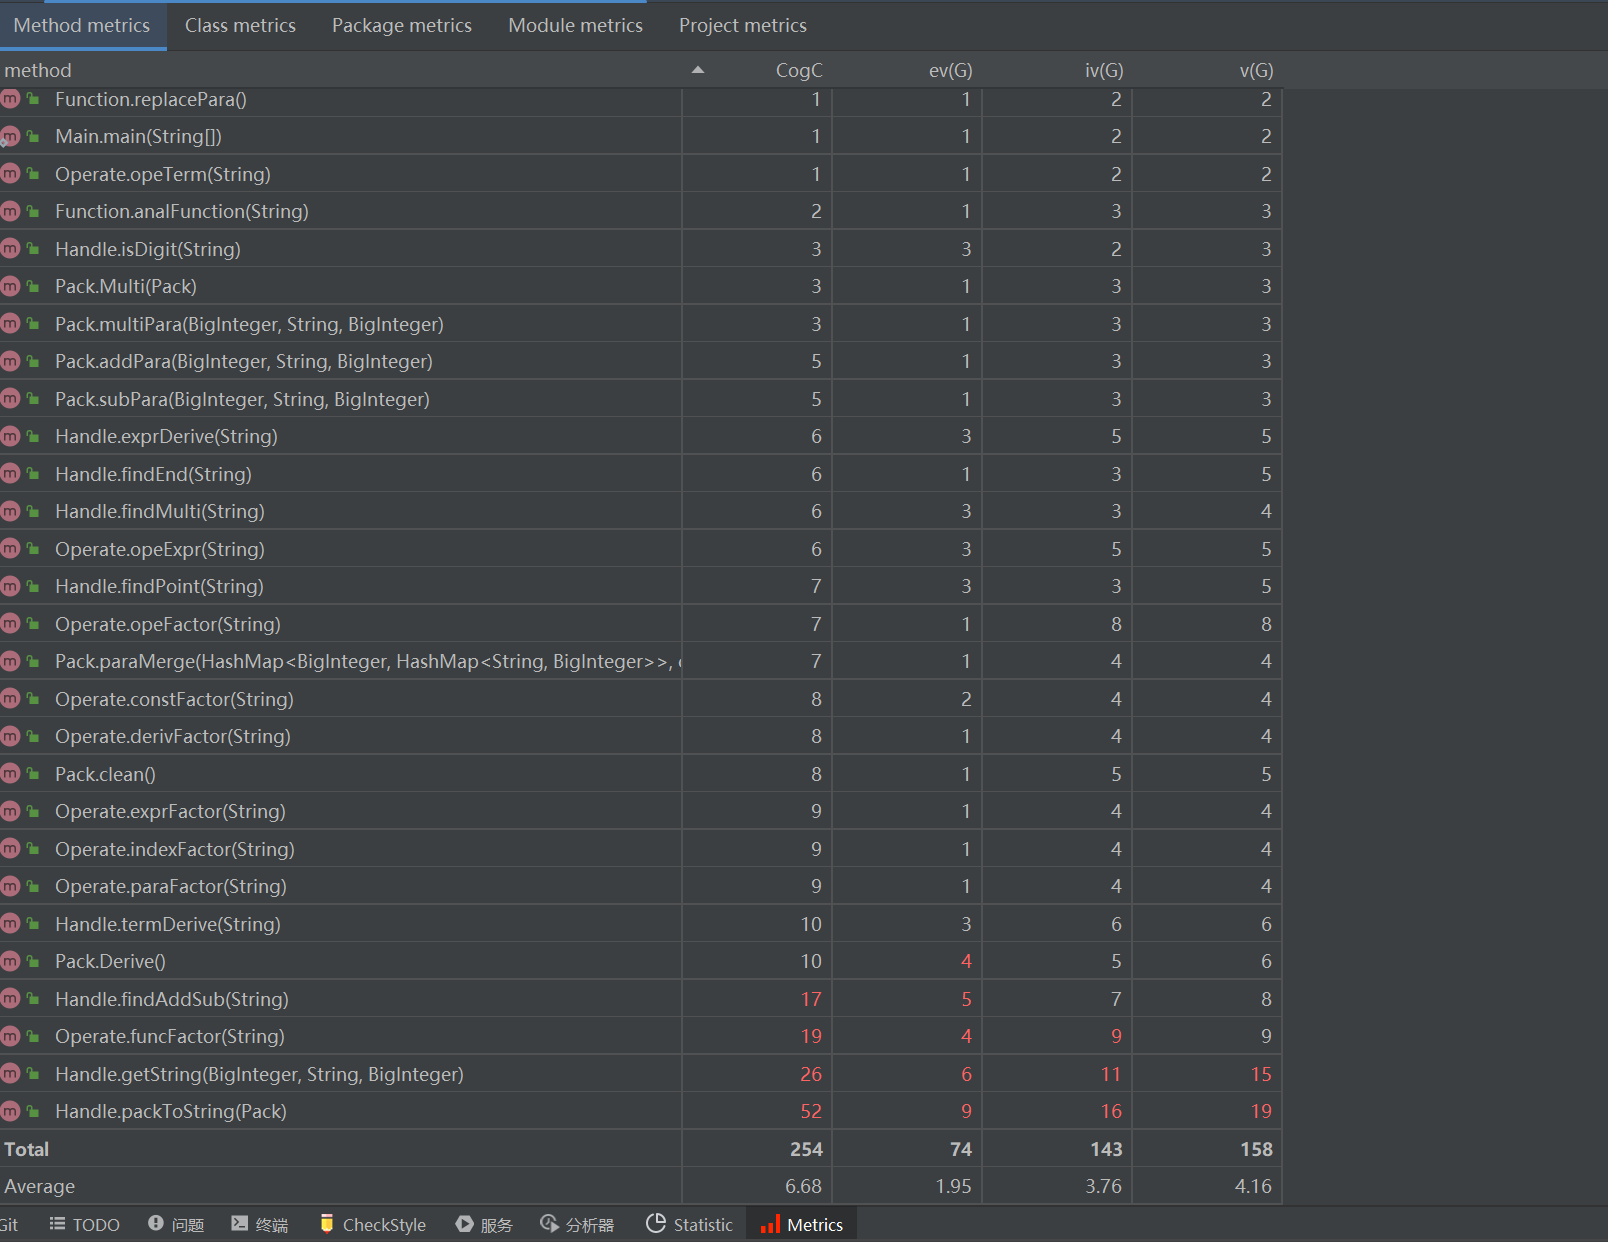
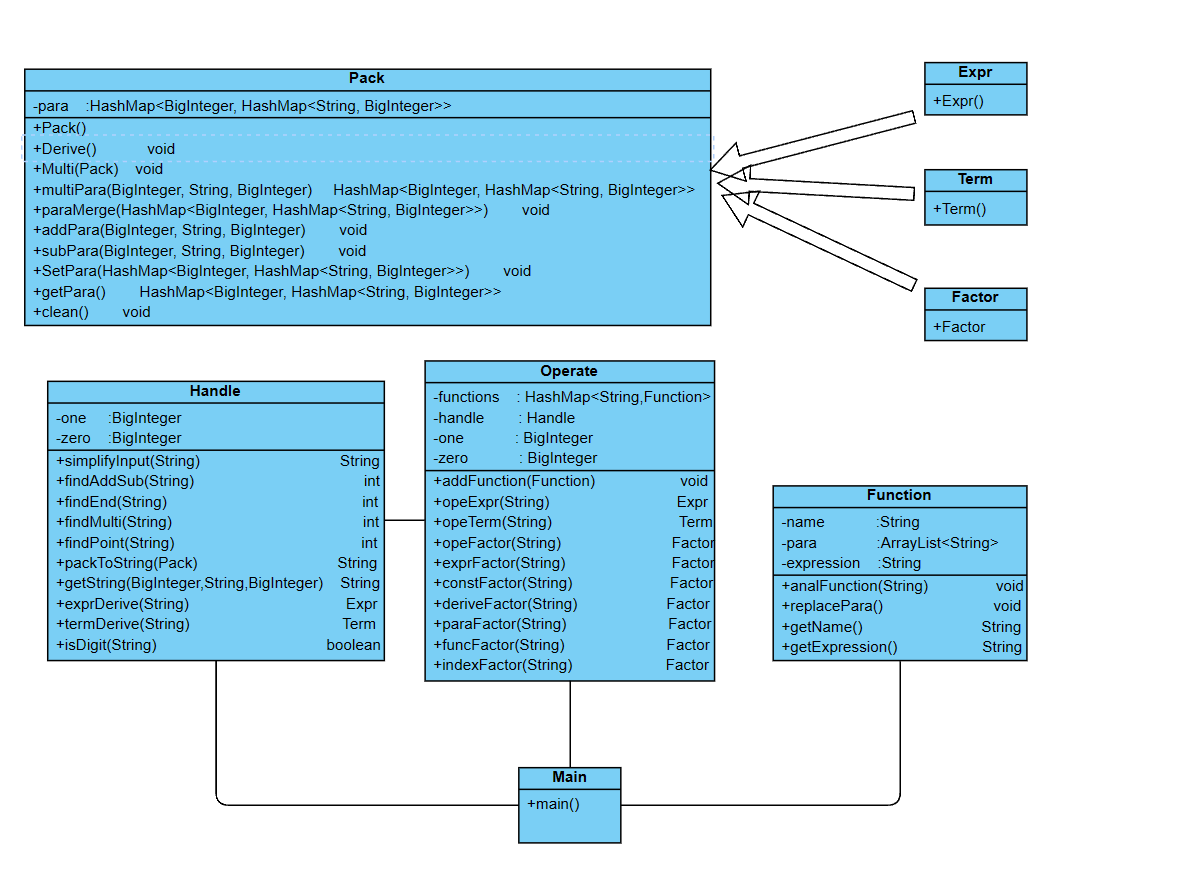
Operate类是实现递归下降的类
而Handle则负责处理运行中遇到的各种问题
如项的分割,因子的分割等
函数的分析处理交给Function类实现
有关表达式的操作则放在Pack类里
优点不多,我觉得将Factor分类处理,以及Pack子类继承可算两个
同时一些功能性方法被我封装在了Handle类中
以及函数有自己的分析类
结构还是比较清晰的
类之间也有独立性
对继承的理解还是不算深刻
子类并没有实现对父类的重写,并没有体现出子类的独特
同时对表达式和项的求导放在了Handle中,这导致了程序的耦合
应该在Pack及其子类中进行重写
在第一次hw中,我对项的理解并不透彻
在架构中出现了并不算方便的处理
如在对单项式的处理中,我将常量和变量分开存储,即:
    private HashMap<Integer, BigInteger> para;
    private BigInteger myConst;
这其实忽略了常数就是x的指数为0的情况,导致写了很多不必要的冗余功能,包括getConst等
同时在实现项的加法,因子的乘法时要同时考虑const和para,显得颇为复杂
这一点在hw2中有所改进
其次,递归下降虽然在我的架构中有所体现,但个人感觉并不够
虽然我构建了Expr Term Factor三个类
Expr = Term + Term + ...
Term = Factor * Factor * ...
但是每一个类并无太大区别,都分别存储了常量和变量
这样更像是对相同的类进行了不同的取名
而且相比于其他人生成语法树的解析过程
我单纯地只是在Operate类中进行了
public Expr opeExpr(String input)
{
    //...
}
public Term opeTerm(String input)
{
    //...
}
public Factor opeFactor(String input)
{
    //...
}
将表达式分层解析的操作
这样做导致一些功能集成在同一类中
并不够独立而在之后出现很多问题
在第二次作业中,我们新增了指数函数的表达形式
即: exp(表达式)
这一点即完全推翻了我在hw1中对多项式的存储方式
首先,myConst不再适用,因为常量包括exp(常数)
不能再单纯地使用BigInteger存储
其次,变量的存储形式para也不再适用
因为exp的指数中也可能出现变量
因此在这里对单项式做了一个统一的形式:
c1*exp(index)*x^c2
故使用Hashmap:
private HashMap<BigInteger, HashMap<String, BigInteger>> para;
其中用x的指数c2作为key,exp的指数index作为value中哈希表的key
由于exp指数需要转换为String类型,这里还需要写出多项式转String的方法
public String packToString(Pack pack)
{
    // TODO
    }
同时我们新增自定义函数
最开始的想法是直接进行字符串层次的替换
即: 在读入input后,就将所有的函数进行实参的代入替换
但这样并不算方便,且与递归下降的架构并不契合
因此选择先单纯将函数作为因子
只在对因子进行处理时,对函数进行代入替换,即:
public Factor opeFactor(String input)
{
     ...
     else if(handle.isFunction(input))
     {
         String str = handle.funcReplace(input);
         expr = this.opeExpr(str);
         ...
     }
     ...
}
这样就做到了将对函数的处理融合在递归下降的架构中
在hw1中我们将功能全部集成在了Operate类中
这并不够独立,因此在这一次作业中我进行了一次分割
新建Handle类,将所有功能性方法全部集成在此类中
而Operate类则变成单纯地对多项式地进行解析的类
本次作业新增dx求导算子
同样只需要在因子层次进行特判:
public Factor opeFactor(String input)
{
    ...
    else if(handle.isDerive(input))
    {
        ...
    }
    ...
}
之后进行一次求导计算即可
而对于新增的函数可互相调用的功能
在上一次作业的递归下降就已经解决,这里不做处理亦可
根据现有的计算需求,可能出现的拓展有:
特殊函数,如三角函数的计算求导等
三角函数可以看作新的特殊因子,可以类似一个exp指数函数
那么就需要在para中新增三角函数的String内容
因此可能需要对单项式的存储方法进行重构
构建新的Unit类专门存储单项式的各项信息
出现新定义运算
由于递归下降的优先级问题,新定义运算最好是优先级高于乘法
由此可以在Factor中再进行一次下降
根据新定义运算,拆分成
Factor = Basic # Basic # ...
之后再进行处理即可
在第一单元我出现了两个致命bug
这导致我的强测扣了50分
T T
1.在最后对多项式的输出中,我为了实现输出的优化,在对x的系数输出中进行了一个判断
int flag = 0;
if (flag == 0)
{
    if (para.get(point).equals(BigInteger.ONE))
    {
        System.out.print("x");
    }
    flag = 1;
}
else
{
    if (para.get(point).equals(BigInteger.ONE))
    {
        System.out.print("+x");
    }
}
即:如果是第一次输出,则在是正系数的情况下省略第一个正号,否则输出正号
同时若系数是1,则省略系数
但是我忽略了部分非1系数下正号的输出
2.
public void subPara(Integer point, BigInteger bigInteger)
    {
        BigInteger big = bigInteger;
        if (para.containsKey(point))
        {
            big = big.subtract(para.get(point));
        }
        else
        {
            big = big.negate();
        }
        para.put(point, big);
    }
这是我对项的减法操作,看似无问题
但注意其中的
big = big.subtract(para.get(point));
减数-被减数
由于偷懒导致的顺序错误,直接就导致了大量WA
不得不说十分愚蠢,甚至没进互测
这一次迭代也有一个十分微小的Bug
在中测时并不显露,但强测就把我斩于马下
1. 系数为0
一个很简单的数据可以形容这个问题
0
1-1
输出 0 对吧,但是事实上我的输出是
""
没错就是空串。由于在自己编纂数据时出现了大量系数为0的输出
私以为这些都是无效输出,于是在输出前进行了一步clean
大胆地清除了所有系数为0的项
很不巧,这就包含了常数0
2. Format Error
再仔细一看,怎么还有形式错误?
原来是对输出要求没有看清
由于太想优化,导致在输出时对同类项进行了合并
出现了非必要括号
改为老老实实输出后解决
3. 经典CPU_TIME_LIMIT
0
(((((((((((x^8)^8)^8)^8)^8)^8)^8)^8)^8)^8)^8)^8
一个数据爆了两个问题
最开始对于乘方的简单解决办法是直接展开
即:
input : (x+1)^2 -> (x+1)*(x+1)
展开后再作为Term进行处理
但很显然这样的时间复杂度很高
因为需要将所有内容全部展开计算
故做一个简单的处理后调换一下计算顺序即可
input : (x+1)^2
->
str : x+1
index : 2
其中,先对str进行因子计算处理
计算完成后再进行index指数乘方
这样时间复杂度就很低了
可喜可贺,这一次终于进了互测
(再不进互测就要重修了QAQ)
强测的点很奇怪
Zero length BigInteger
用Print大法一看就发现了问题
一个简单的例子
1
f(x)=x^2
f(dx(x))
简单替换后是
dx(x)^2
但是在对求导因子的处理中并没有考虑到可能的指数符号
导致报错,修改后解决
什么?原来有人互测都没进?
哭辽T A T
第一次进互测十分的激动(虽然只是C组
首先当然是先将自己曾经的BUG提交进去
然后发现同房的佬们完全不吃这套
(只有我一个人受伤的世界达成了
之后开始绞尽脑汁编数据,但总是过不了合法性检验,悲
故这提出几点可能的BUG方向:
CPU_TIME_LIMIT
对同房程序进行深度的疯狂嵌套,以期得到CPU_TIME_LIMIT的错误
NULL_POINT
创造各种空式,如0*x^0,或通过计算得到空式,看是否有对此的特判处理
Not Valid Factor
在因子的判断中,可能出现不属于任一因子的情况,这主要源于函数的替换
可以设计复杂的实参,看是否会让因子解析的程序报错
当然简单的优化还是要做的
1*x OR -1\*x -> x OR -x
flag = 0
while(true)
{
 if (flag == 0)
 {
     flag = 1;
     ...
 }
 else
 {
     ...
 }
}
public void clean()
{
 ...
 for ()
 {
     ...
     for ()
     {
         ...
         if (bigInteger.equals(BigInteger.ZERO))
         {
             iterator.remove();
         }
         ...
     }
     ...
 }
 ...
}
在这一整个单元的学习过程中,最让我印象深刻的就是对形式化表达的程序实现
在hw1的作业中,最开始我死板地完全依照形式化表达去处理输入的表达式
这并没有让我获得更完善的程序,而是隐藏BUG不断
在吸取了别的同学的经验后,才采取了化简输入的方法:
对连续符号进行合并,以及全部去除空白符
之后再处理就方便很多
也就是说,要对问题核心进行深度分析后,从问题导向思考解决方法
而不仅仅是题目怎么说我就怎么写
其次,程序的独立性也是需要考虑的一部分
不要将大部分功能集成在某一类中
要有对象的观念
可以归类的方法需要分门别类地实现,才能实现代码清晰,逻辑清楚
同时可扩展性和独立性也会更高
不至于牵一发而动全身
或许可以考虑均衡一下历次作业的难度
Unit1的难度大致为
hw2 > hw1 >> hw3
这其实对很多Java不太熟悉的同学来说不算友好
或许可以考虑更加循序渐进一些


