


301
社区成员
 发帖
 与我相关
 我的任务

 分享
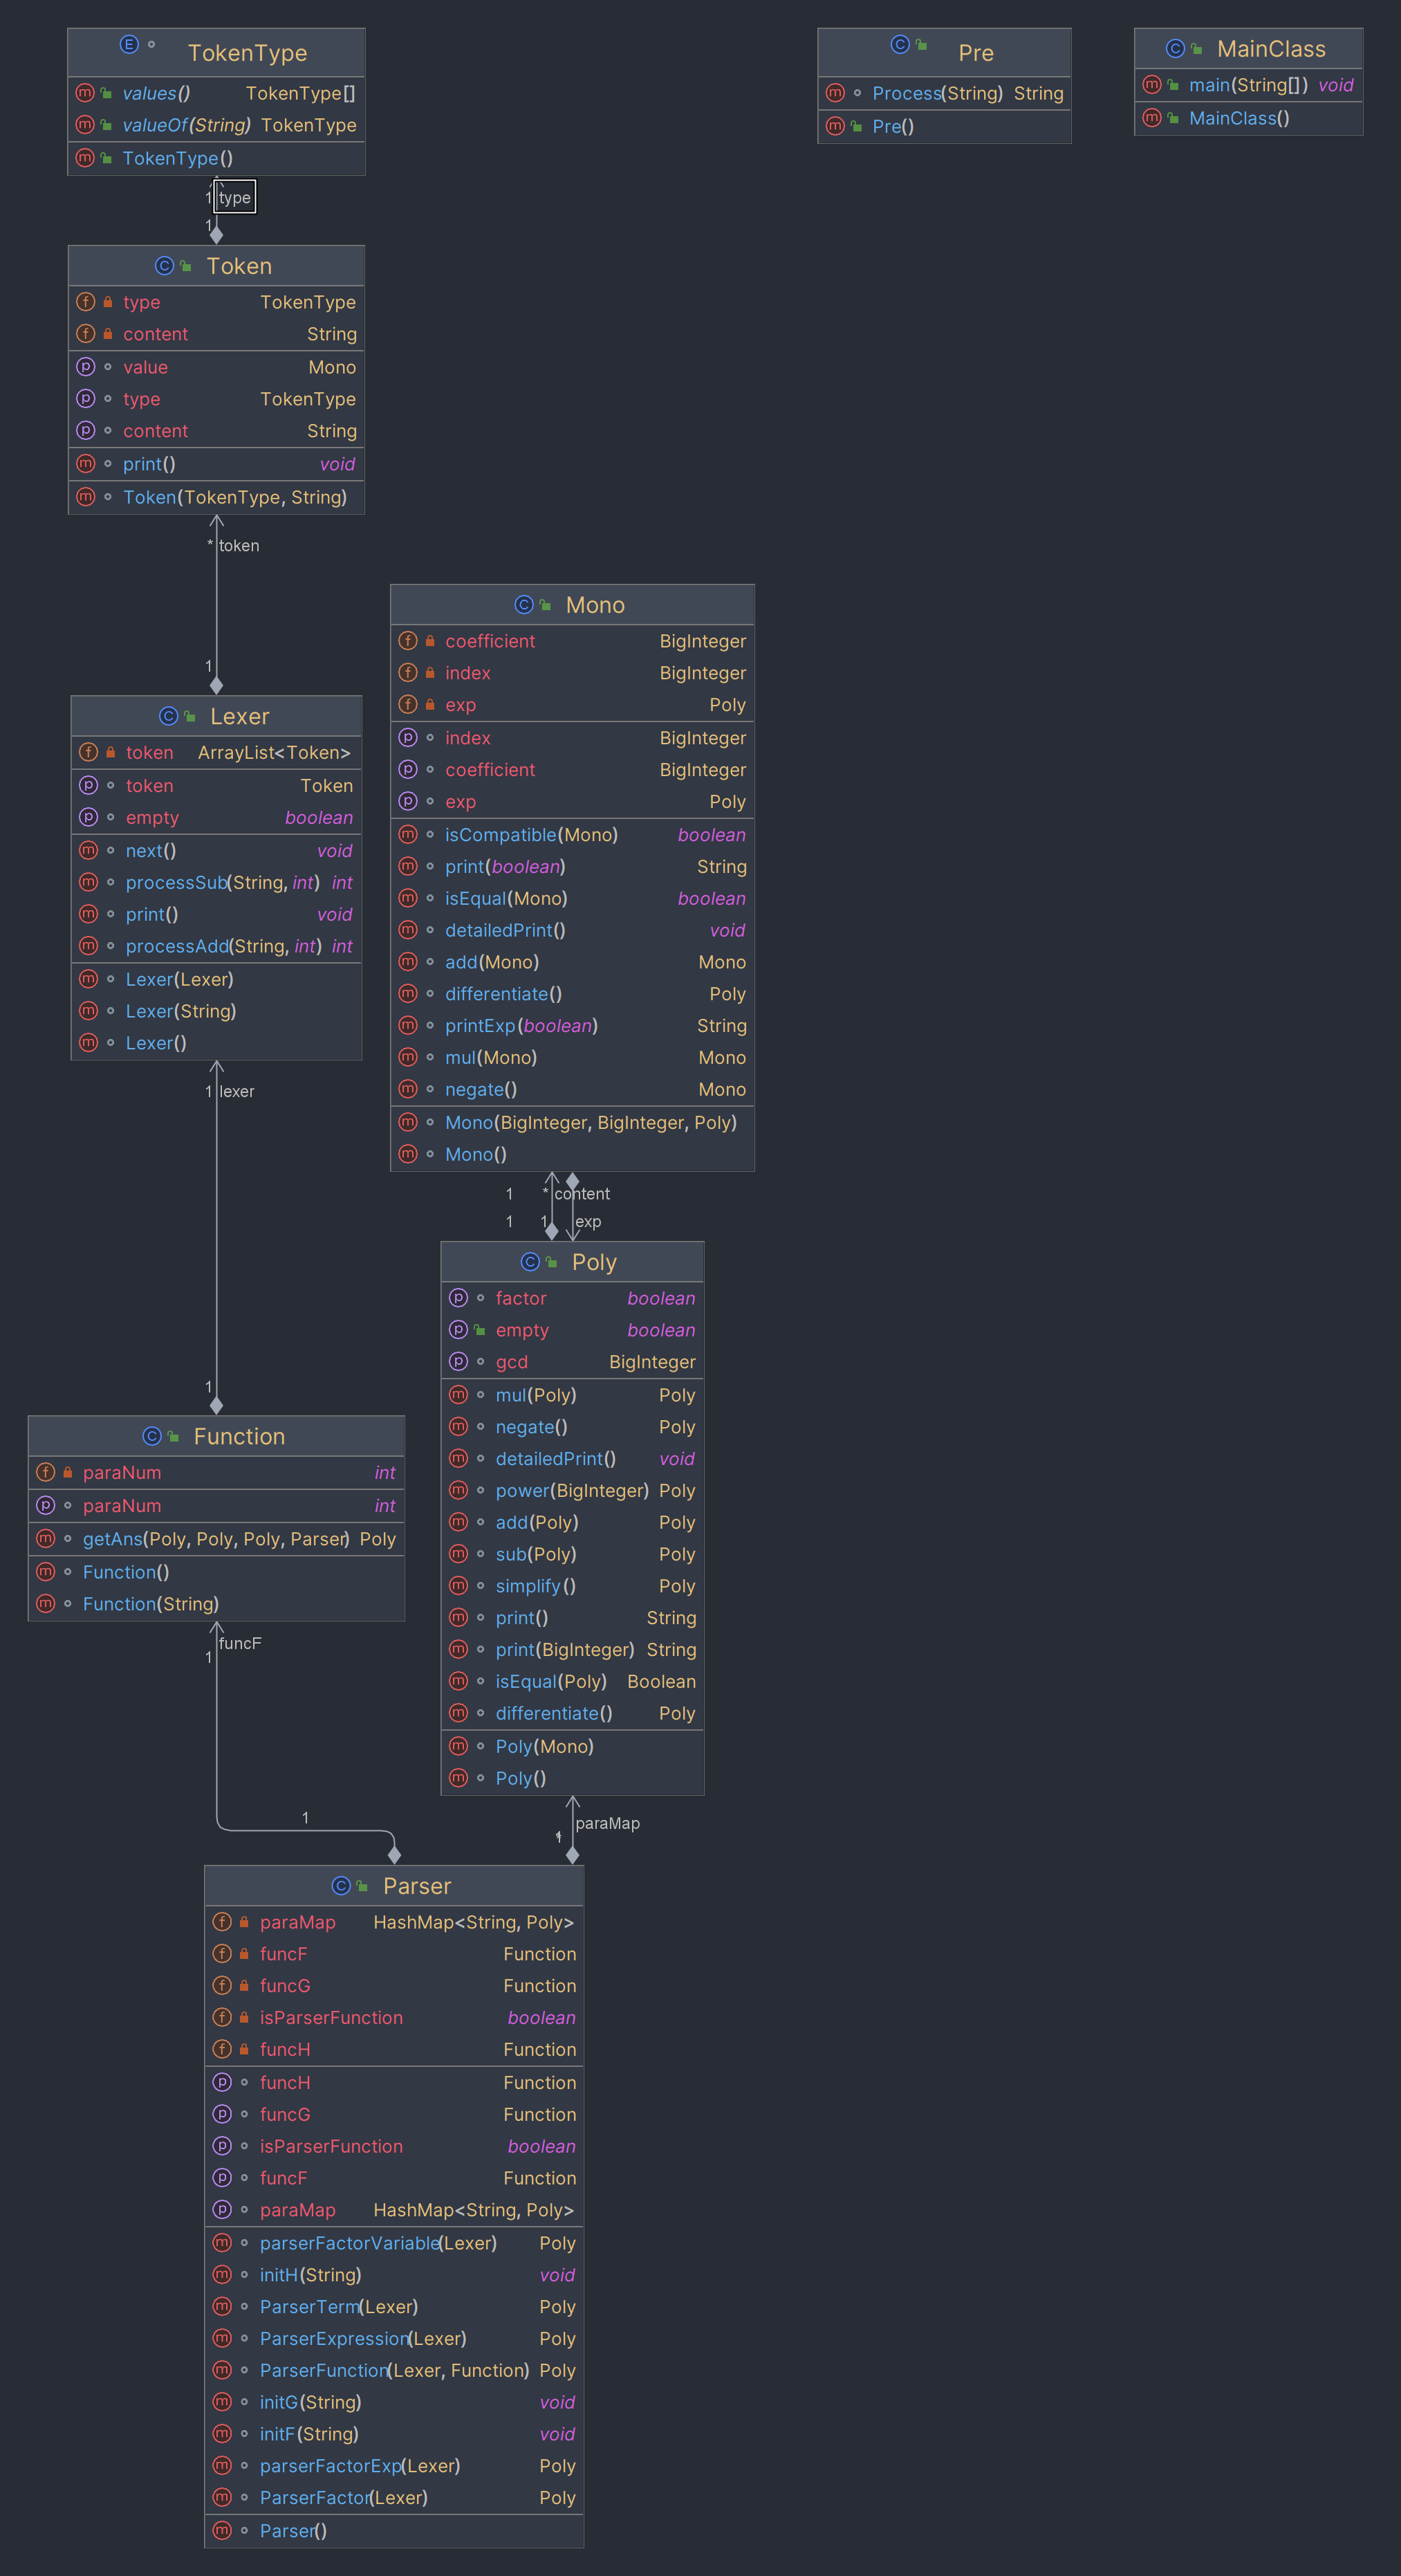
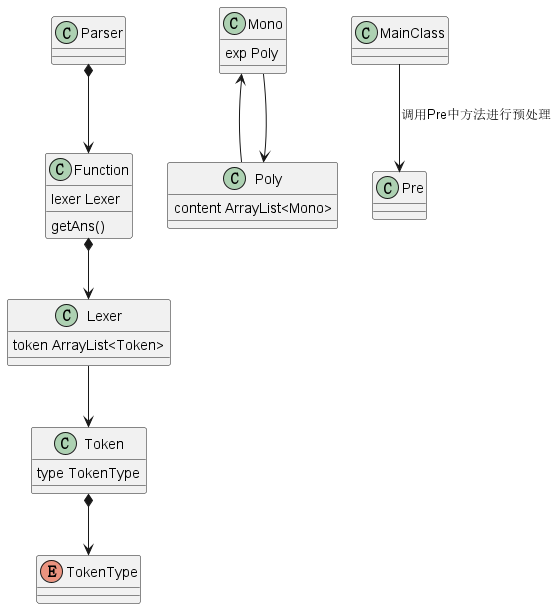
在我的设计中,项目被分成了三个部分:
第一部分为解析部分,采用了递归下降的策略,功能是对输入的表达式进行语法解析。这一部分很大程度上参考了hw_1的training,并在之后的迭代中进行了小规模重构以支持自定义函数解析。
第二部分为数据处理部分,主要是将已解析的token转化为可计算的数据,并实现了运算的方法。由于浅拷贝可能造成错误,因此这一部分的对象被设计为不可修改的,这样就在一定程度上解决了拷贝方式可能带来的问题。
第三部分主要由MainClass组成,负责输入输出和预处理。如果未来的迭代需要特殊的输入输出方式,可以为输入输出新建类。但由于三次作业中的输入输出相对简单,因此没有改变在main函数中实现输入输出的方式。
| Method | CogC | ev(G) | iv(G) | v(G) |
|---|---|---|---|---|
| Function.Function() | 0 | 1 | 1 | 1 |
| Function.Function(String) | 6 | 3 | 6 | 6 |
| Function.getAns(Poly, Poly, Poly, Parser) | 3 | 1 | 4 | 4 |
| Function.getParaNum() | 0 | 1 | 1 | 1 |
| Lexer.Lexer() | 0 | 1 | 1 | 1 |
| Lexer.Lexer(Lexer) | 0 | 1 | 1 | 1 |
| Lexer.Lexer(String) | 24 | 1 | 17 | 21 |
| Lexer.getToken() | 2 | 2 | 2 | 2 |
| Lexer.isEmpty() | 0 | 1 | 1 | 1 |
| Lexer.next() | 0 | 1 | 1 | 1 |
| Lexer.print() | 1 | 1 | 2 | 2 |
| Lexer.processAdd(String, int) | 6 | 1 | 4 | 5 |
| Lexer.processSub(String, int) | 6 | 1 | 4 | 5 |
| MainClass.main(String[]) | 5 | 1 | 5 | 5 |
| Mono.Mono() | 0 | 1 | 1 | 1 |
| Mono.Mono(BigInteger, BigInteger, Poly) | 0 | 1 | 1 | 1 |
| Mono.add(Mono) | 0 | 1 | 1 | 1 |
| Mono.detailedPrint() | 2 | 2 | 3 | 3 |
| Mono.differentiate() | 1 | 2 | 1 | 2 |
| Mono.getCoefficient() | 0 | 1 | 1 | 1 |
| Mono.getExp() | 0 | 1 | 1 | 1 |
| Mono.getIndex() | 0 | 1 | 1 | 1 |
| Mono.isCompatible(Mono) | 2 | 3 | 1 | 3 |
| Mono.isEqual(Mono) | 2 | 3 | 1 | 3 |
| Mono.mul(Mono) | 0 | 1 | 1 | 1 |
| Mono.negate() | 0 | 1 | 1 | 1 |
| Mono.print(boolean) | 15 | 2 | 5 | 12 |
| Mono.printExp(boolean) | 29 | 1 | 6 | 9 |
| Parser.Parser() | 0 | 1 | 1 | 1 |
| Parser.ParserExpression(Lexer) | 12 | 11 | 12 | 12 |
| Parser.ParserFactor(Lexer) | 23 | 8 | 12 | 14 |
| Parser.ParserFunction(Lexer, Function) | 3 | 1 | 4 | 4 |
| Parser.ParserTerm(Lexer) | 13 | 12 | 13 | 13 |
| Parser.getFuncF() | 0 | 1 | 1 | 1 |
| Parser.getFuncG() | 0 | 1 | 1 | 1 |
| Parser.getFuncH() | 0 | 1 | 1 | 1 |
| Parser.getParaMap() | 0 | 1 | 1 | 1 |
| Parser.initF(String) | 0 | 1 | 1 | 1 |
| Parser.initG(String) | 0 | 1 | 1 | 1 |
| Parser.initH(String) | 0 | 1 | 1 | 1 |
| Parser.parserFactorExp(Lexer) | 6 | 1 | 5 | 5 |
| Parser.parserFactorVariable(Lexer) | 5 | 1 | 4 | 4 |
| Parser.setFuncF(Function) | 0 | 1 | 1 | 1 |
| Parser.setFuncG(Function) | 0 | 1 | 1 | 1 |
| Parser.setFuncH(Function) | 0 | 1 | 1 | 1 |
| Parser.setParserFunction(boolean) | 0 | 1 | 1 | 1 |
| Poly.Poly() | 0 | 1 | 1 | 1 |
| Poly.Poly(Mono) | 0 | 1 | 1 | 1 |
| Poly.add(Poly) | 0 | 1 | 1 | 1 |
| Poly.detailedPrint() | 1 | 1 | 2 | 2 |
| Poly.differentiate() | 1 | 1 | 2 | 2 |
| Poly.getGcd() | 4 | 4 | 2 | 4 |
| Poly.isEmpty() | 3 | 3 | 2 | 4 |
| Poly.isEqual(Poly) | 9 | 6 | 4 | 6 |
| Poly.isFactor() | 7 | 5 | 4 | 8 |
| Poly.mul(Poly) | 3 | 1 | 3 | 3 |
| Poly.negate() | 1 | 1 | 2 | 2 |
| Poly.power(BigInteger) | 2 | 2 | 2 | 3 |
| Poly.print() | 6 | 4 | 5 | 6 |
| Poly.print(BigInteger) | 6 | 4 | 5 | 6 |
| Poly.simplify() | 14 | 5 | 6 | 7 |
| Poly.sub(Poly) | 0 | 1 | 1 | 1 |
| Pre.Process(String) | 10 | 1 | 9 | 9 |
| Token.Token(TokenType, String) | 0 | 1 | 1 | 1 |
| Token.getContent() | 0 | 1 | 1 | 1 |
| Token.getType() | 0 | 1 | 1 | 1 |
| Token.getValue() | 3 | 3 | 3 | 3 |
| Token.print() | 0 | 1 | 1 | 1 |
| Class | OCavg | OCmax | WMC | |
|---|---|---|---|---|
| Function | 3 | 6 | 12 | |
| Lexer | 3.56 | 18 | 32 | |
| MainClass | 5 | 5 | 5 | |
| Mono | 2.79 | 11 | 39 | |
| Parser | 3.56 | 14 | 64 | |
| Poly | 3.31 | 7 | 53 | |
| Pre | 6 | 6 | 6 | |
| Token | 1.4 | 3 | 7 | |
| TokenType | n/a | n/a | 0 |
一些方法的复杂度明显偏高。以Lexer.Lexer(String)方法为例,这个方法的结构大概是这样:
    Lexer(String str) {
        // ...
        while (pos < str.length()) {
            char charNow = str.charAt(pos);
            if (charNow == '+') {
                // ...
            } else if (charNow == '-') {
                // ...
            } else if (charNow == '*') {
                // ...
            } else if (charNow == '(') {
                // ...
            } else if (charNow == ')') {
                // ...
            }
            // ...
            else if (charNow == ')') {
                // ...
            }
        }
    }
实际上,其他的复杂度较高的方法,比如Parser.ParserExpression(Lexer)、Parser.ParserFactor(Lexer)、Parser.ParserFunction(Lexer, Function)、Parser.ParserTerm(Lexer),大都也有大面积的if判断。事实上,可以通过多态等更OO的方式解决这个问题。因此,在以后的作业中,我应该用更OO的方式设计程序。
第一次作业的要求相对简单,但一个好的架构可以显著地降低之后迭代的工作量。因此,在第一次作业中,我一共进行了两次重构(因此有三个版本)。
第一版:采用了递归下降的思想进行解析,并使用正则表达式进行判断。但是,这一版的递归下降相对简陋,比如没有实现Lexer而是直接对字符串解析。由于解析过程写的比较随意,结果第一版的程序在解析+++1之类的数据时遇到困难。我认识到了按照构造规则进行解析的重要性(方便迭代时新规则的加入),因此有了第二版。
第二版:使用搜索的策略,严格按照构造规则解析。指导书中有规定"带符号整数内不允许包含空白字符,注意符号与整数之间也不允许包含空白字符",这让我意识到空白符也许并不是完全没有意义的(比如,+1的'+'可以解释为表达式前的符号、项前的符号、带符号的整数的符号,但是+ 1的'+'就不能解释为带符号的整数的符号)。因此,我写了搜索去寻找输入表达式的一种可能的解释。但是后来发现搜索算法的时间复杂度过高,在浏览讨论区的删空白符和消符号的优化后后,我认识到任何一个合理的解析都是正确的,并且直接解析总是可以得到一个合理的解析,于是有了第三版。
第三版:采用了较为完整的递归下降。在认真学习了training的代码后,我认识到递归下降的方法本身就有良好的可扩展性,于是在重构时,我较为完整的实现了递归下降。
这一次作业要求加入自定义函数与exp函数。得益于递归下降,自定义函数的加入并不复杂。在自定义函数的实现方法上,由于函数表达式与最终表达式的构造规则较为接近,因而我没有采用字符串替换,而是对原有的词法解析进行扩展使其能支持表达式解析。这样可以从一定程度上避免引入新符号所带来的问题。但是由于在hw_1中我使用HashMap存储数据,为了避免HashMap嵌套带来的复杂度,我将数据部分重构为采用ArrayList表示数据。括号嵌套已经在上一次作业中实现,基本没有修改。
这一次作业要求加入求导。其实求导可以看做一种的运算,因此直接在原有的方法上进行了扩展。函数嵌套已经在上一次作业中实现,基本没有修改。
第一次作业中实现了基本的的输出优化(先输出正系数项,系数指数为一时省略等)。
第二次作业在第一次作业的基础上加入了简单的gcd优化(在输出exp时提取exp表达式的gcd,并选取提取gcd输出与原样输出中更短的作为输出结果)。
在三次作业中,我都搭建了简易的评测机,但还是出现了一些bug:
这些bug反映出我测试方式的缺陷。实际上,这些bug正中我评测机的盲区。
事实上,在互测时,基于随机数据生成器发现bug的可能性比较小(毕竟同房的代码已经经过了强测的检验)。反而通过枚举一些极端的数据可能发现bug。
良好的架构非常重要。在设计架构时应该有一定的前瞻性。比如我在hw_1的时候就实现了括号嵌套,在hw_2的时候就实现了函数嵌套,这让之后的迭代过程变得不那么复杂。相应的,由于我在hw_1的时候使用HashMap存储数据,扩展较为困难,导致在hw_2时进行了较大规模的重构。
由于上学期没有参加OOP,我在hw_1设计架构的时候采取的很多方式并不是十分OO。在hw_2与hw_3迭代时由于之前的设计具有一定的扩展性,因此对许多内容并没有做大的改变。结果是在hw_3完成后,我的程序不OO的地方有很多(比如大量的if判断,没有使用继承等OO特性)。这导致我程序的复杂度较高,也为bug的出现埋下了隐患(hw_3的bug出现在了一个复杂度较高的方法中)。在之后的作业中,我应该更多的采用OO的方式解决问题。
此外,在做测试的时候应该更加谨慎,不能迷信评测机。应该让评测机支持更全面的测试,并且采取多种不同的测试手段(比如阅读代码)。


