


301
社区成员
 发帖
 与我相关
 我的任务

 分享
首先从网上摘出他们的定义:
黑箱测试也称功能测试、数据驱动测试或基于规格说明的测试。测试者只知道程序的输入、输出和系统的功能,这是从使用者的角度针对软件的接口、功能及外部结构进行的测试,不考虑程序内部实现逻辑。

白箱测试也称结构测试、逻辑驱动测试或基于程序本身的测试,测试程序内部结构或运行。在白箱测试时,从程序设计语言的角度来设计测试样例。测试者输入数据并验证数据在程序中的流动路径,并确定适当的输出,类似测试电路中的节点。
我预想中的两种测试方法并不是完全分割开的:
先使用白箱测试,对每个新编写的方法进行小规模、基础中的基础的功能测试。

等大部分或者所有方法均编写完毕之后,进行规模从小到大的黑箱测试,较广范围地覆盖编写的代码,从广度上检验代码的正确性。

如果上一步黑箱测试检测出了bug,就对大规模的测试样例进行精简,直到确定一个最小限度能引发bug的测试样例,采用白箱测试的检测方法进行bug在代码之中的定位并进行修正。

在大范围的正确性检验通过之后,就需要对一些时间或者空间运行压力较大的方法进行压力测试,编造一些合理且强度较大的针对方法构造的样例点,根据定义来说,这应当也属于白箱测试的一种。
针对这几个概念的定义与理解:
单元测试: 在这个阶段,软件的每个组件或模块都会被单独测试,以确保每个单独的部分都能正常工作。
实际上,课程组要求的Junit的编写就属于一种单元测试。
功能测试: 功能测试是对代码的某些功能进行测试,以确保它们按照规格或需求进行工作。
我们的测试样例需要对代码的绝大部分功能进行覆盖测试,保证代码的基本功能不存在差错。
集成测试: 集成测试是在所有模块单独测试之后进行的,目的是发现模块间的结合问题。
集成测试的目标是确定组件(即单元)能够正确地集成并在一起工作,实际上,对于实现了规格的方法,这种测试一般是相对容易进行的。
压力测试: 压力测试是一种性能测试,用于确定系统在负载特别高的情况下的行为。
对程序的压力测试可以通过一些极端值或大量的指令进行,如果在极端情况下程序的性能(如程序总运行时间、内存占用率、CPU使用时间)仍旧能够保持在可接受范围之内,那我们有理由认为非极端情况下程序只会表现得更好。
回归测试: 回归测试是在修改了软件的一部分或全部后进行的,以确保修改没有引入新的错误,也没有影响到原有的功能。
回归测试保证不会出现拆东墙补西墙的情况发生,即修改或优化之后的程序仍旧需要接受修改优化前程序的所有测试,如果能够在部分或全部测试点所表现的都更好,那么才可以认为通过了回归测试。
以上是我预想的检测代码正确性与性能的一个大致流程,而我也在我的代码编写过程之中通过特殊的数据构造实施了这样的测试流程:
在每次作业之中,我都首先对程序的基本功能进行了简单的测试,保证非极端情况下不会出现非期望输出。

对于压力测试,我集中于一些时间复杂度较高的方法进行测试,一般出现多重循环或递归方法时间复杂度较高,因此我接着根据所实现的方法构造压力测试样例点:

    在第一次作业之中,我对用来维护图连通性查询的DFS算法进行了测试,具体方法为添加了强测范围允许的最大人数,对每个人都添加了关系,并使用modifyRelation方法反复移除关系,我的程序之中会在进行modifyRelation方法运行之中合适时机进行DFS来维护图连通性,因此通过这种方法就可以对DFS进行压力测试。

    在第二次作业之中,我对用来查询两个节点之间最短路径的方法queryShortestPath进行压力测试,这个方法之中包含计算最短路径的BFS算法,我同样构造了强测允许的最大人数,同时考虑到BFS算法较差的表现出现在人与人之间的关系为一条链的情况,我将所有人链成一条,使用最大允许数量的指令进行压力测试。
本单元要求的是构建一个带权无向图,用于保存一个人际关系网,我的大致结构如下(省略结构相似的一些社交消息类和异常类):
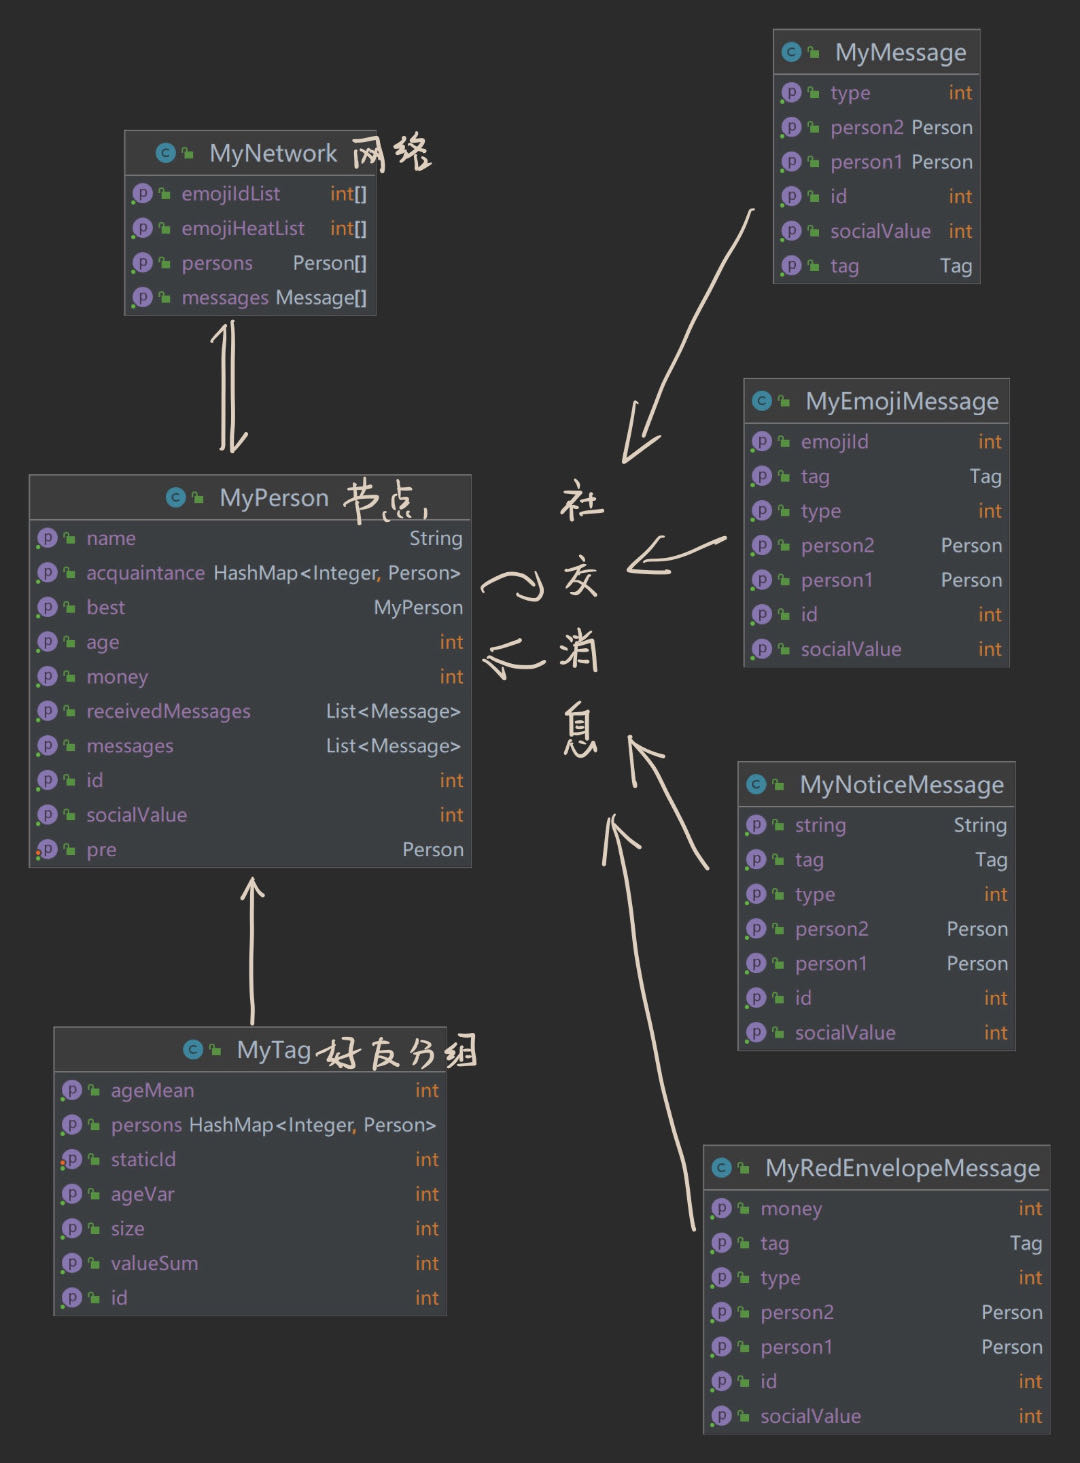
MyNetwork
这是无向图最大的载体,对其一些属性和方法进行分析:
| 属性 | 数据结构 | 作用 |
|---|---|---|
| persons | HashMap<Integer, Person> | 保存了社交网络之中的所有节点,以其id作为key |
| tagMap | HashMap<Integer, MyTag> | 保存了所有人的所有Tag,并以其全局id作为key |
| messages | HashMap<Integer, Message> | 保存了所有未发出的信息,并以其id作为key |
| emojiIdList | HashSet | 保存了合法的表情id |
| emojiHeatList | HashMap<Integer, Integer> | 保存了表情的热度,以其id作为key |
| patitions | Integer | 保存了无向图的连通分区数 |
| tripleSum | Integer | 保存了三元组的总数 |
MyPerson
这是网络的节点类:
| 属性 | 数据结构 | 作用 |
|---|---|---|
| id | Integer | 一个节点的唯一标识 |
| name | String | |
| age | Integer | |
| acquaintance | HashMap<Integer, Person> | 保存此节点的邻接矩阵 |
| value | HashMap<Integer, Integer> | 保存边的权值 |
| tags | HashMap<Integer, Tag> | 保存此节点的好友分组 |
| pre | Person | 此节点的领导 |
| best | MyPerson | 此节点的最好朋友 |
| money | Integer | |
| socialValue | Integer | |
| messages | LinkedList | 此节点收到的消息 |
MyTag
这是好友分组类:
| 属性 | 数据结构 | 作用 |
|---|---|---|
| staticId | Integer | 全局id |
| id | Integer | 相对于person的id |
| persons | HashMap<Integer, Person> | 好友分组之中包含的person |
| ageSum | Integer | age总和 |
| valueSum | Integer |
MyMessage
这是person之间的社交信息类:
| 属性 | 数据结构 | 作用 |
|---|---|---|
| id | Integer | 消息的唯一标识符 |
| socialValue | Integer | |
| type | Integer | 消息为单发消息还是群发消息 |
| person1 | Person | 发送人 |
| person2 | Person | 接收人 |
| tag | Tag | 接受好友分组 |
省略去较简单的操作,接下来是一些相对复杂的查询操作的优化:
public boolean isCircle(int id1, int id2)
用途:该方法根据给出的两个节点id,返回这两个节点是否连通
具体实现:使用并查集,即对于一个连通分区,选出一个人作为领导pre:
每进行一次节点A与节点B之间的addRelation操作,就要将两个节点的pre合并,以标志这两个人属于一个连通分区

每进行一次节点A与节点B之间的modifyRelation操作,就要判断这两个节点是否切断关系,如果切断了关系,就要以其中一个节点A为出发点进行DFS并将可达节点的pre设置为节点A,判断节点A所在连通分区是否还包含节点B,如果仍包含则不进行操作,如不包含,则需要再以节点B为出发点进行DFS并将可达节点的pre设置为B,重新维护并查集的查找操作
这样,在查询两个节点是否连通操作时,只需要查看两个节点是否拥有相同的pre即可
时间复杂度: O(1)
public int queryBlockSum()
用途:该方法返回整个网络的连通分区数
具体实现:连通分区数实际上等价于整个网络之中的pre数量,因此我们只需要在并查集维护过程中留心什么情况会引起pre数量改变。
实际上,pre数量增加由addPerson和removeRelation引起,pre数量减少由addRelation引起,因此只需要在这几处维护全局变量partitions,最后返回此全局变量即可
时间复杂度: O(1)
public int queryTripleSum()
用途:该方法返回整个网络中三元组数
具体实现:由于静态查找时间复杂度达到O(persons^3),因此不得不使用动态维护。我们仍旧只需要关心什么时候会引起三元组数变化。
在addRelation(removeRelation)之中,对于节点A和B,如果他们有相同的熟人,在进行完相应操作之后就会增加(减少)一个三元组数,因此我们只需要在这两个操作之中对全局变量tripleSum进行维护,最后返回此全局变量即可
时间复杂度: O(1)
public int queryTagValueSum(int personId, int tagId)
用途:该方法根据personId和tagId找到相应的tag,返回这个tag之中所有存在好友关系节点的社交价值的总和(* 2)
具体实现:此方法静态计算也需要O(persons^2)的复杂度,使用动态维护更加节省时间开支,同样的思考方式,什么地方会引起tag之中的valueSum变化?
同样是addRelation和modifyRelation之中,对于节点A和B,我采用遍历全局所有的Tag的方法,判断这两个节点是否同时在一个tag之中,如果存在于同一个tag,则需要对这个tag的valueSum进行修改
时间复杂度: O(1)
public int queryCoupleSum()
用途:该方法返回网络之中互相为最好朋友的二人组的数量(* 2)
具体实现:可以将某节点的最好朋友best交由其自己保管,这样进行静态查询的情况下也只需要O(persons)的时间复杂度,是我们可以接受的
对节点A和B的addRelation和modifyRelation,需要判断节点A和B的best是否因此而改变,在这两个方法处维护best。在查询时,只需要遍历全局的persons,获得其best(如果有的话),判断其best的best是否为自身即可
时间复杂度: O(persons)
public int queryShortestPath(int id1, int id2)
用途:该方法返回节点id1和节点id2之间的最短路径
具体实现:通过BFS实现静态查找,此方法时间复杂度为O(persons + links),由于课程组的数据范围约定,考虑到到达最差时间复杂度的情况下运行速度仍旧可以接受,实现静态查找既稳定又快捷
时间复杂度: O(persons + links)
规格的规定仅仅方便规格本身的描述,并不考虑时间复杂度和空间复杂度,这样做实际上是提供了一个抽象层,隐藏具体细节,使程序员更加关注问题本质,使规格拥有通用性、可重用性和可移植性。
而具体的数据结构的实现需要根据时间和空间的要求进行规划,一些常见的替换如数组转变为HashMap,HashSet等,同时还要对规格之中嵌套层数过多的循环进行简化。
如对于查询和修改person最近的消息,由于其频繁地增加和查询list的前几个元素,而不关心后面的元素,可以使用链表类型进行存储。

而对于一些全局查询的方法,我们需要根据其查询方式的时间复杂度进行考量,是否需要动态维护,对允许静态查询即时间复杂度较低的方法,可以使用HashMap或HashSet,对时间复杂度过高不允许静态查询的方法,则需要额外在其他方法之中进行状态的维护.
本单元的性能问题出现在第一次作业的DFS算法之中,存储已经查找过的节点使用了ArrayList容器,查找速度十分缓慢,尤其是对于递归算法,修改为HashSet之后速度提升十分明显。
Junit测试主要分为两个部分,数据生成和规格检查
Junit目标主要是为了检查可能存在错误的单元代码(一般是一个方法),而错误的类型往往是不可知的,因此数据的构造不可能保证对所有错误代码都能保证检查出错误,这就需要测试数据具有极大的覆盖性。
我的数据生成策略采用随机数策略,旨在覆盖全连接和全空网络,稠密网络和稀疏网络,确保对大多数错误情况都可以通过断言测试出来。
Junit和规格天生一体,只需要对规格中的每个invariant和ensures编写相应的断言进行确认即可
针对这个单元,唯一需要注意的地方就是,应当使用两个网络,一个进行待检测操作,一个不进行待检测操作,再对这两个网络中的对象进行比较,才能够检测对象的相关属性。
本单元的难度相对于前两个单元较低,旨在以图论及一些算法为背景,引导我们jml入门,通过规格化设计学习程序设计构造的契约精神。
希望将来可以添加一些关于jml书写和junit测试相关的指导!


